
 THUsatlab
文章来源于THUsatlab,作者聂玉婷
01 语种识别
语种识别(图片来自第五届东方语种识别竞赛)
02 BERT-LID
BERT的全称是:Bidirectional Encoder Representation from Transformers。该模型通过大规模无标注文本语料训练,获得包含丰富语义信息的表征,BERT具有强大的语义理解能力,是近年来自然语言处理领域公认的里程碑模型。
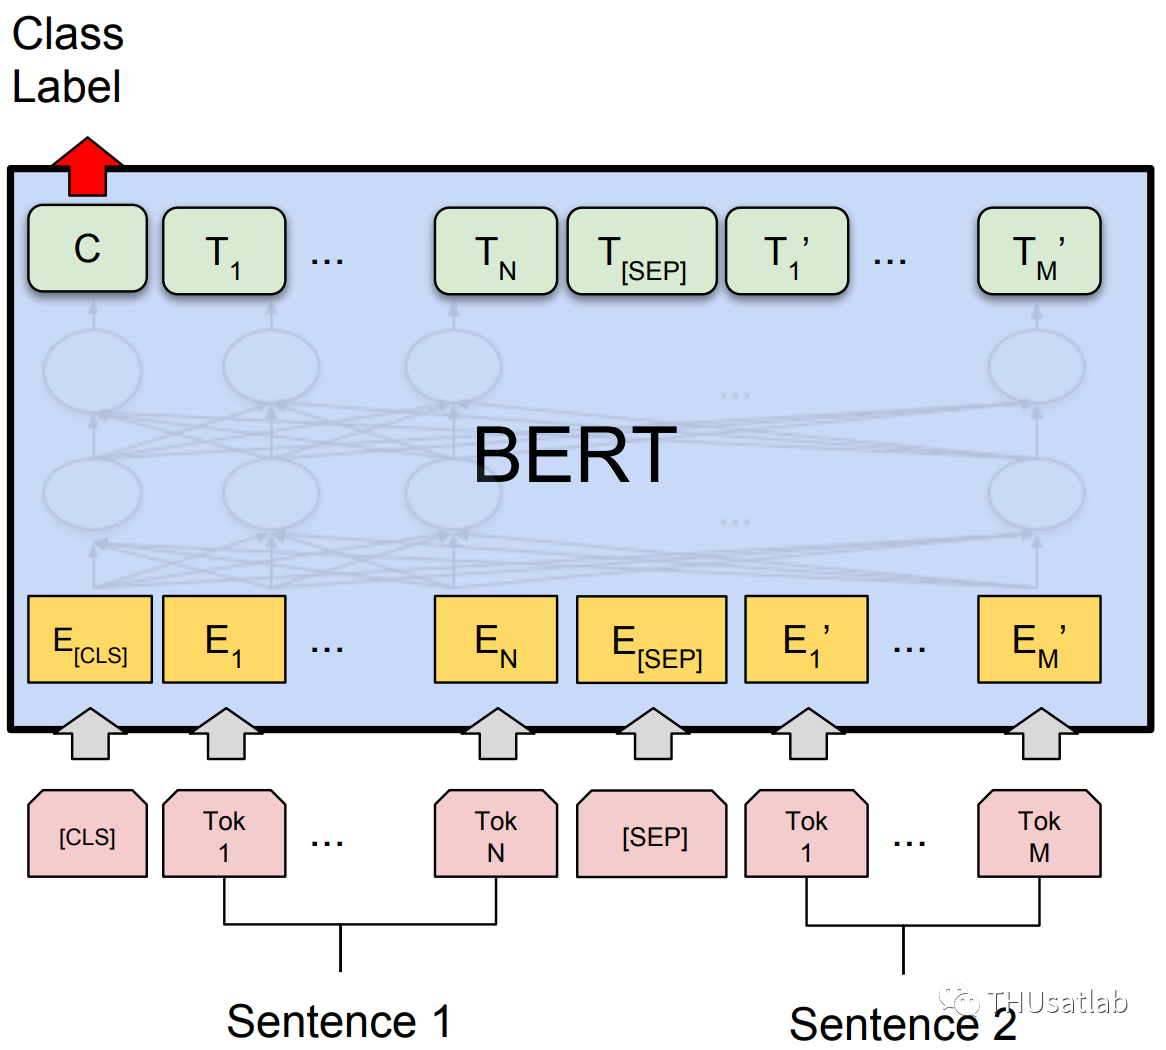
原始的BERT旨在处理基于文本的表示,而我们这里的输入是语音,因此需要对输入语音进行预处理以适应该模型。
方法一:提取语音的音素,作为BERT模型的输入。
方法二:提取语音的后验概率特征,替换原始的Token Embedding结果,作为输入。
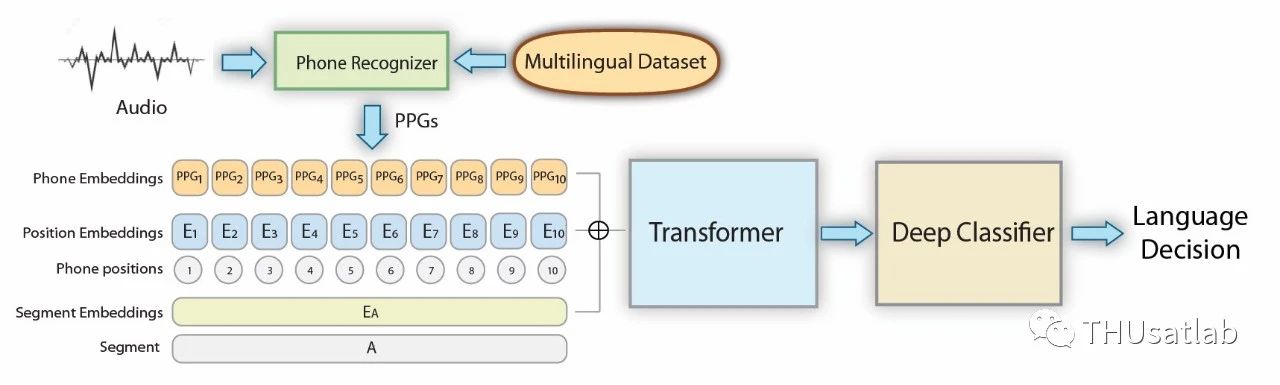 将调整过后的BERT接不同的分类网络模型进行学习
03 实验及结论
我们使用OLR20、TAL_ASR、TIMIT和THCHS30数据集来对BERT模型进行训练。对于音频数据我们使用BUT的开源代码来获得音素序列以及音素后验概率特征。
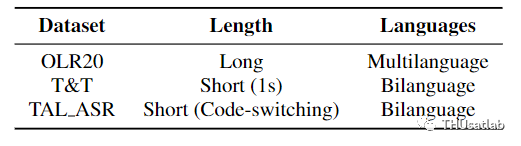
其中OLR20来自于2020年东方语种识别竞赛所提供的数据,包含6个语种;TAL_ASR为好未来英语课授课音频,每条音频只有一位说话人,包含中英文混合讲话的情况(对于这种情况,我们使用强制对齐的方法来获得中文与英文的标签信息);TIMIT为英文数据集;THCHS30为中文数据集。同时我们还对数据进行切分处理来获得时长为1s的短语音数据。数据集的具体情况如下图所示,其中T&T为TIMIT和THCHS30的切分短语音混合使用的情况。
下游神经网络模块,我们选择使用CNN、LSTM、RCNN、DPCNN分别进行实验。首先我们在OLR20和T&T数据上对BERT-LID模型进行测试,然后进行消融实验:a)BERT部分结合线性分类层来得到结果(称之为BERT);b)去掉BERT模块(称之为LID),直接将数据输入到对应的模型中来得到结果。可以看出,相比于BERT以及LID模块,BERT-LID模型在语种识别任务中准确率整体上有所提升。
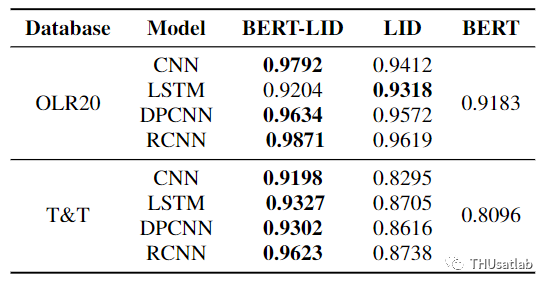
在OLR20和T&T数据集上进行消融实验
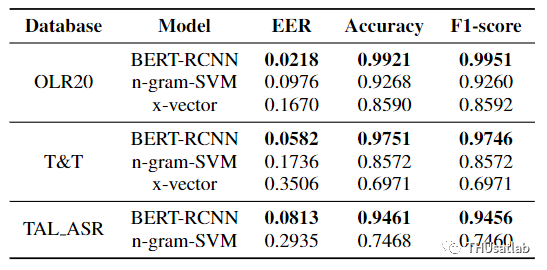
在不同的数据集上进行对比试验
我们的方法将BERT引入到语种识别领域,通过调整输入将语音数据顺利的输入BERT模型,再结合不同的神经网络来搭建BERT-LID系统。结果表明,所提出的BERT-LID系统提高了语种识别性能,尤其是在短语音上提升更为明显。
