
 THUsatlab
在本文中,我们介绍了 SpeechColab Leaderboard,这是一个为 ASR 评测而设计的通用开源平台。通过该平台:
我们报告了一系列基准测试,揭示了当前最先进的ASR系统的性能,其中涵盖了各种开源模型和商业服务。
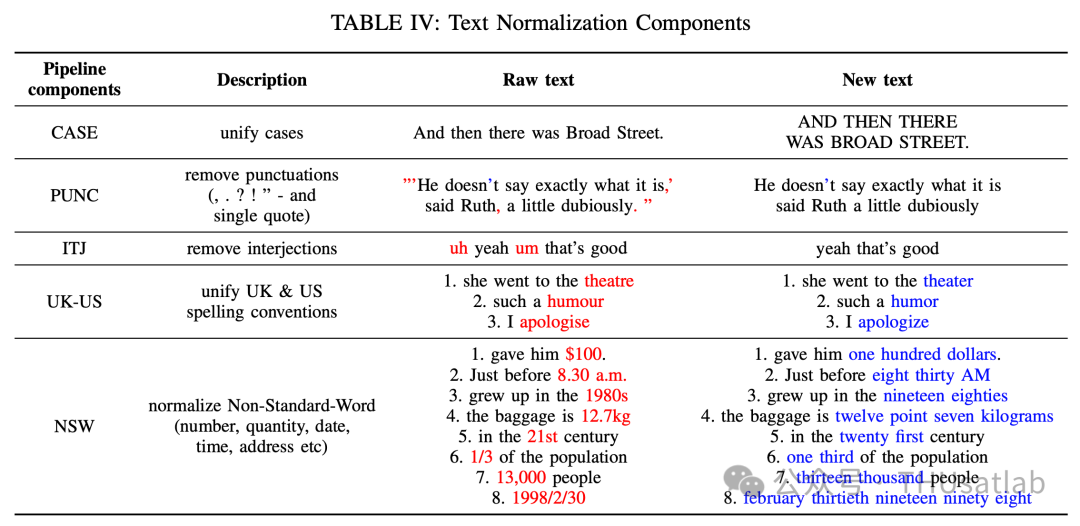
我们量化研究了测试流程中的一些处理细节会如何影响最终的测试结果。这些细微差别包括大小写、标点符号、插入语、缩略语、拼写变种、复合词的处理等。
我们从Kolmogorov Complexity(柯尔莫哥洛夫复杂度)和Normalized Information Distance(NID)概念中汲取灵感,对传统的字/词级Token错误率(这里统称为 Token Error Rate TER)进行了改进,并称之为Modified Token Error Rate (mTER),该指标实现了适当的数值归一化,且相对reference和hypothesis具有对称性,是一种数学上更严谨优雅的测度。
一、文本处理流程
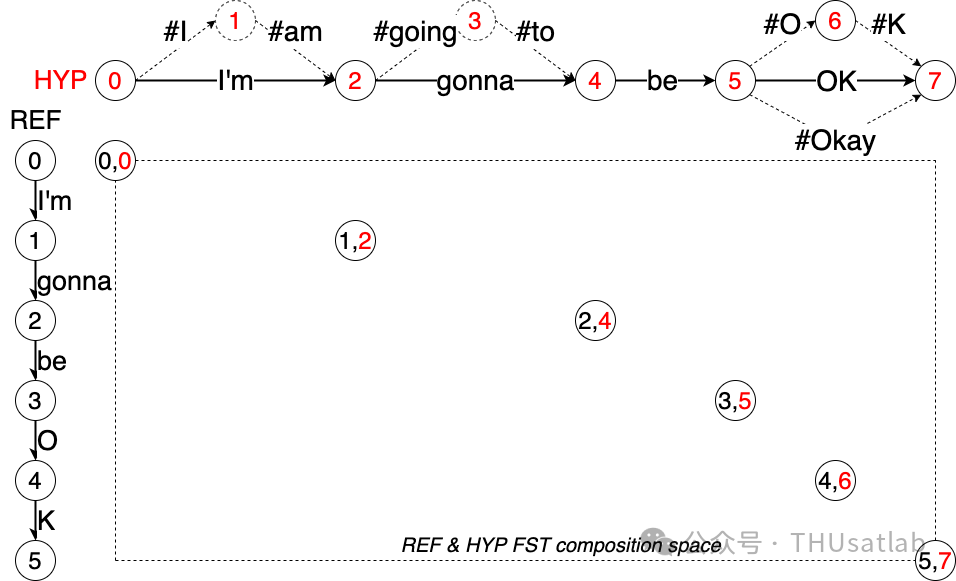
我们保持Ref的原始形式不变,而扩展后的 Hyp 则包含各种可能的变形(如上图中的虚线扩展部分所示)。这样一来,无论Ref中出现的人工标注为哪种具体形式,Hyp都能与之正确匹配。采用该方法而不是在文本规范化阶段直接处理,有两个原因:首先,从各种等价的形式中选取某一个具体的形式作为“官方”结果是有争议的,作为平台开发者,我们更倾向于提供一种灵活的机制,而不是制定一些武断的文本规范化策略。其次,该算法仅针对Hyp进行扩展,而始终尊重人类标注的原始形式(即Ref),在统计错误率时,分母的数值保持稳定,不会随DAE模块中的规则演变而发生改变。
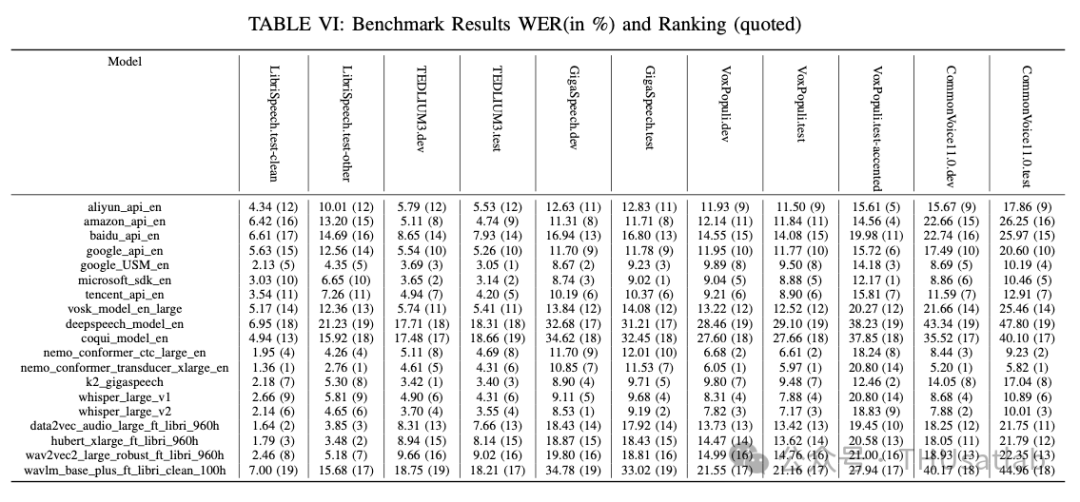
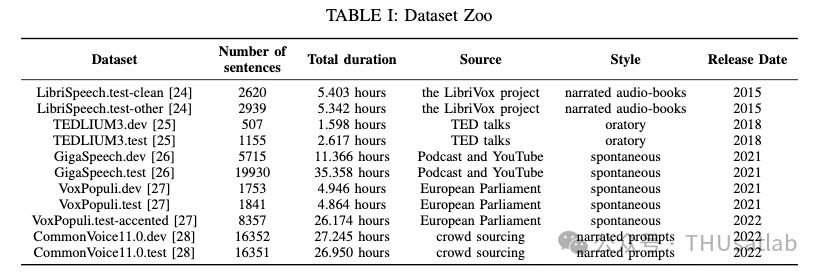
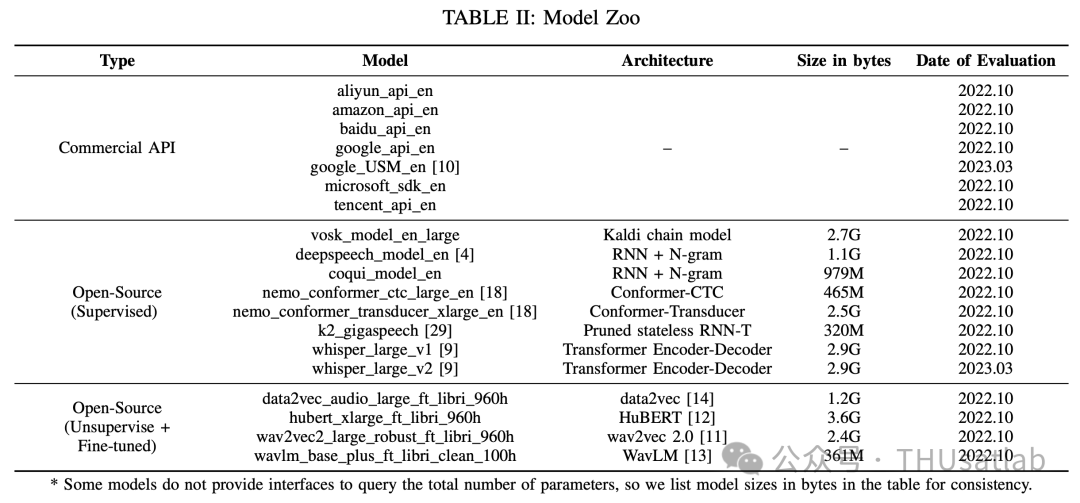
近十年来,语音识别技术发展迅速:OpenAI-Whisper模型与2014年的SOTA模型DeepSpeech相比,有了显著的WER降低:在 LibriSpeech 测试中,WER降低了78%;在TedLium3测试中,WER降低了81%;在GigaSpeech测试中,WER降低了71%;在VoxPopuli测试中,WER降低了75%;在VoxPopuli-accented测试中,WER降低了50%;在CommonVoice测试中,WER降低了79%。这些数字反映了语音识别技术在过去十年中取得的整体进步。
三、各个处理组件对结果的影响
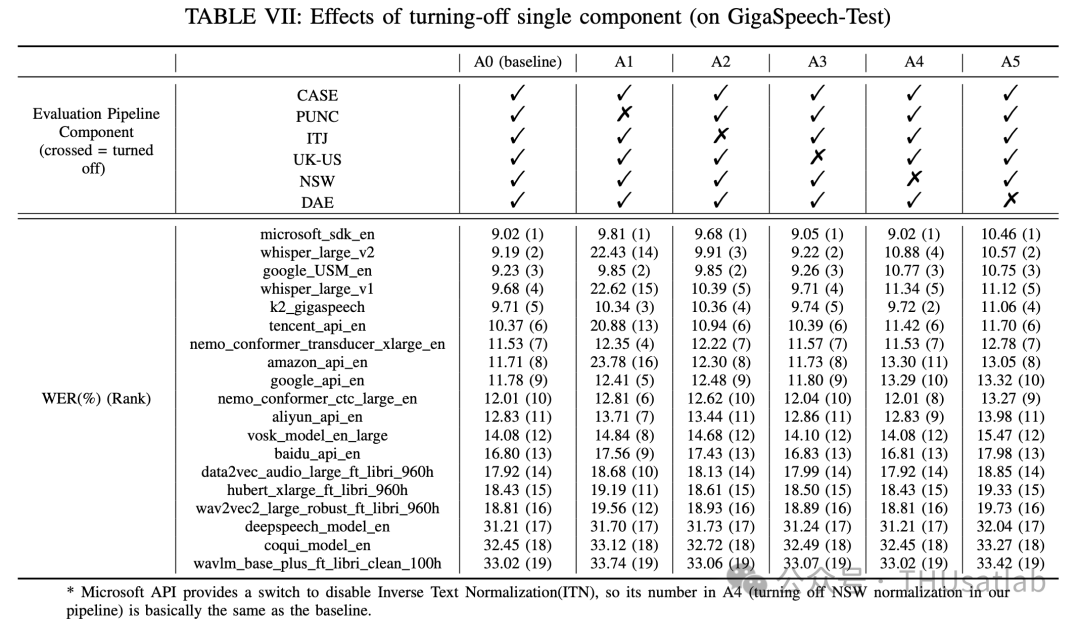
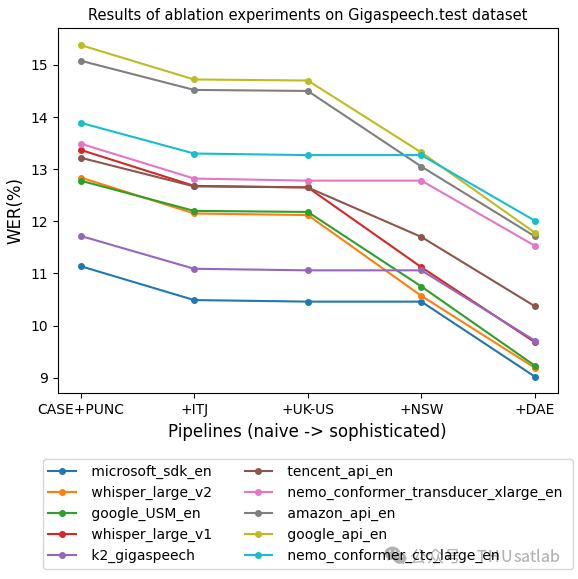
在上图中,我们展示了上述各个因素是如何一步步叠加在一起的。从图中可以看出:i) 从最左侧(基于简单的测试处理流程)改进到最右侧(基于相对完善的测试处理流程),各个系统的性能排名可能发生改变。ii) 复杂的流程比原始流程相对减少20%-30%的 WER。这些结果提出了一个令人担忧的启示,即系统的优劣和技术进步很容易被评测流程的实现细节所掩盖。因此,当讨论多个系统的错误率和排名时,应有意识地将所使用的具体工具包和流程纳入讨论范围,以避免造成误导。
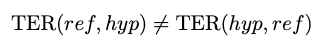
这在实践中有广泛的影响:工具需要实现非对称接口,对应的文档也需要格外强调插入(INS)与删除(DEL)的相对性。
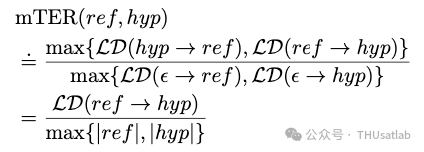
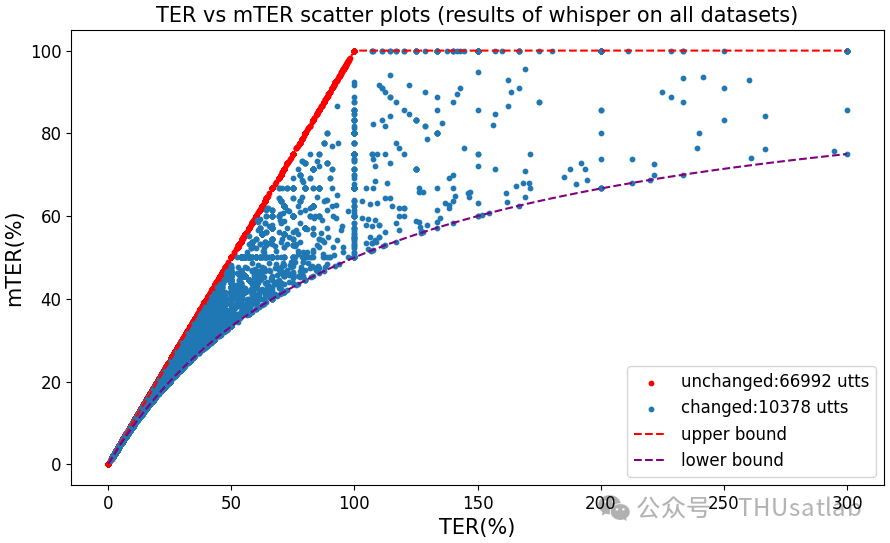
上图展示了whisper_large_v1模型测试中句子级的mTER与TER的对比。红色对角线上的样本代表mTER与TER完全一致的语句,占样本总数的 87%。其余13%的样本展示了 mTER 和 TER 的差异,以及 mTER 如何将 TER 数值溢出(即 TER > 100%)修正到 [0%, 100%] 区间。而且我们发现,在进行测试集级别的性能评测时,新提出的 mTER 准确率与传统的 TER 指标基本兼容可比(详见原论文中的mTER与TER大规模对比)。
本文介绍了自动语音识别的开源评估平台 SpeechColab Leaderboard。基于该平台,我们开展并报告了广泛的基准测试,揭示了科研和工业领域最先进的自动语音识别系统的现状。此外,我们还对评估流程中不同组件的作用进行了定量研究,这为社区将来建立一系列 ASR 基准提供了有价值的参考。此外,通过利用我们的平台和基准结果,我们提出了一个新指标mTER,它比传统的错误率(TER)更鲁棒。未来,我们打算将更多数据集和模型纳入平台。
