
 THUsatlab
问题分析
如今预训练模型已成为绝大多数任务的最佳方案。然而在机器异常声音检测任务上,预训练模型的表现往往不佳。表1展示了往年DCASE竞赛异常声音检测赛道前5系统的预训练模型使用情况。其中仅有2023年的第2名和第3名使用了预训练模型,其余系统均未使用预训练模型。这不仅让人怀疑,为何预训练模型在异常声音检测上的表现较差。
表1:往年DCASE竞赛异常声音检测赛道前5系统
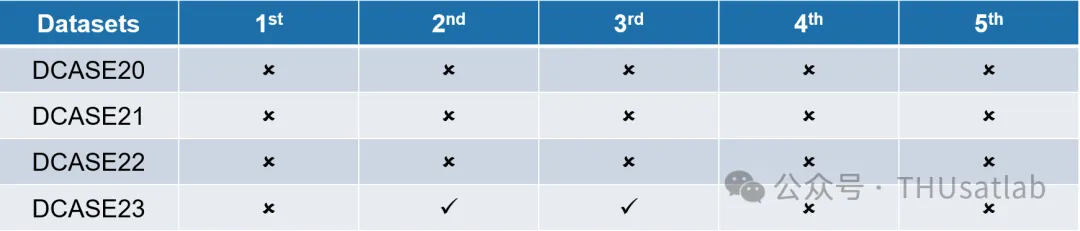
注:ü表示使用预训练模型,û表示不使用预训练模型
通常情况下,预训练模型需要在有标注的数据集上微调。然而异常检测的训练集缺少负样本,无法直接进行微调,必须采用代理任务进行微调(如:预测机器工况、类型等),而代理任务与异常检测任务往往不一致。因此,一般认为缺少异常数据是表现较差的原因。
改进思路
之前采用预训练模型的方法 [1] 使用的是语音预训练模型(如:Wav2Vec, HuBERT等)。相比于机器声音,人类的语音的变化更多,携带的信息更丰富。相应地,神经网络在设计时会适配语音的归纳偏置,例如利用帧间丰富的信息进行自监督。然而机器声音更为平稳,具有稀疏特征,可能不再适合使用语音预训练模型。
数据不一致性。在语音数据上学得的模型参数,很可能不适合处理机器声音。 结构不一致性。语音和机器声音的归纳偏置不同,导致适配语音的神经网络很可能不适合机器声音。
基于此,研究团队从两个方面分别进行优化:
数据一致性。采用在AudioSet [2] 上预训练的模型。AudioSet包含了世界上的各种声音,既有多变的也有平稳的。相比于语音数据集,AudioSet与机器声音更相关。 结构一致性。采用ViT [3] 作为主干网以提取特征,并使用SpecAug [4] 作为数据增强,以应对机器声音的稀疏性。
模型结构
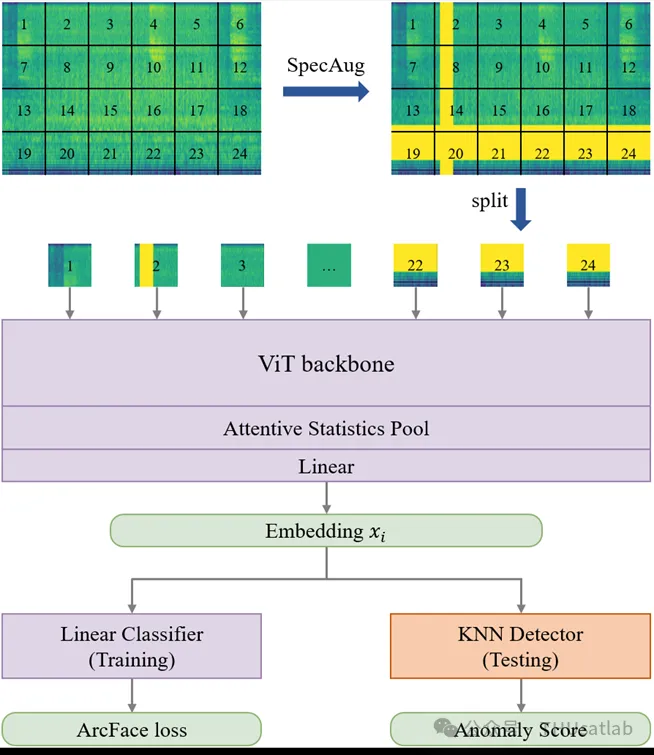
图2:AnoPatch网络结构
图2展示了AnoPatch的网络结构。机器声音首先被转化为对数梅尔谱,然后分别沿时域和频域进行掩蔽,再送入ViT主干网。ViT主干网的参数初始化自BEATs [5],其将梅尔谱切块并送入Transformer块 [6],生成每个频谱块的表征。最后,每个频谱块的表征通过自注意池化层 [7],融合为整段音频的表征。
训练采用全量微调。训练任务为预测机器运行工况。训练时引入额外的线性分类器将整段音频的表征映射至工况标签,采用ArcFace [8] 损失函数以增大任务难度。
异常检测采用KNN检测器。训练完成后,提取所有正常音频的表征并构建正常声纹库。对每段测试音频,提取其表征并与正常声纹库进行对比,异常分数为测试表征到声纹库中最近邻居的距离(k=1)。KNN采用Cosine距离度量。
实验结果
研究团队在DCASE 2020数据集和DCASE 2023数据集上进行了实验,并对比了之前最好的模型。评价标准均与比赛规则一致。实验结果分别展示在表2和表3中。
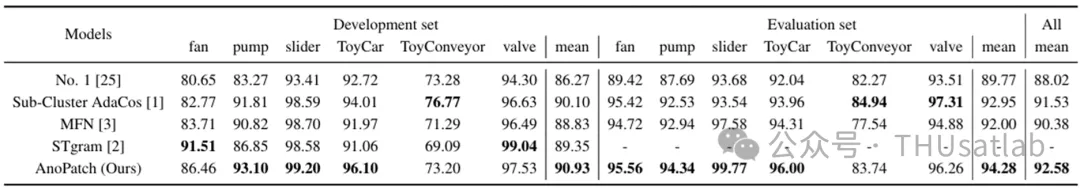
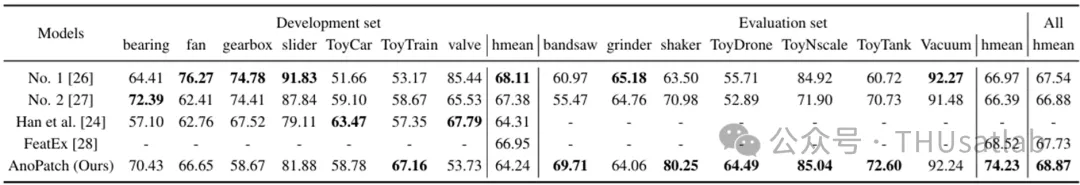
在两个数据集上,AnoPatch大幅超出了已有的模型。这说明在保证数据一致性和结构一致性的条件下,预训练模型依然具备强大的异常检测能力。
为进一步论证结论,研究团队在DCASE 2020数据集上对多种预训练模型进行了微调,包括4种语音预训练模型和4种音频预训练模型。实验结果展示在表4。
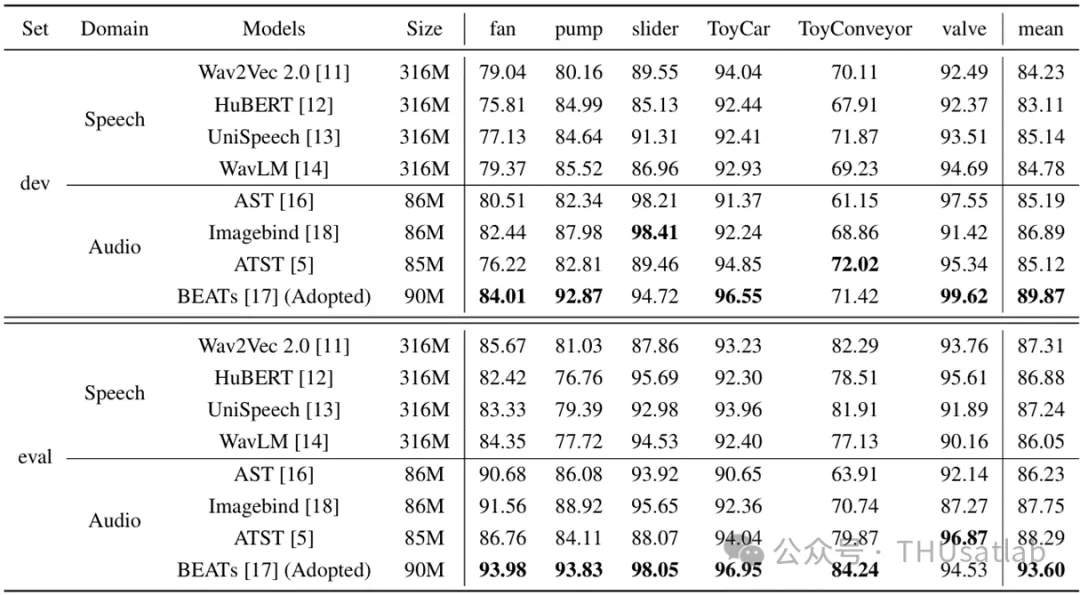
表4中,语音预训练模型的性能整体上均比音频预训练模型要差,这是因为语音预训练模型具有数据不一致性和结构不一致性。而音频预训练模型中,AST [9] 模型的平均性能最差,这是因为AST模型是从图像预训练模型微调而来,虽然满足了结构一致性,但不符合数据一致性。
结 论
参考文献:
[1]Han B, Lv Z, Jiang A, et al. Exploring Large Scale Pre-Trained Models for Robust Machine Anomalous Sound Detection[C]//ICASSP 2024-2024 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2024: 1326-1330.
[2] Gemmeke J F, Ellis D P W, Freedman D, et al. Audio set: An ontology and human-labeled dataset for audio events[C]//2017 IEEE international conference on acoustics, speech and signal processing (ICASSP). IEEE, 2017: 776-780.
[3] Dosovitskiy A, Beyer L, Kolesnikov A, et al. An image is worth 16x16 words: Transformers for image recognition at scale[J]. arXiv preprint arXiv:2010.11929, 2020.
[4] Park D S, Chan W, Zhang Y, et al. Specaugment: A simple data augmentation method for automatic speech recognition[J]. arXiv preprint arXiv:1904.08779, 2019.
[5] Chen S, Wu Y, Wang C, et al. Beats: Audio pre-training with acoustic tokenizers[J]. arXiv preprint arXiv:2212.09058, 2022.
[6] Vaswani A, Shazeer N, Parmar N, et al. Attention is all you need[J]. Advances in neural information processing systems, 2017, 30.
[7] Dawalatabad N, Ravanelli M, Grondin F, et al. ECAPA-TDNN embeddings for speaker diarization[J]. arXiv preprint arXiv:2104.01466, 2021.
[8] Deng J, Guo J, Xue N, et al. Arcface: Additive angular margin loss for deep face recognition[C]//Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2019: 4690-4699.
[9] Gong Y, Chung Y A, Glass J. Ast: Audio spectrogram transformer[J]. arXiv preprint arXiv:2104.01778, 2021.
