
 阿里语音AI
FunASR是由达摩院语音实验室开源的一款语音识别基础框架,集成了语音端点检测、语音识别、标点断句等领域的工业级别模型,吸引了众多开发者参与体验和开发。为了实现工业落地的最后一公里,开发了FunASR runtime-SDK,方便开发者高效、便捷地进行语音识别服务部署。
离线转写
力献语音识别全链路工业级模型
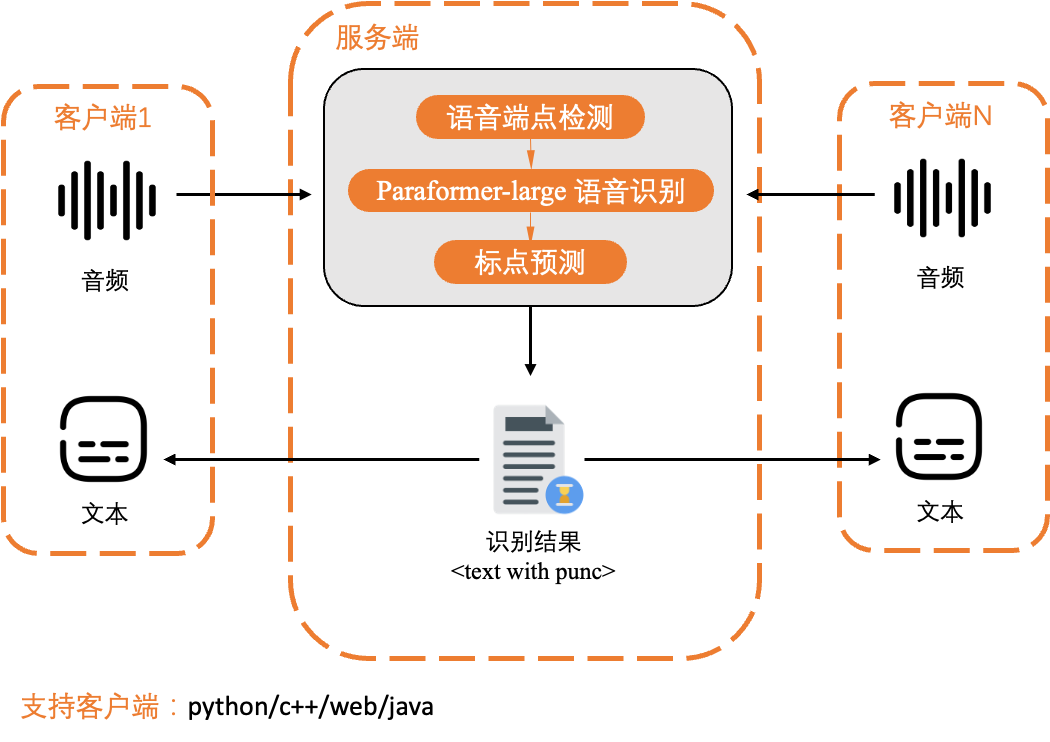
FunASR runtime-SDK提供了一款功能强大的语音离线文件转写开源工具,可以高精度、高效率、高并发(>100)的支持长音频离线转写。该SDK结合了达摩院语音实验室在Modelscope社区开源的语音端点检测、语音识别、标点等模型,支持模型的ONNX导出与量化,并提供了可方便快捷的部署到本地或者云端服务器的一键化部署脚本。开发者可以基于该SDK,便捷的构建高精度、高并发、高效率的离线文件转写服务。
四大优势
便捷、高精度、高效率、长音频链路
便捷部署
提供了一键部署FunASR runtime-SDK的方案,通过funasr-runtime-deploy-offline-cpu-zh.sh可一键完成docker安装、镜像启动、服务部署,详见FunASR离线文件转写服务便捷部署教程👇:
https://github.com/alibaba-damo-academy/FunASR/blob/main/funasr/runtime/docs/SDK_tutorial_zh.md
高精度
FunASR runtime-SDK集成了达摩院语音实验室在ModelScope开源数据训练的工业级语音识别模型Paraformer-large,保证了端到端转写效果的精度。
下方表格对比了Paraformer-large与当前最优SOTA模型识别效果:
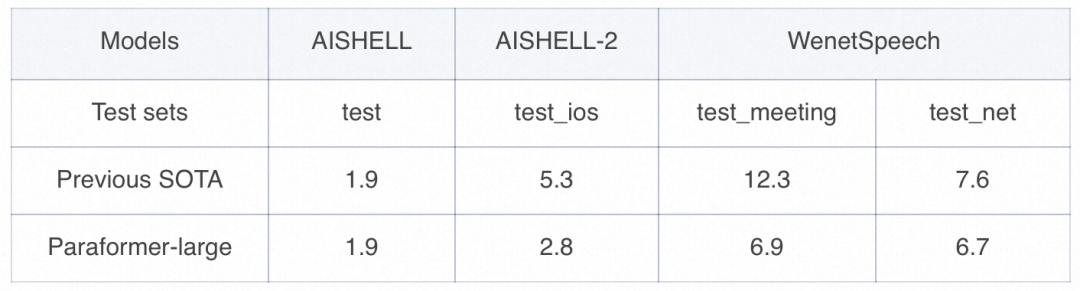
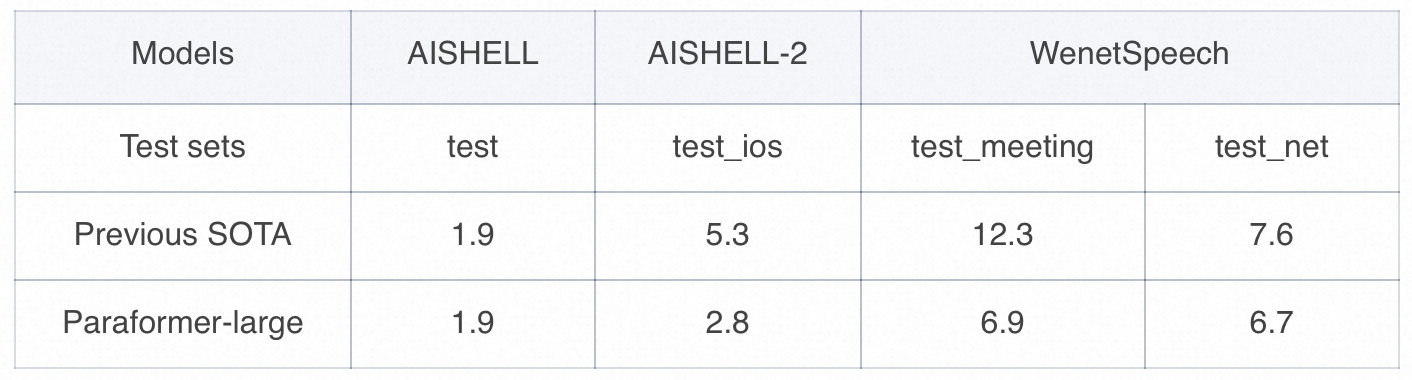
集成了Paraformer-large模型的阿里云语音识别服务API,在三方评测榜单SpeechIO最新6月评测中取得了SOTA效果。详情见 SpeechIO Leaderboard。https://mp.weixin.qq.com/s/eAgvlgwLqWQ9CQRRduUmtg
高推理效率
FunASR runtime-SDK中的语音端点检测(VAD)、语音识别(ASR)、标点断句(PUNC)模型均通过onnx 量化导出实现推理加速,其中ASR模型为基于Paraformer的非自回归模型,相比于目前普遍采用的自回归模型具有明显的推理效率优势,可同时支持多线并发,可以准确、高效地对音频进行转写。
采用AISHELL-1测试集测试了FunASR runtime-SDK的转写加速比,CPU8369B上的吞吐率为562。不同配置下的详细吞吐率指标如下表:
Intel(R) Xeon(R) Platinum 8369B CPU @ 2.90GHz 16core-32processor with avx512_vnni
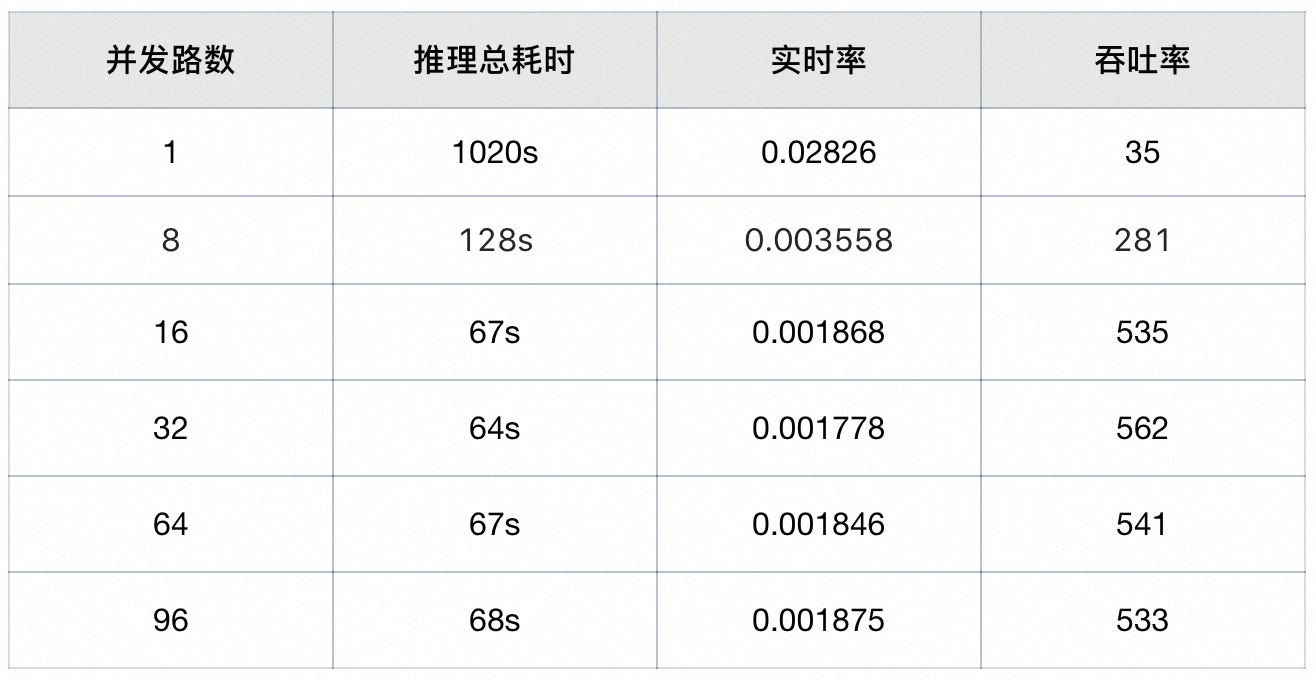
更多详细结果见benchmark: https://github.com/alibaba-damo-academy/FunASR/blob/main/funasr/runtime/docs/benchmark_onnx_cpp.md
长音频链路
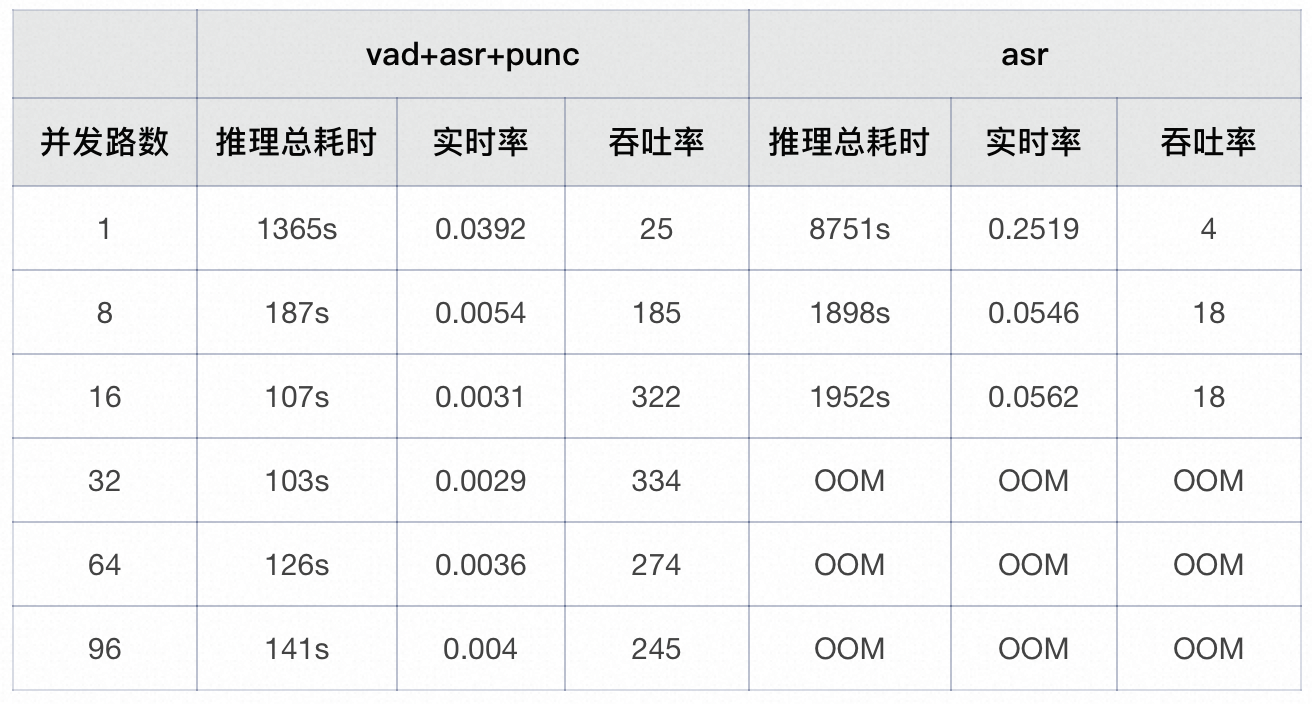
FunASR runtime-SDK提供了一套完整的语音识别链路,包括语音端点检测(VAD)、语音识别(ASR)、标点断句(PUNC),可用于高效转写长音频,用户可以无需进行二次开发。
在一个长音频测试集上(时长为0~24min)分别对asr链路、vad+asr+punc链路进行了测试,asr链路在并发32线时会OOM,vad+asr+punc链路的吞吐率为334,相比asr链路有明显优势。不同配置下的详细吞吐率指标如下表:
Intel(R) Xeon(R) Platinum 8369B CPU @ 2.90GHz 16core-32processor with avx512_vnni
使用指南
精简操作,即刻安装
FunASR runtime-SDK当前已开源。
开源工具包地址👇:
https://github.com/alibaba-damo-academy/FunASR/blob/main/funasr/runtime/readme_cn.md
步骤如下:
第一步:下载安装部署工具
curl -O https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/shell/funasr-runtime-deploy-offline-cpu-zh.sh;
第二步:安装部署
sudo bash funasr-runtime-deploy-offline-cpu-zh.sh install --workspace ./funasr-runtime-resources
第三步:测试与使用
运行上面安装指令后,会在./funasr-runtime-resources下载samples, 为客户端测试工具,支持python/c++/java/html网页等语言。以Python语言客户端为例,进行说明,支持多种音频格式输入(.wav, .pcm, .mp3等),也支持视频输入(.mp4等),以及多文件列表wav.scp输入以下代码:
python3 wss_client_asr.py --host "127.0.0.1" --port 10095 --mode offline --audio_in "../audio/asr_example.wav"运行上面客户端指令后,即可对音频进行识别转写。同时在云端部署了FunASR runtime-SDK服务,用户可以直接在浏览器中进行体验:
https://101.37.77.25:1336/static/index.html
FunASR-runtime-SDK背后的语音技术:
