
 西工大音频语音与语言处理研究组
目前大量关于视听语音识别 (AVSR) 的研究表明,将视觉信息整合到语音识别 (ASR) 模型中可以显著增强识别系统在复杂声学环境中的鲁棒性。Ma等人[1]提出了一种端到端的双编码器混合CTC/Attention AVSR方案,其中包括基于ResNet的视觉编码器、基于Conformer的音频编码器和一个多层感知模块 (MLP) 来融合不同的模态特征。与MLP的融合策略相比,Sterpu等人[2]首次引入了基于注意力的融合机制,并发现学习不同模态特征之间的对齐信息是提高性能的关键。随后,一些研究[3, 4]采用了交叉注意力模块来捕捉建模后的音视频特征之间的对齐和互补信息。此外,利用来自音频和视觉编码器不同层特征可以提升AVSR系统的性能也得到了许多研究的证实[5, 6]。
近期,基于多模信息的语音处理(MISP)挑战系列[7, 8],旨在探索远场多麦克风信号处理任务(如关键词检测和语音识别)中如何合理使用音视频双模信息,如图1所示。在MISP2022挑战赛的音视频语音分离和识别 (AVDR) 赛道中,参赛者们使用多通道音频数据和唇读视频数据来构建在家庭电视场景中的鲁棒远场语音识别系统。在比赛期间,我们提出了一种基于单层交叉注意力融合的AVSR系统 (SLCA-AVSR) [9],并取得了第二名的优异成绩。该系统使用交叉注意力模块来组合不同模态的特征。然而,这种方法是基于建模后的音视频特征进行模态融合,没有考虑在特征建模期间的上下文信息。尽管Li等人[10]探讨了多层级模态特征的融合,但基于连接的融合方法未能有效捕捉模态间的对齐信息。
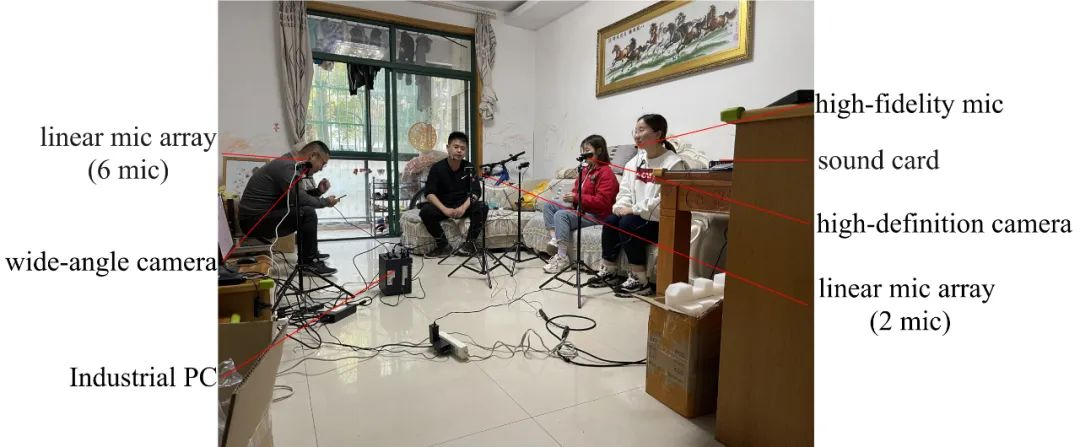
图1 MISP竞赛的录制场景[7,8]
交叉注意力
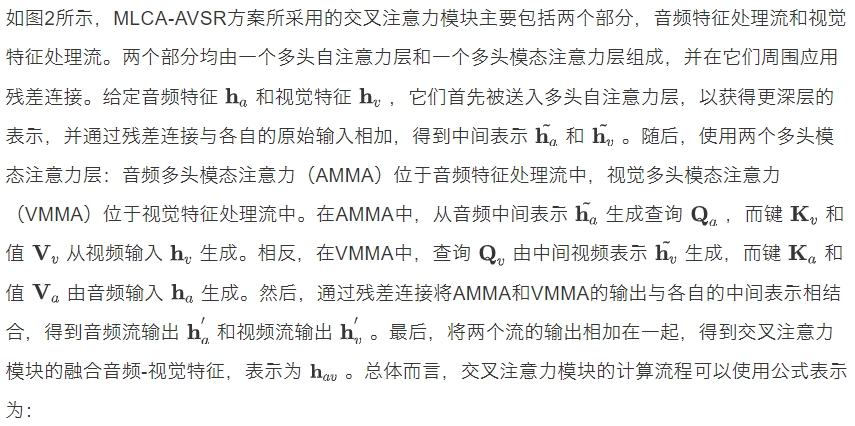
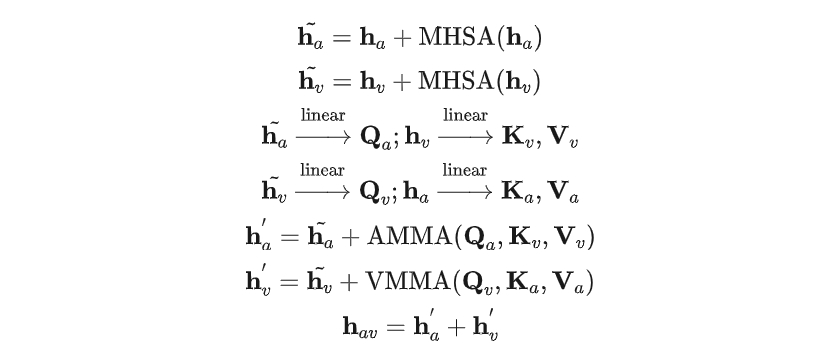
其中MHSA表示多头自注意力模块,
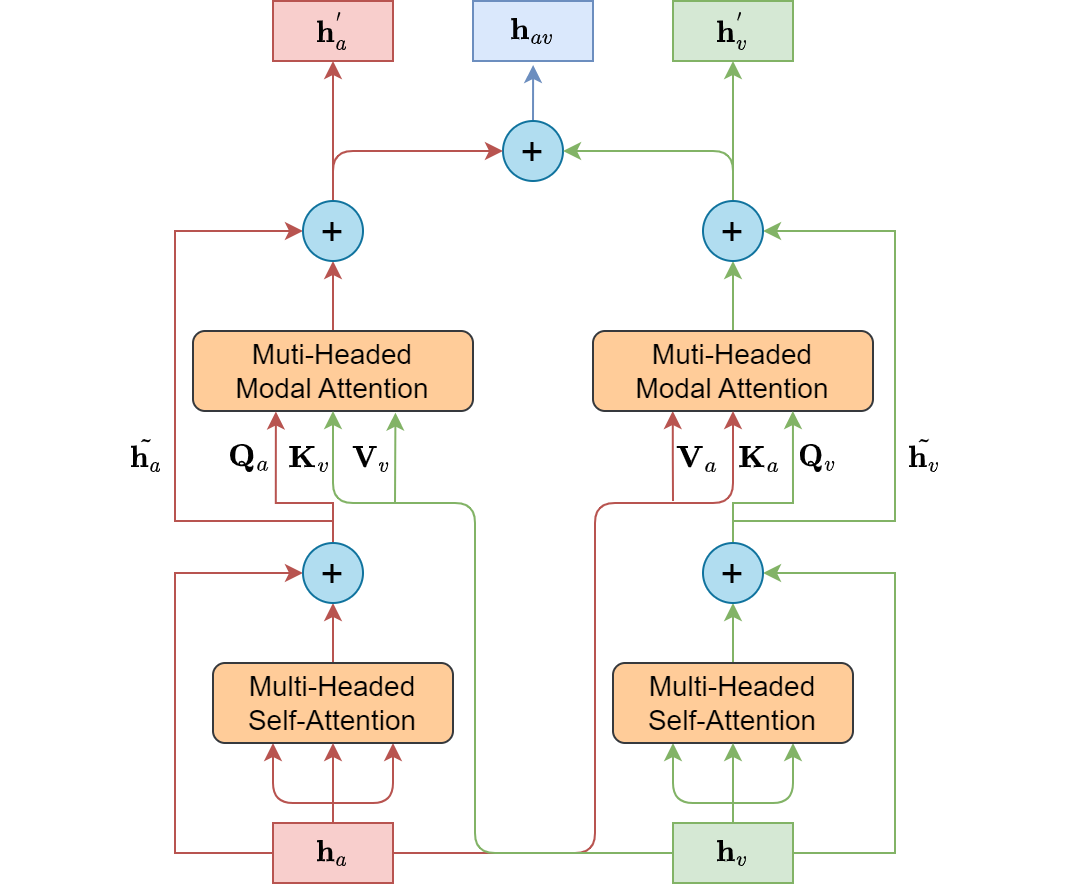
图2 交叉注意力模块示意图
多层交叉注意力融合
图3展示了MLCA-AVSR视听语音识别系统的结构,其包括四个主要组成部分,分别是音频和视觉前端、音频和视觉编码器、融合模块和解码器。我们采用了2层卷积下采样网络作为音频前端,ResNet3D网络作为视频前端,最近提出的E-Branchformer [12]作为音频和视觉编码器。同时,在音频和视觉编码器内引入了两个交叉注意力模块。这样一来,通过有效地利用编码器中不同层级的音视频特征,实现更好的多模态融合。
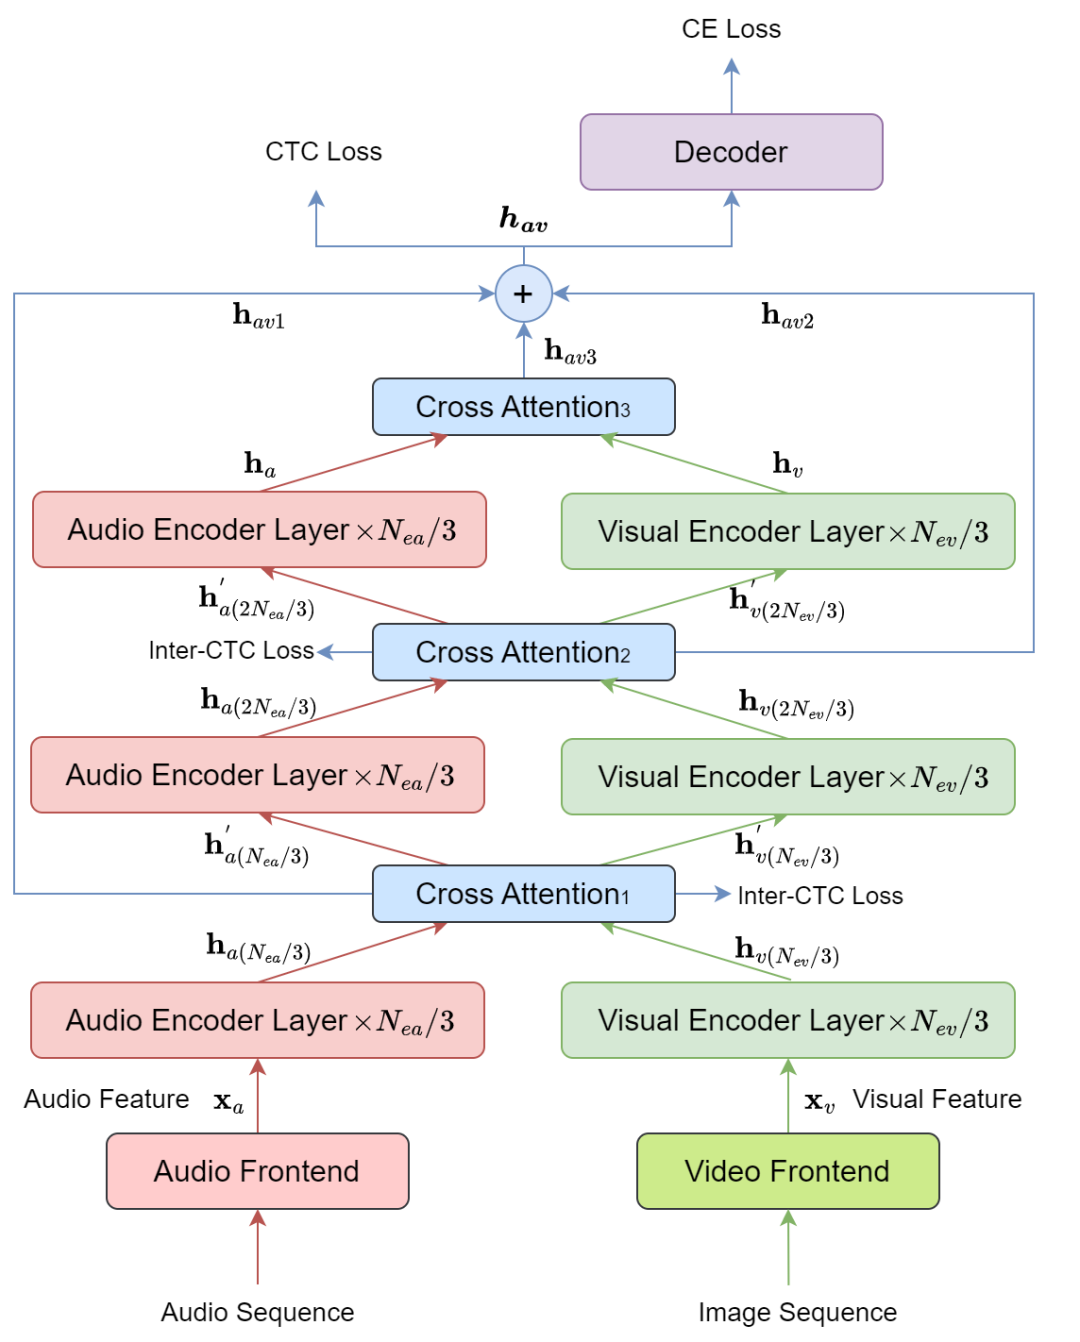
图3 MLCA-AVSR系统结构示意图
数据处理
实验设置
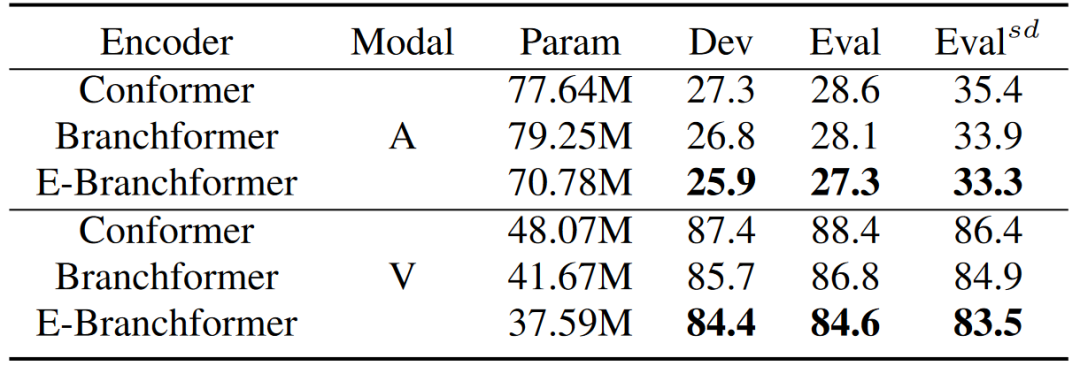
单模态 ASR 和 VSR 模型
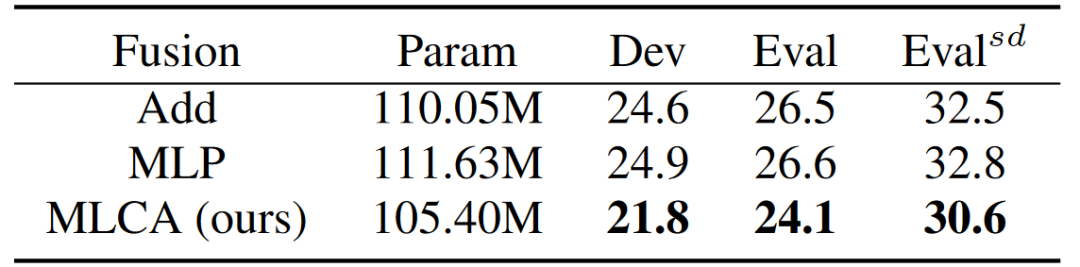
与常见模态融合方法对比
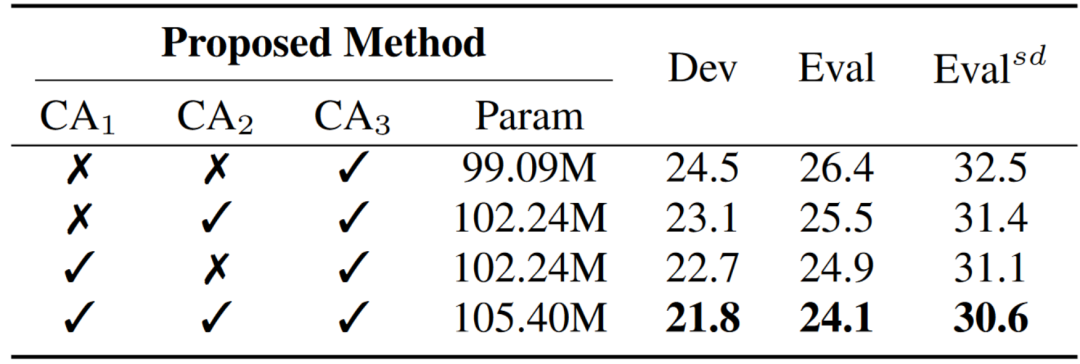
消融实验
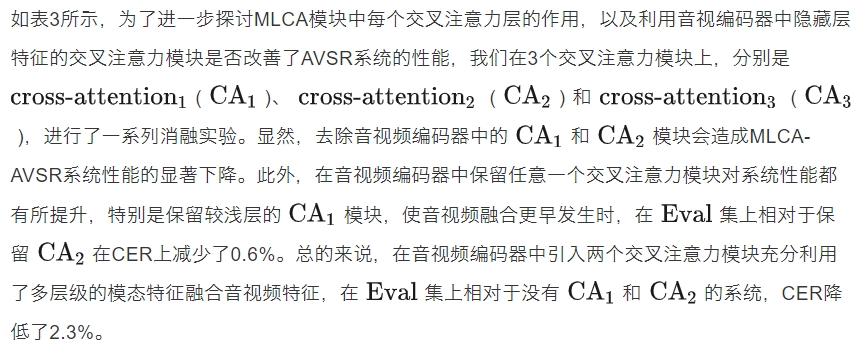
表3 针对MLCA-AVSR中的3个交叉注意力模块的消融实验结果
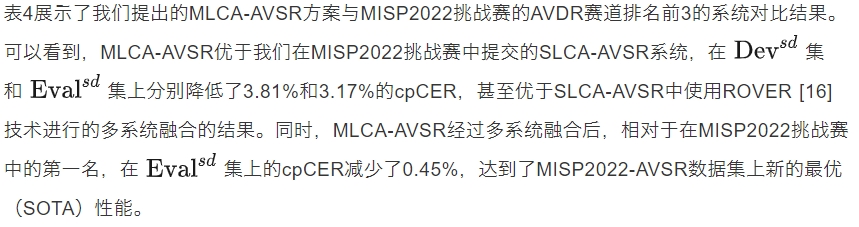
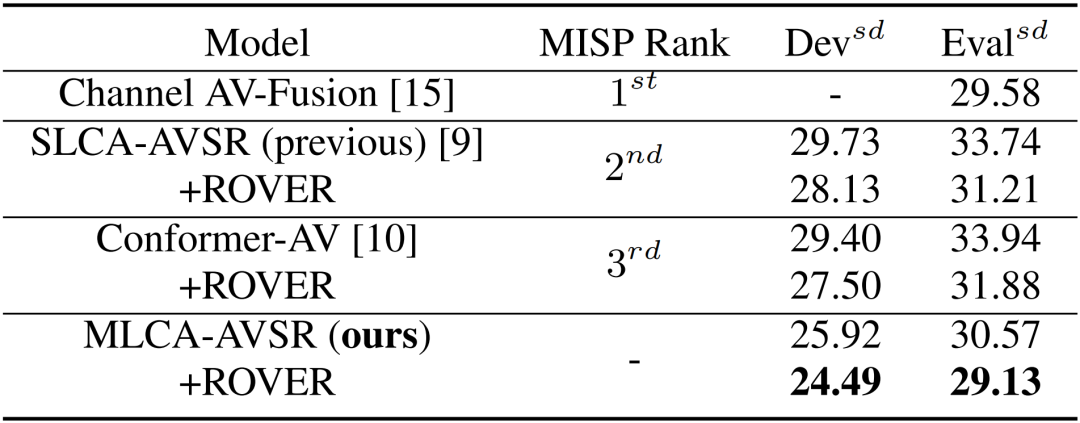
与MISP2022挑战赛Top3系统对比
[1] Pingchuan Ma, Stavros Petridis, and Maja Pantic, “End-to-end audio-visual speech recognition with conformers,” in Proc. ICASSP. IEEE, 2021, pp. 7613–7617.
[2] George Sterpu, Christian Saam, and Naomi Harte, “Attentionbased audio-visual fusion for robust automatic speech recognition,” in Proc. MI. ACM, 2018, pp. 111–115.
[3] Yifei Wu, Chenda Li, Song Yang, Zhongqin Wu, and Yanmin Qian, “Audio-visual multi-Talker speech recognition in a cocktail party,” in Proc. Interspeech. ISCA, 2021, pp. 3021–3025.
[4] Ao Zhang, He Wang, Pengcheng Guo, Yihui Fu, Lei Xie, Yingying Gao, Shilei Zhang, and Junlan Feng, “VE-KWS: Visual modality enhanced end-to-end keyword spotting,” in Proc. ICASSP. IEEE, 2023, pp. 1–5.
[5] Ming Cheng, Haoxu Wang, Yechen Wang, and Ming Li, “The DKU audio-visual wake word spotting system for the 2021 MISP challenge,” in Proc. ICASSP. IEEE, 2022, pp. 92569260.
[6] Tao Li, Haodong Zhou, Jie Wang, Qingyang Hong, and Lin Li, “The XMU system for audio-visual diarization and recognition in MISP challenge 2022,” in Proc. ICASSP. IEEE, 2023, pp. 1–2.
[7] Hang Chen, Jun Du, Yusheng Dai, Chin Hui Lee, Sabato Marco Siniscalchi, Shinji Watanabe, Odette Scharenborg, Jingdong Chen, et al., “Audio-visual speech recognition in misp2021 challenge: Dataset release and deep analysis,” in Proc. Interspeech. ISCA, 2022, pp. 1766–1770.
[8] Zhe Wang, Shilong Wu, Hang Chen, Mao-Kui He, Jun Du, Chin-Hui Lee, Jingdong Chen, Shinji Watanabe, et al., “The multimodal information based speech processing (MISP) 2022 challenge: Audio-visual diarization and recognition,” in Proc. ICASSP. IEEE, 2023, pp. 1–5
[9] Pengcheng Guo, He Wang, Bingshen Mu, Ao Zhang, and Peikun Chen, “The NPU-ASLP system for audio-visual speech recognition in MISP 2022 challenge,” in Proc. ICASSP. IEEE, 2023, pp. 1–2.
[10] Tao Li, Haodong Zhou, Jie Wang, Qingyang Hong, and Lin Li, “The XMU system for audio-visual diarization and recognition in MISP challenge 2022,” in Proc. ICASSP. IEEE, 2023, pp. 1–2.
[11] Jaesong Lee and Shinji Watanabe, “Intermediate loss regularization for CTC-based speech recognition,” in Proc. ICASSP. IEEE, 2021, pp. 6224–6228.
[12] Kwangyoun Kim, Felix Wu, Yifan Peng, Jing Pan, Prashant Sridhar, Kyu J Han, and Shinji Watanabe, “E-branchformer: Branchformer with enhanced merging for speech recognition,” in Proc. SLT. IEEE, 2023, pp. 84–91.
[13] David Snyder, Guoguo Chen, and Daniel Povey, “Musan: A music, speech, and noise corpus,” arXiv preprint arXiv:1510.08484, 2015.
[14] Bowen Pang, Huan Zhao, Gaosheng Zhang, Xiaoyue Yang, et al., “Tsup speaker diarization system for conversational short-phrase speaker diarization challenge,” in Proc. ISCSLP. IEEE, 2022, pp. 502–506.
[15] Gaopeng Xu, Xianliang Wang, Sang Wang, Junfeng Yuan, Wei Guo, Wei Li, and Jie Gao, “The NIO System for audio-visual diarization and recognition in MISP challenge 2022,” in Proc. ICASSP. IEEE, 2023, pp. 1–2.
[16] Jonathan G Fiscus, “A post-processing system to yield reduced word error rates: Recognizer output voting error reduction (ROVER),” in Proc. ASRU. IEEE, 1997, pp. 347–354.
