
 西工大音频语音与语言处理研究组
为促进驾驶场景中语音处理和识别研究,在ISCSLP 2022上成功举办智能驾驶座舱语音识别挑战 (ICSRC)的基础上,西工大音频语音与语言处理研究组 (ASLP@NPU)联合理想汽车、希尔贝壳、WeNet社区、字节、微软、天津大学、南洋理工大学以及中国信息通信研究院等多家单位在ICASSP2024上推出了车载多通道语音识别挑战赛(ICMC-ASR)。作为大会的旗舰赛事之一,ICMC-ASR发布了在新能源汽车内录制的100多小时多通道语音数据(单通道计算)以及用于数据增广的40小时噪声数据。挑战赛设有语音识别 (ASR)和语音分离和识别 (ASDR)两个赛道,分别使用字符错误率 (CER)和连接最小排列字符错误率 (cpCER)作为评价指标。
本次挑战赛吸引了国内外共计98支队伍参赛,并在两个赛道上收到了53个有效提交结果。竞赛总结论文“ICMC-ASR: The ICASSP 2024 In-Car Multi-Channel Automatic Speech Recognition Challenge”已被语音研究顶级会议ICASSP2024接收。现对该论文进行分享,包括竞赛举办的背景、所采用的数据集、赛道设置、比赛结果和各参赛队伍所采用的关键技术等。
相关链接:NPU-ASLP实验室10篇论文被ICASSP2024录用
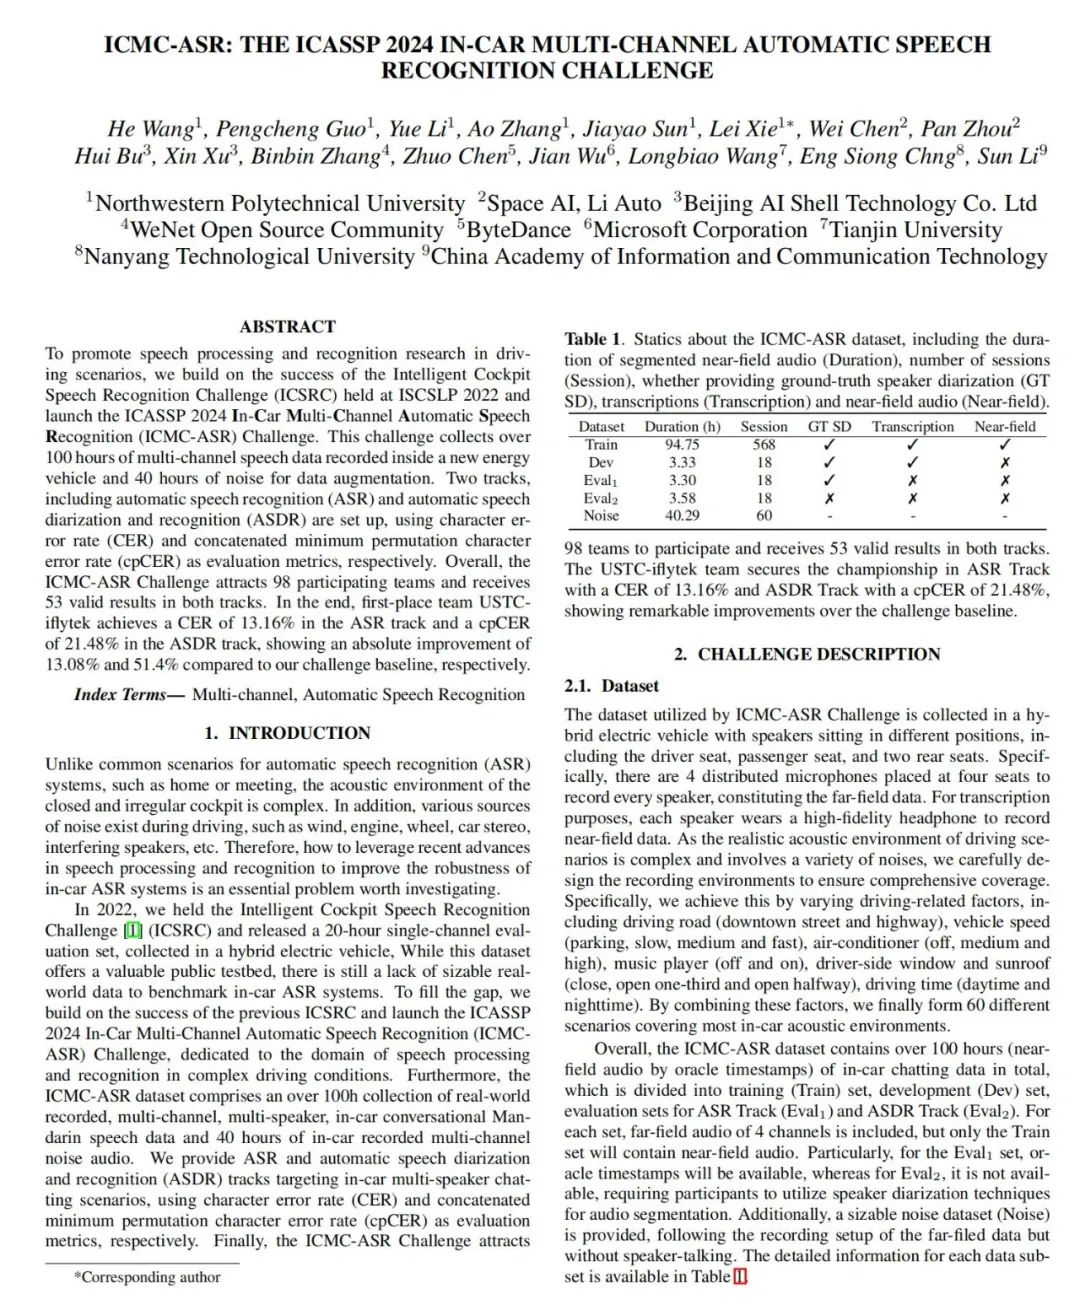
发表论文截图
随着深度学习的不断发展,语音识别(ASR)技术取得了长足的进步,其性能也获得了大幅提升。然而ASR系统在实际复杂远距离拾音场景中的表现远未达到满意的效果,干扰来自背景噪声、混响、说话人重叠和需要适配各种麦克风阵列几何结构拓扑等。为了应对这些挑战,CHiME系列竞赛应运而生,竞赛的宗旨是通过鼓励多通道信号处理算法的研究和创新来促进鲁棒 ASR系统的发展。
数据集
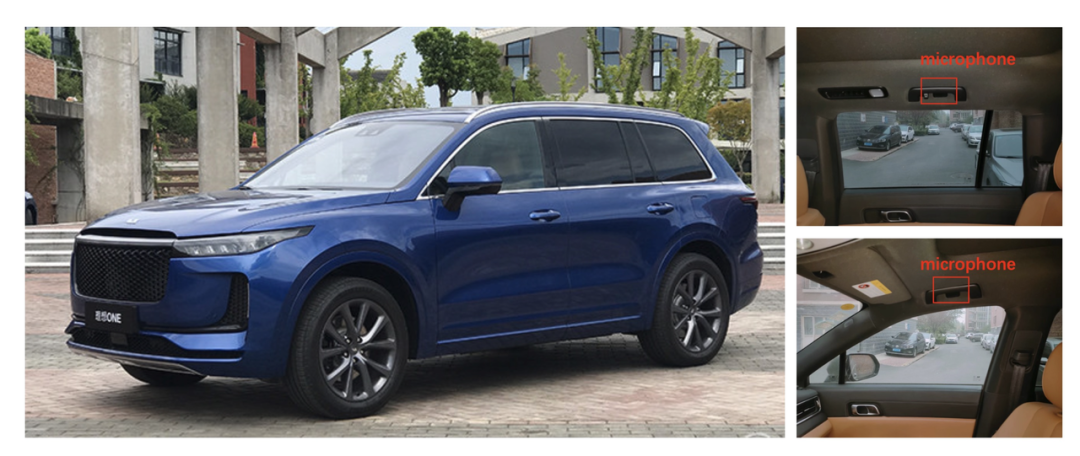
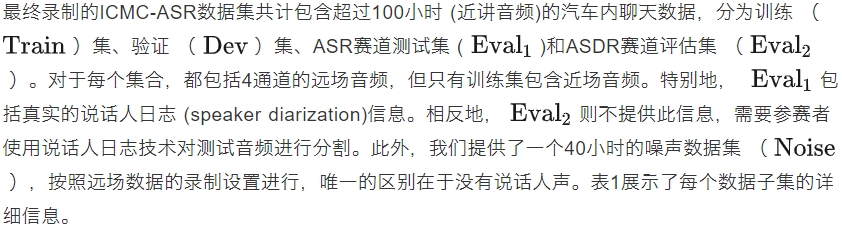
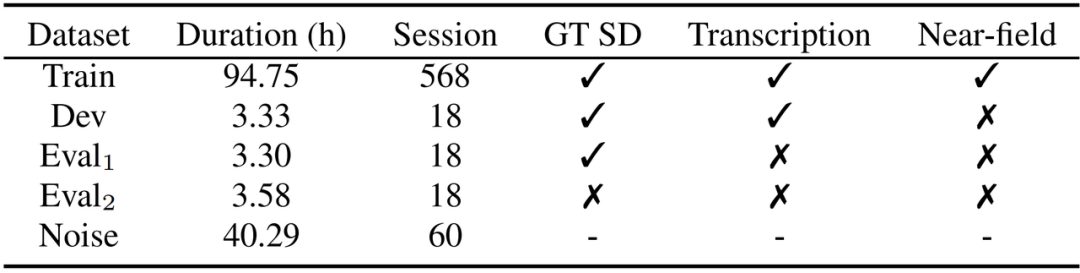
表1 ICMC-ASR数据集的统计信息,包括近场音频的时长 (Duration)、会话数 (Session)、是否提供真实说话人日志 (GT SD)、转录文本 (Transcripti on) 以及近场音频 (Near-field)。
赛道设置
竞赛官方网站:https://icmcasr.org/
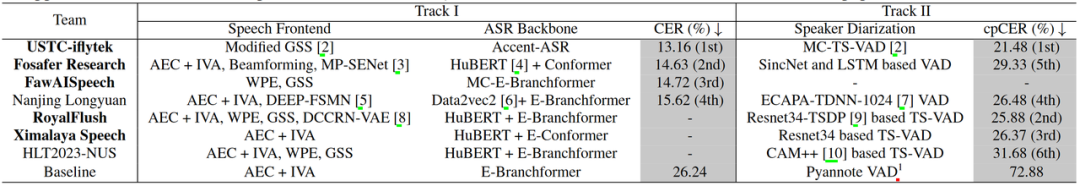
表2 两个赛道的Top系统和竞基线系统所使用的主要技术和结果。语音前端和ASR在两个赛道中都被应用,而说话人日志技术仅用于Track2。加粗的团队受邀提交ICASSP 2024的技术报告论文。
[1] Ao Zhang, Fan Yu, Kaixun Huang, Lei Xie, et al., “The ISCSLP 2022 Intelligent Cockpit Speech Recognition Challenge (ICSRC): Dataset, Tracks, Baseline and Results,” in Proc. ISCSLP. IEEE, 2022, pp. 507–511.
[2] Ruoyu Wang, Maokui He, Jun Du, Hengshun Zhou, et al., “The USTC-Nercslip Systems for the CHiME-7 DASR Challenge,” 2023.
[3] Ye-Xin Lu, Yang Ai, and Zhen-Hua Ling, “MP-SENet: A Speech Enhancement Model with Parallel Denoising of Magnitude and Phase Spectra,” 2023.
[4] Wei-Ning Hsu, Benjamin Bolte, Yao-Hung Hubert Tsai, et al., “Hubert: Self-Supervised Speech Representation Learning by Masked Prediction of Hidden Units,” IEEE/ACM TASLP, vol. 29, pp. 3451–3460, 2021.
[5] Shiliang Zhang, Ming Lei, Zhijie Yan, et al., “Deep-FSMN for Large Vocabulary Continuous Speech Recognition,” in Proc. ICASSP, 2018, pp. 5869–5873.
[6] Alexei Baevski, Arun Babu, Wei-Ning Hsu, and Michael Auli, “Efficient Self-Supervised Learning with Contextualized Target Representations for Vision, Speech and Language,” in Proc. ICML. PMLR, 2023, pp. 1416–1429.
[7] Brecht Desplanques, Jenthe Thienpondt, and Kris Demuynck, “ECAPA-TDNN: Emphasized Channel Attention, Propagation and Aggregation in TDNN based Speaker Verification,” in Proc. Interspeech. 2020, pp. 3830–3834, ISCA.
[8] Yang Xiang, Jingguang Tian, Xinhui Hu, et al., “A Deep Representation Learning-based Speech Enhancement Method using Complex Convolution Recurrent Variational Autoencoder,” arXiv preprint arXiv:2312.09620, 2023.
[9] Jingguang Tian, Xinhui Hu, and Xinkang Xu, “Royalflush Speaker Diarization System for ICASSP 2022 Multi-Channel Multi-Party Meeting Transcription Challenge,” arXiv preprint arXiv:2202.04814, 2022.
[10] Hui Wang, Siqi Zheng, Yafeng Chen, Luyao Cheng, and Qian Chen, “CAM++: A Fast and Efficient Network for Speaker Verification using Contextaware Masking,” arXiv preprint arXiv:2303.00332, 2023.
[11] Zhuoyuan Yao, Di Wu, Xiong Wang, et al., “WeNet: Production Oriented Streaming and Non-streaming End-to-End Speech Recognition Toolkit,” 2021.
[12] Pengcheng Guo, He Wang, Bingshen Mu, Ao Zhang, and Peikun Chen, “The NPU-ASLP System for Audio-Visual Speech Recognition in MISP 2022 Challenge,” in Proc. ICASSP. IEEE, 2023, pp. 1–2.
[13] Ivan Medennikov, Maxim Korenevsky, Tatiana Prisyach, Yuri Khokhlov, et al., “Target-Speaker Voice Activity Detection: A Novel Approach for Multispeaker Diarization in A Dinner Party Scenario,” pp. 274–278, 2020.
