Recent Advances on Speech Dialogue and Auditory Processing (RASDAP2024)Technical Report
为了更好地推动语音对话与听觉处理领域的深入交流与前沿研究,由中国计算机学会(CCF)语音对话与听觉专委会发起的第一届语音对话与听觉处理前沿进展研讨会(RASDAP2024,Recent Advances on Speech Dialogue and Auditory Processing)于2024年4月21日在江苏苏州CCF业务总部&学术交流中心顺利举办。本次研讨会在上海交通大学俞凯教授和中国科学技术大学凌震华教授的共同组织下,邀请了名古屋大学Tomoki Toda教授、小米语音首席科学家Daniel Povey博士、香港中文大学(深圳)李海洲教授、中国科学技术大学袁家宏教授、微软亚洲研究院刘树杰研究员、NVIDIA陈哲怀研究员、三星中国研究院高级技术总监朱璇博士、阿里巴巴通义语音实验室鄢志杰博士、昆山杜克大学李明副教授、香港中文大学(深圳)武执政副教授、上海交通大学陈谐副教授、中国科学技术大学张结副研究员等国内外语音技术领域专家,围绕“大模型时代语音技术研究的挑战与机遇” (Challenges and Opportunities of Speech Technology Research in the Era of Large Models)主题展开了深入探讨。研讨会采用全英文形式,吸引了来自国内高校和企业的100余位语音同行报名参会,研讨会详情见活动预告和RASDAP2024新闻稿。
为期半天的研讨会,通过引导发言和开放讨论两种形式,对齐了学术界和工业界语音大模型研究的前沿进展,进一步挖掘了语音大模型研究的一系列挑战性问题以及可能的解决方案。RASDAP这种小规模、精品化、主题高度聚焦形式的研讨会对团结和组织我国语音、对话与听觉相关领域的专业人士开展学术交流活动,强化各研究方向的融合,促进学术界与工业界的合作,提升我国语音、对话与听觉领域的科研、教学、应用水平以及国际影响力具有重要意义。


引导发言(Introdutory talks)

1)Tomoki Toda: Challenges in Leveraging Large Models for Augmented Speech Production
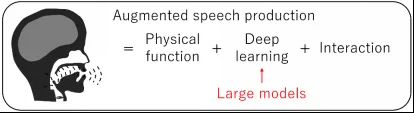
对于建立在人类语音生成基础上的增强式语音生成(augmented speech production)任务,如语音转换(voice conversion, VC)等,物理功能、深度学习和交互方式是其三个重要要素。大模型的涌现有助于大幅提升深度学习框架的建模能力。Toda教授在IEEE SLT2021上的特邀报告中指出语音转换任务的发展方向包括:1)结合序列到序列建模与无监督学习的语音转换,包括研究高质量可控的话者转换方法、基于自监督预训练和迁移学习等技术灵活应用海量语音数据、实现语音转换从“谁说”(who speaks)到“怎么说”(how to speak)的发展(如适用于任意语言的通用表征学习、长时特征嵌入、风格情感转换等);2)语音转换任务定义的拓展,即从“保留语言(linguistic)信息的同时转换话者(speaker)信息”修改为“保留概念(conceptual)信息的同时转换任意(arbitrary)信息”,其中基于高层嵌入表征的序列到序列语音转换是保留概念信息的关键;3)增强式语音生成应使用低延时/实时的语音转换技术,结合额外输入信号和交互指令创造用户与系统之间的协同作业功能。

随着大模型的涌现,语音转换领域出现了一些新的代表性研究工作,如基于识别-合成框架的任意到任意(any-to-any)语音转换、神经编解码器语言模型(如VALL-E)、基于大模型的增强式语音生成(面向嗓音缺陷人士)。因此,现阶段增强式语音生成领域面临的三方面挑战可以概括如下:1)强化自监督表征学习能力,一方面提升自监督表征学习的可控性和通用性,例如学习相对音素更鲁棒的表征结构、单独控制不同音频属性、与低资源语音的表征共享等,另一方面结合语音之外的信号表征,例如包含面部图像/手势/姿态等多模态信号的自监督表征学习、学习数据之中本源特征、挖掘潜在的其他输入信号等;2)学习概念表征(Conceptual Representation),包括挖掘文本之外的表征(如从text-to-speech到concept-to-speech、学习高层级表征、生成更多的语音信号种类、灵活生成条件等)、挖掘语音与多模态信号之间的联系(如控制语音表达方式、学习不同模态之间可共享的概念性表征);3)挖掘人类适应能力(Human Adaption Capability),基于大模型的增强式语音生成需要满足低延时、实时、因果性、低计算成本、高效预测等要求,同时还应最大化人类适应性能(如设计系统内部状态的有效反馈机制、个性化和共享信息的分解、增强学习、高效获取用户评价等)。


2)Daniel Povey:Challenges of Speech Research in the Era of Large Models
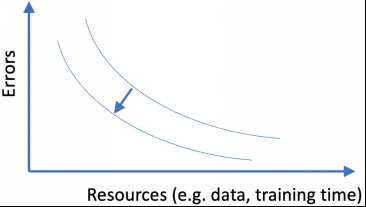
Povey博士表示引导发言上,他不会过多谈论技术趋势,因为他没有预言未来的“魔法水晶球”(crystal ball),而是更关注影响我们在大模型时代快速取得进展的因素。首先,取得技术进展的形式可以是多样化的,包括新的建模方法,(如历史上的回退语言模型和基于高斯混合模型的隐马尔可夫模型)、模型的逐步改进、有效的实践经验(如划分训练和测试集和数据集标准化)、收集相关数据集和发掘新任务、开发工具、复现先进性能水平(SOTA)算法的公开recipe、工具和指标的评价机制、模型诊断和可视化工具、程序调试工具等。其次,研究进展具有一种“遗传进化模型”,如果将每组的recipe集合视为一个遗传谱系,那么其中某个recipe通常经过微小的变化从另一个recipe中派生出来,有时也有“交叉”,问题在于需要仔细分析实验的周转时间(例如大模型通常较慢)、研究跟进速度、实验设置条件等影响进展速度的因素。另外,增加更多的资源(如数据量、训练时间)通常可以提升模型性能,但这并不一定能帮助我们学到任何东西。从长远角度来看,改进模型recipe更有趣,学术界希望向左下移动曲线,而工业界通常只关心曲线是否向下移动,因此使用海量数据开展研究存在着严重缺陷。为了训练庞大的模型,研究团队通常使用专有数据集,这意味着实验并不是真正可重复的,以及调整模型结构等因素的机会不多。不幸的是,有些方法只适用于“足够大”的数据,开发出在小规模数据上发挥作用的技术显然更有意义。


最后,Povey博士表示让很多人在这个领域做研究本身就是一种挑战,因为追赶别人正在做的事情基本不可能。我们需要开始以更简洁的形式交流研究成果(因为没有人有时间进行大量阅读),也许可以采用某种科学社交网络。另外一个挑战之处在于保持对研究问题的专注。


3)刘树杰:Towards Speech Large Language Model for Zero-shot Speech Synthesis and Translation
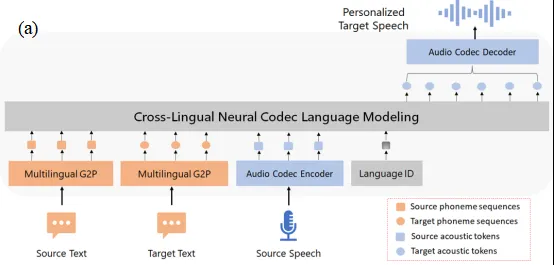
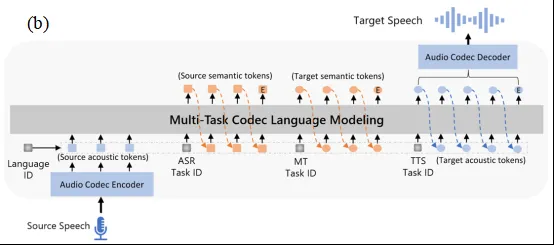
从语音和语言这两种模态的区别入手,刘树杰博士着重介绍了微软亚洲研究院团队如何利用编解码器(Codec)得到的token构建语音大语言模型的一系列探索。为了将连续的语音信号转换为离散的token,从而可以像构建语言大模型那样构建语音大模型,VALL-E模型通过神经网络编解码器(Neural Codec)将语音信号转换为token,并基于此构建大模型。基于独立解码器(decoder-only) 框架和大规模多样的训练数据,VALL-E展现出了强大的上下文学习(In-context learning)能力,能够基于极短的语音片段复制未曾在训练数据中出现过的任意说话人的声音。然而,自回归模型结构和采样解码过程导致VALL-E的效率不高,且鲁棒性有待加强。VALL-E 2模型采用了基于组的建模方法和自适应的贪心搜索算法,显著提升了合成语音的自然度、语调相似度和鲁棒性等指标。进而,他们将单语言的VALL-E扩展为多语言的VALL-E X,任务类型也从单纯的语音生成拓展至语音识别和机器翻译,即VioLA模型。另外,他们提出的SpeechX模型,能够处理降噪、语音移除、提取目标说话人语音、语音编辑等多项任务。


(a)VALL-E X:跨语种Neural Codec语言模型,(b)VioLA: 适用于自动语音识别、机器翻译、语音合成和语音翻译的统一模型
最后,刘树杰博士认为基于token的独立解码器方法既能够充分利用大规模的语音数据,又可以很容易地借鉴语言大模型的先进技术,从而构建一个可以将所有的语音处理任务统一起来的语音大模型系统。其中,神经编解码器(Neural Codec)也许并不是最佳的离散token生成器,如何将连续的语音信号转换为离散的信号仍然需要进一步的探索。另外,语音与文本、视频等模态的融合也是一个值得深入探索的方向。


4)陈哲怀:A Journey towards Speech Foundational Model and Speech Augmented Large Language Model
构建大规模语音基础模型的动机包括使用无标签语音数据学习获得更好性能、利用大量多语种数据处理低资源任务以及多任务语音处理需求等,挑战之处在于可拓展的(scalable)模型架构、训练损失函数和可拓展的数据收集和清洗方式。USM模型是第一个将语音-文本联合自训练提升到超大规模的一个尝试。为了降低训练USM的代价,Canary模型采用了一个完全开源的大规模多任务监督训练方案,该模型利用128张A100(80GB)GPU训练,每个epoch耗时6分钟,总共12.8小时,每天训练85K小时数据,已集成在NVIDIA NeMo 工具包。


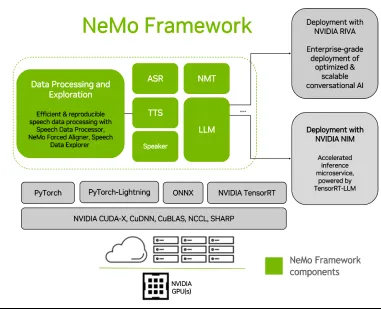
陈哲怀博士在报告的第二部分分享了NVIDIA团队近期关于语音大语言模型(Speech-LLM)的研究工作,并表示这类系统具有孕育新的语音应用的潜力。为了降低研究这一方向的门槛,其研究团队在NeMo里提供了一套统一且高效的语音、自然语言处理、大模型的支持。基于这一框架完成了一些前期关于传统语音任务的系统,相比单纯语音基础模型在自动语音识别(ASR)和自动语音翻译(AST)等任务上取得了更好的结果。NeMo 的模型架构可采用GPT (decoder-only)、T5 (encoder-decoder)、BERT (encoder)、RETRO (encoder-decoder + retrieval)等,训练模式可采用预训练(Pre-training)、可拓展式微调(Scalable Fine-Tuning, SFT)、参数有效微调(Parameter Efficient Fine-tuning, PEFT)、低秩适配(Low-Rank Adaption, LoRA)、基于提示信息的微调(如Prompt-tuning,p-tuning)等。他表示希望这些开源工作可以作为基础,使更多学术界和工业界的研究者能够一起来解锁这个方向上的新应用,但是需要强化代码、模型、数据等开源能力,以及高效的训练和推理支持,从而降低语音大模型的研究门槛。


开放讨论(Open Discussion)

(1)讨论话题1——语音大模型的架构和表征形式

问题描述:在语音大模型的架构方面,相比于文本大模型,语音的离散表征需要考虑文本语义之外的副语言信息的处理;语音大模型任务也有所不同,主要解决语音识别、翻译等典型问题,并以语音-文本多模态输出。同时,纯语音的端到端通用任务大模型和文本-语音的通用语音生成模型也存在不同之处;鉴于此,语音大模型是尽量沿用大语言模型(LLM)的独立解码器架构加离散语音表征,还是有必要考虑更多样的模型架构和表征方法?是尽量追求统一的通用大模型来解决文本-语音混合的所有任务,还是针对不同的类型设计专用LLM建模架构?
香港中文大学(深圳)李海洲教授认为构建统一的语言模型实现不同类型的应用,特别是可控生成(controllable production),关键在于如何产生语言模型自主生成和编写的控制参数,最好能够利用情绪、对话语境等条件控制输出。语言学家乔姆斯基(Noam Chomsky)曾说过,当我们表达或书写时,心理依赖于某种结构和转换规则将它转化为语言。因此,语音大模型解耦和编码这些信息需要结合语言方面的知识。
微软亚洲研究院刘树杰研究员表示,知识与语言的解耦是构建语音大模型的关键步骤。预测任务通常是基于token的,需要联系实际知识进行信息解耦,包括语义token和声学token,因此需要将不同层面信息/特征转化为不同token。以音乐合成为例,需要为训练和测试数据的离散token寻找一个共同映射空间。也许除了独立解码器架构,还存在其他模型架构(如扩散模型)更适合构建语音大模型,但是现阶段独立解码器架构的可行性更高。
小米科技Daniel Povey博士认为解码器结构应取决于数据的规模。类似Transformer结构的大模型在很多任务上表现差不多,但是在更小规模数据集上的表现差异很大,比如Transformer和Conformer。因此,需要将模型结构、数据量和应用场景综合考虑。大尺度Transformer架构虽然很好,但是对于小规模数据场景,也许存在更好的替代架构,这取决于推理效率需求。针对token的使用问题,他认为除非紧迫的技术方面原因,使用连续token更合适,特别是在噪声场景下。
三星中国研究院朱璇博士表示多任务才是真正的重点。三星的很多产品中,每个任务都需要特定数据、建模和训练,大模型有望解决多任务统一架构。对于工业界来说,我们希望有统一的通用模型作为基础模型,然后基于此开展一些小语种、低资源的任务,其中独立解码器结构可能更合适。通用模型也许只是学习了一些概念层面知识,比如文本大模型,因此如果将重心投放到资源受限场景设计解码器,我们就可以开展语音摘要、翻译等任意任务,通用人工智能(AGI)也更偏爱这种多任务模式,关键在于如何为这些任务设计特定的提示(prompt)。
NVIDIA陈哲怀博士表示,相对于常见的“编码器-解码器”(encoder-decoder)架构,是否使用互注意力机制是独立解码器(decoder-only)架构的明显特征。由于没有编码器,模型只需关注解码器部分,直接生成输出序列。独立解码器架构可以利用大量无标注数据进行统计模式和语义信息无监督预训练,模型进行有监督微调从而适应特定下游任务。这种模式对于长序列建模非常有效,比如机器翻译、文本生成,通常语音数据也服从长序列模式,因此采用独立解码器架构相比基于Transformer的“编码器-解码器”架构对充分挖掘语音上下文信息、开发语音大模型是更高效的。
针对语音表征学习问题,香港中文大学(深圳)武执政副教授表示语言信息和副语言信息同样重要,关键在于信息解耦,不管使用离散或者连续token。这一点从他观察到的英语母语孩子的中文学习过程也可以体会到,即使没有语言学知识和阅读基础,小孩通过日常训练也能逐渐从不同语言之间找到韵律、情感等方面的联系,从而满足中文表达的需要。所以语音中体现的语言部分使用离散token更合理,这与自然语言处理非常类似,但对于副语言信息使用离散token似乎不太令人信服,也许使用连续表征、其他更高层次的表征,甚至是更长时表征效果更好。但是目前还没有非常好的表征学习方法,可以肯定的是这个方向很有价值,其中数据收集和处理也是非常重要的。近期他们团队开展了一些电影声音转换的工作,主要从流行歌曲中收集数据,但是最终模型并不能处理京剧音频,因此除了模型架构,数据多样性也至关重要。
针对语言和语种信息融合问题,中国科学技术大学袁家宏教授表示从语言学和小孩学习语言的角度来看,关注语音表征或token化方式的同时,我们需要结合符号、单词、句子等规律,充分挖掘语言的结构化特征,因为语言是一种结构,不仅仅是简单的序列。他强调即使现如今我们通常使用注意力特征表示这些结构信息,鲁棒的语音表征也需要包含不同层级语言单元,这也为与语言学家们进行交叉合作提供了很好的机会。另外,他认为语音和文本使用不同模型或者并行顺序是不恰当的,语音的出现远比文字要早,很多语言甚至没有文字,因此对于语言模型,语音是主要的,文本是次要的,文本包含了许多语言结构信息,这些信息是声学特征不具备的。理论上配对的语音和文本训练数据所能学习到的信息都可以从纯语音(speech-only)数据获取,这就是语言交流的本质,但是通常模型的建模能力有限,实际中我们依然需要文本辅助。
训练语音大模型主要数据源包括语音和文本,由此可以得到两种策略:1)一种是使用语音作为主要数据源,大语言模型作为后置模块处理辅助任务,2)另一种是选择不同类型的离散符号化方法(tokenization)和表征,建立统一的大语言模型处理所有任务。主要和次要之分涉及到语音大模型的结构选择问题,语言学家的观点似乎表明语音包含了一切、语音才是主要信息源,文本只需起到辅助纠正作用即可。
对此,上海交通大学陈谐副教授表示这两种方案并不是互斥的,选择何种思路取决于研究目标,不过毫无疑问自监督学习是非常重要的。对语音识别、理解类任务而言,从性能角度看连续表征/token会比离散的更有效,因为连续表征决定了模型的性能上限,但是离散表征/token可以节约存储、加速推理,且与自然语言模型联系更紧密。实际中应结合经验和需求表示音频、语音、情感、音乐等数据,从而为自监督表征学习模型处理不同信号选择合适准则。他认为从生成角度看,选择独立解码器或者离散token的主要原因是它可以与大语言模型协作,改进已有任务或者探索一些新的任务。另外,连续token可能非常适合扩散模型,因为扩散模型可以产生更多样化输出结果,离散采样方式也可以提升数据多样性。
针对通用模型和通用表征学习等问题,昆山杜克大学李明副教授认为基于一个给定的自监督学习模型稍作改动并集成多个下游任务,并没有充分挖掘副语言信息和利用任务特点。不管下游应用类型是什么,这种方式变向为离散token系统带来了一种机会,特别是如果需要一些反馈控制(比如在codec得到符号之前生成离散token)关联说话人、情感等因素时。例如,Sidecar模型(混合说话人语音分离器)包含一个被冻结的单说话人语音识别(ASR)模型,可以利用该ASR模型提取中间层级表征结合分离器实现多说话人识别和说话人日志等,也就意味着大模型可以降低任务设计的复杂度,比如说话人日志完全可以利用说话人相关ASR方法替代,将来的主要工作可能是结合下游任务微调(fine-tune)模型。
因此,与会专家的普遍共识是自监督表征学习固然重要,利用已有的大模型(比如基于监督训练的ASR模型)提取中间层表征相对于自监督学习可能对某些任务(比如说话人日志、说话人识别)更有益,这也是非常有趣的研究方向之一,因为某些中间层表征可能包含更多的说话人声纹、情感、意图等特定信息。对于大模型的架构以及token表征方式,中国科学技术大学张结副研究员进一步补充探究更多大模型不能完成的任务是比较有价值的研究方向,比如如何与脑信号、助听/辅听感知任务结合、端云协同改善端侧语音任务的应用性能等。
针对离散或连续token表征问题,中国科学技术大学凌震华教授认为使用离散或者连续token应取决于系统(包含多个模块)在哪个层级设置转化接口,比如语音合成旨在将离散文本转化为连续语音,这就是离散token的映射过程。因此,我们需要在语音重构性能与模型复杂度之间做出取舍,对于这个问题也许没有统一答案,依赖于我们所使用的工具和技术。如果拥有更强的语言建模能力,或许可以直接预测连续语音表征;如果有了更强的离散重构功能,我们可以使用token层面表征。
关于语音大模型架构和表征学习问题,名古屋大学Tomoki Toda教授认为生成模型和生成机理很重要,比如语音生成需要定义一些概念(concept)约束语音,语言表征主要包含口语和书写两类,二者形式上虽然存在很大差异,但是也许共享相同概念。这意味着可利用生成式模型产生表征,基于此可以灵活定义离散或者连续token,以及对token进行尺度约束,这将会是很有趣的研究工作。对于主要数据源问题,我们首先需要录制大量主要数据,其次为多模态数据建立互概率关系,例如前期他们团队在研究歌声合成问题时,虽然没有这类数据,但是依然可以通过设计多模态信号与语音情绪信息之间的连接调节合成效果。因此开发新功能时,关键在于为语音和额外信号建立可靠连接,可行的解决办法是强化迭代学习(reinforce iterative learning),结合模拟仿真环境(比如仿真人体动作、姿态),从而挖掘语音和多模态系统更好的连接潜力。仿真可以产生大量多模态数据,包含任何背景和语境的,这与大语言模型产生文本数据过程类似,其中控制参数是关键。
话题共识:针对语音大模型的语音表征学习问题,知识与语言信息的解耦和编码、生成任务的参数控制是影响自监督表征学习的关键步骤,离散或连续token应结合数据模态、语言学层面结构化特征、表征转化接口层级综合设计;针对语音大模型架构问题,与会专家普遍认为独立解码器架构是现阶段最便捷最可行的研发途径。

(2)讨论话题2——语音大模型的智能涌现
问题描述:当我们见识到ChatGPT可以基于大语言模型产生长文本时,人们意识到这不仅仅是简单的提问和回答的过程,这已经体现出类似逻辑推理能力。因此,类比LLM的智能涌现(emergence of intelligence),我们是否可以预测将来语音大模型也存在类似能力,以及在哪些方向上有可能进一步挖掘其应用潜力?
针对大模型的智能涌现,微软亚洲研究院刘树杰博士认为智能涌现的定义是模糊的,比如我们利用多个说话人语料训练一个语音合成TTS模型时,如果该模型可以自动调整特定说话人合成语音的语速,这也许是涌现的智能之一。他认为大语言模型或基于自监督学习的大模型应是可以压缩数据的模型,并且即使在给定未见过的(unseen)输入数据情况下也能合理聚类和分类,这也是大模型涌现出来的智能。或许自监督学习技术的使用是智能涌现的原因,其团队曾尝试训练语音识别和合成的多任务模型,期望该模型可以自发迁移于其他说话人,但是当前模型没有这种能力,目前只在说话人声音转换任务上见到了大模型的智能涌现,但本质上还是大模型超强的聚类能力,以及对已知训练数据和任务的组合能力。Daniel Povey博士补充道,如果一个模型可以处理任何任务,包括训练阶段没见到的任务,这才能称之为大模型的智能涌现。
上海交通大学俞凯教授表示,事实上人们谈论基于文本的大语言模型的智能涌现通常包含两层含义:1)小模型不曾具有的能力,或者说只有当数据量达到一定程度时小模型才具有的能力;2)不易解释和令人震惊的能力,已经超出了我们对机器智能的想象。自监督学习带来了聚类能力,促使大模型能够对任何输入数据与类别进行匹配,这其中组合关系也许会让我们看到一些特殊现象。对此李海洲教授认为这只是数量和质量之间的关系,当模型的训练数据量达到一定阈值、已学到很多信息,你就可以以更好的方式组合信息,这就与人的学习和练习过程类似,这是自然而然的趋势。
三星中国研究院朱璇博士表示研究大模型的体会是参数量是个重要阈值,通常大模型具有百亿以上参数,只有模型足够大和数据足够多才有智能涌现的可能,因为参数来源于数据,目前大模型还停留在从未知数据到已知训练数据类别的映射阶段。从产业应用角度看,我们更希望构建多语种统一大模型。比如一种语言最多有16个声调,但是我们目前接触到的数据通常是英文、汉语、法语等大语种,相比于全球范围内其他小语种这些语言的声调相对较少,当我们处理多语种翻译或识别任务时,有些语种不仅数据量非常稀缺,甚至没有自身音素集合,因此如果语音大模型能利用统一音素集合覆盖世界上所有语种,处理多语种多任务,这就是大模型的智能涌现之一。
中国科学技术大学袁家宏教授期望大模型的智能涌现能够做两件事情:1)如果对完全未知的语言收集100或1000小时语音数据,大模型能够输出该语言的语法结构、词典等信息,这与语言学家学习新语言的过程类似,即使大模型只利用几种特定语言的语音、声调、词典等输入,大模型依然可以告诉你未知语言的进化过程;2)大模型可以帮助我们理解大脑处理信息的过程,比如从大模型中可以学习某些知识、神经元相互作用机理、不同层级表征与人脑神经元的对应关系,因此利用大模型理解人类语音产生和感知机理或许是大模型的智能涌现之一。基于语音或文本大语言模型分析人脑神经元处理语音任务的归纳与扣除规则也是大模型时代非常有趣的研究方向之一。
NVIDIA陈哲怀博士从工业角度进一步认为基于大模型的二次开发也可视作智能涌现之一。NVIDIA曾尝试将所有语音、说话人等数据输入大模型进行训练,期望大模型能够评估所有潜在信息。如果我们将大模型视作新型计算机的CPU,就可以基于此设计很多下游任务,就像基于CPU开发应用软件那样,这可能也是研发大模型比较好的思路。另外,开源的大模型无需再重复训练,只需利用它做相关研究工作的二次训练即可,但是训练大模型的成本是非常昂贵的。
阿里巴巴通义语音实验室鄢志杰博士说语音合成任务上情感和重音的高表现力可以算作智能涌现之一。回到我们最初建立人工智能系统这个老话题,我们期望机器能够自然地流利地应答问题,那时候我们的做法是将问题分解为不同子模块,比如起初针对单个说话人录制不同情感语料,语音合成系统并不能选择使用哪种情绪合成语音;另外,传统合成系统没有自动切换合成语音情感的能力。现在有了大模型,我们至少看见了一些稳定的进展,例如基于海量数据的情感语音合成系统可能获得更加自然的输出结果,未来大模型利用更长上下文信息对提升语音合成系统的自然度和个性化会起到促进作用,至少对这个研究方向应保持乐观态度。对此,俞凯教授补充道在情感语音合成任务上大模型的确涌现出一些智能,比如可以合成出训练情感类别之外的情感语音,这是前期语音合成领域未曾出现的,与大模型和大数据的使用密切相关。
陈谐副教授认为预处理任务可能是提升大模型智能的有效途径之一,比如token或单词的预测,当前有很多基于HuBERT、word2vec、data2vec自监督预训练模型的预处理任务工作,但至今仍然没有证实通用表征在多数任务上较传统语音特征表现更好,因此探索更合适的语音和音频信号的预处理任务尚待进一步研究。与文本大模型(只有任务,固定当前token,预测下一个token)的不同之处在于,语音信号存在很多特殊性,需要考虑不同的预处理任务反映出语音处理和生产特性,由此或许可以激发出更多预训练方式和智能涌现能力。最后,张结副研究员补充说语音、文本、图像、视频都可以视作信号,信息论、信源信道编码等信号处理理论也许有利于寻找更合适的表征学习方法,促进大模型涌现出更多的智能。
话题共识:界定语音大模型智能涌现的难点在于定义“智能涌现”,现阶段语音大模型在类CPU功能属性和合成语音表现力上展现出一定的智能,但还没有体现出类人语音感知和理解的逻辑推理智能,精细的预处理任务、理论学习等是潜在的提升大模型智能的方式,但本质上还是量变到质变的过程。

整理编辑:张结,凌震华,俞凯