
 语音小管家
Unified Cross-Modal Attention: Robust Audio-Visual Speech Recognition and Beyond
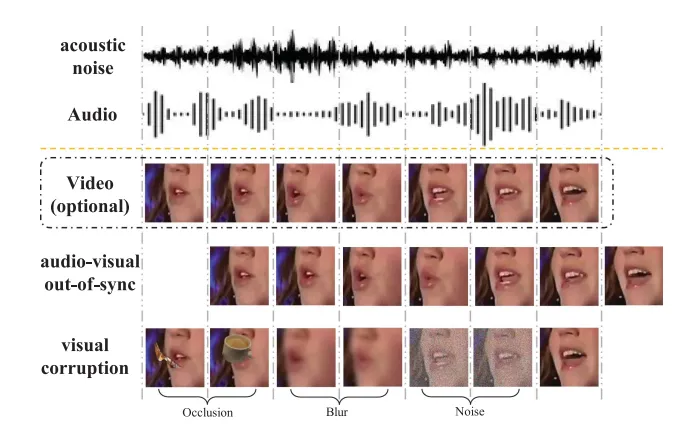
音视频多模态语音识别(Audio-Visual Speech Recognition)旨在借助唇部动作等视觉信息提升复杂声学环境下的语音识别精度。相比于语音信号,视觉媒介更不易受到环境的干扰,因此在以“鸡尾酒会”为代表的复杂环境中,音视频多模态语音识别能够表现出更稳定的识别性能。
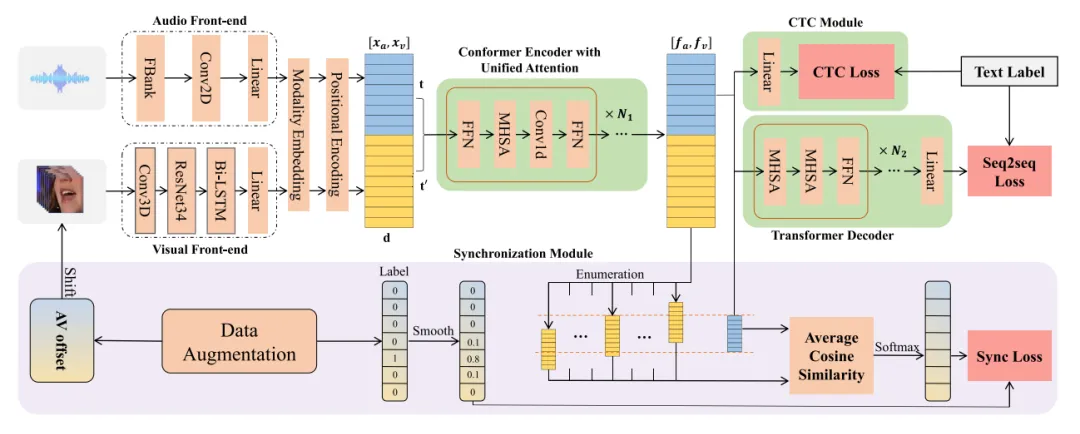
我们首次在音视频识别系统中采用了统一跨模态注意力机制,取得更好的模态融合效果 我们考虑视听场景中潜在的多种类型的低质量输入场景,设计相应的辅助优化方案,使模型具有更强的鲁棒性 我们在保持轻量模型尺寸的同时,提出了启发式的注意力对齐策略,进一步降低模型的计算开销
启发式跨模态注意力对齐策略
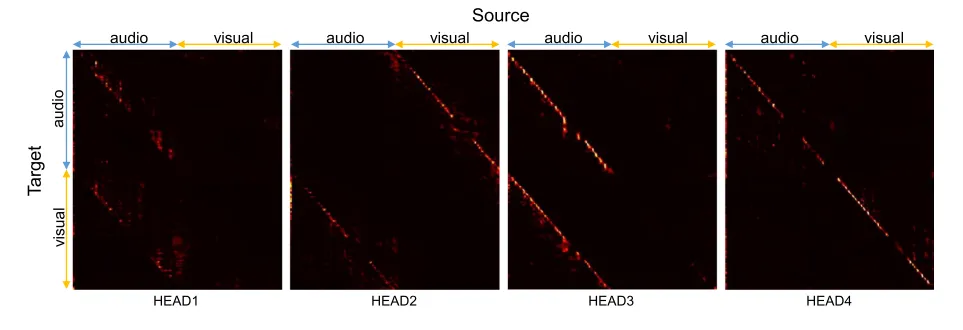
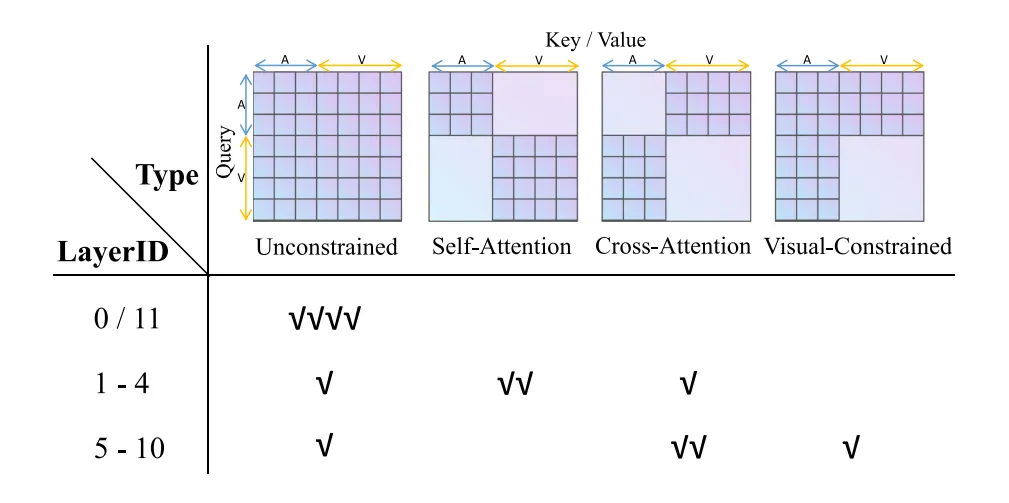
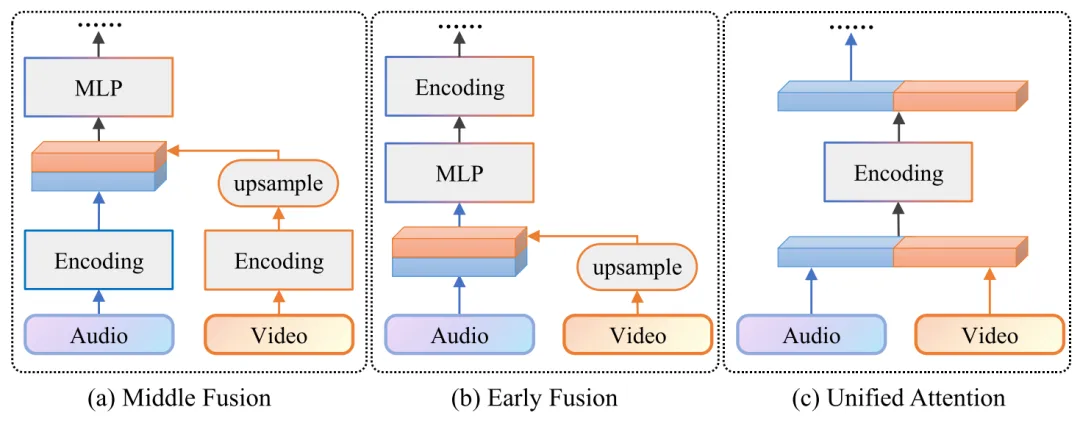
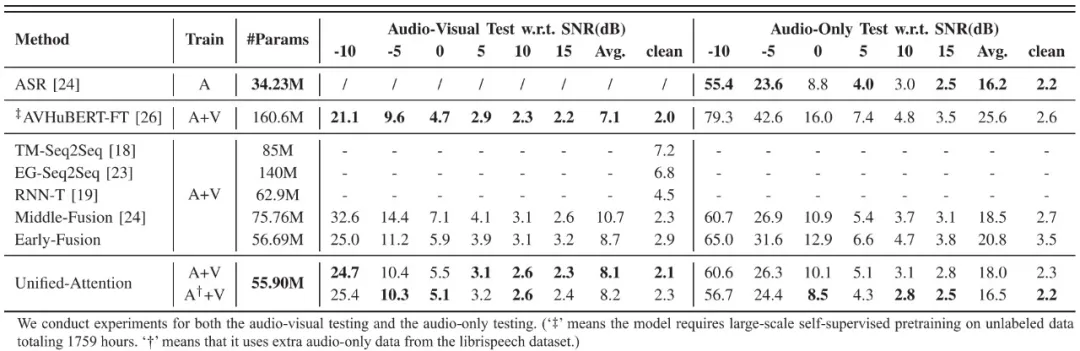
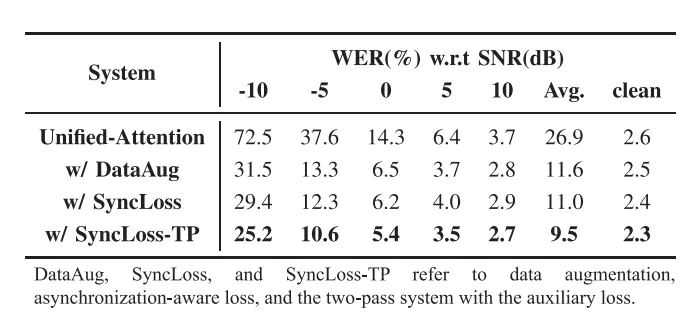
噪声环境下的不同的语音识别系统对比
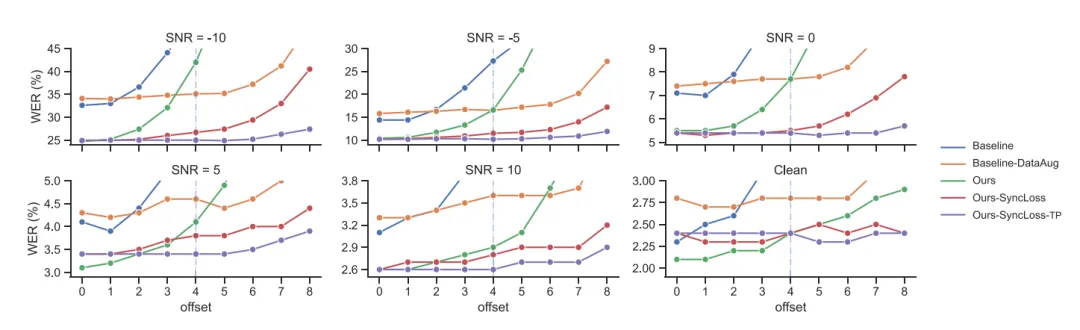
音视频不同步对识别性能的影响
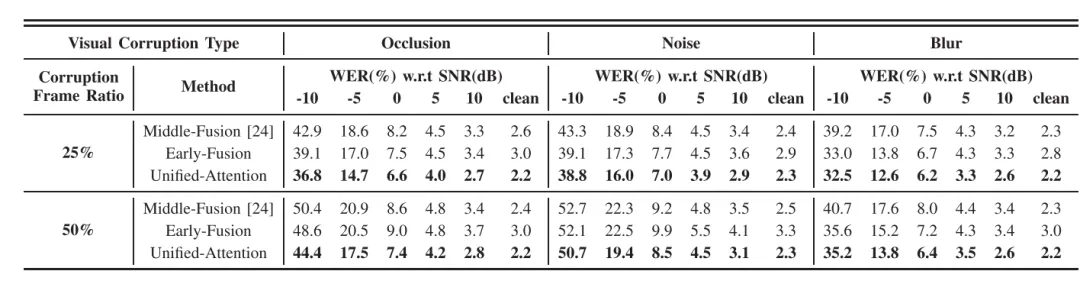
零样本低质量视觉数据的影响
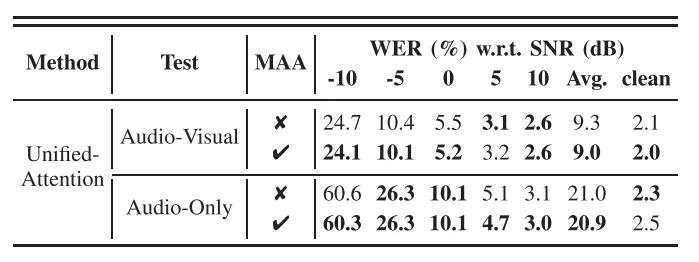
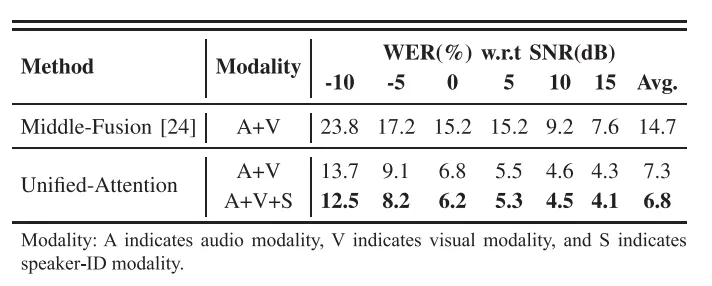
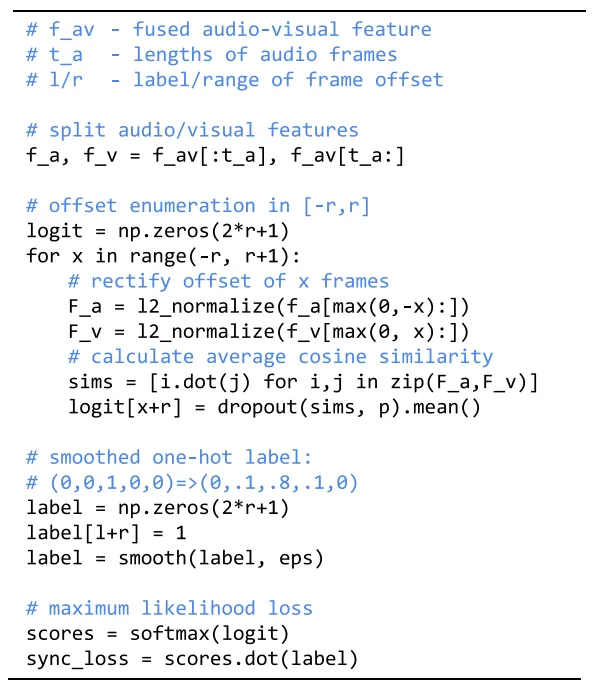
本论文中,我们提出了基于统一跨模态注意力机制的音视频多模态语音识别系统,借助视觉模态中的唇部动作信息提升嘈杂环境下的语音识别性能。在文中,我们还提出了音视频同步性感知训练的策略,既显著缓解了音画不同步对系统性能的负面影响,也能直接用作音视频偏移量的预测任务。此外,我们设计的启发式的模态间注意力对齐方案能够显著降低多模态交互的计算复杂度,并带来进一步的性能增幅。基于以上策略,在LRS3数据集上,我们提出的系统凭借最低的模型参数量和计算复杂度取得了不同噪声环境下的最优性能,并且对于模态缺失、音画不同步、视觉干扰等特殊场景都具备较好的鲁棒性。
[1] Petridis, Stavros, Themos Stafylakis, Pingchuan Ma, Georgios Tzimiropoulos, and Maja Pantic. "Audio-visual speech recognition with a hybrid ctc/attention architecture." In 2018 IEEE Spoken Language Technology Workshop (SLT), pp. 513-520. IEEE, 2018.
[2] Zhou, Pan, Wenwen Yang, Wei Chen, Yanfeng Wang, and Jia Jia. "Modality attention for end-to-end audio-visual speech recognition." In ICASSP 2019-2019 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), pp. 6565-6569. IEEE, 2019.
[3] Ma, Pingchuan, Stavros Petridis, and Maja Pantic. "End-to-end audio-visual speech recognition with conformers." In ICASSP 2021-2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), pp. 7613-7617. IEEE, 2021.
[4] Shi, Bowen, Wei-Ning Hsu, and Abdelrahman Mohamed. "Robust self-supervised audio-visual speech recognition." arXiv preprint arXiv:2201.01763 (2022).
[5] Li, Jiahong, Chenda Li, Yifei Wu, and Yanmin Qian. "Robust audio-visual ASR with unified cross-modal attention." In ICASSP 2023-2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), pp. 1-5. IEEE, 2023.
[6] Afouras, Triantafyllos, Joon Son Chung, and Andrew Zisserman. "LRS3-TED: a large-scale dataset for visual speech recognition." arXiv preprint arXiv:1809.00496 (2018).
