语音小管家
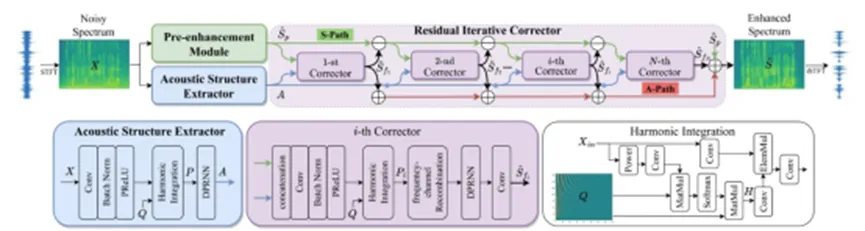
VoiCor: A Residual Iterative Voice Correction Framework for Monaural Speech Enhancement
论文作者:曹瑞、王天锐、葛檬、李安冬、王龙标、党建武、 贾云刚
论文单位:天津大学 新加坡国立大学 腾讯AI Lab 国家计算机网络应急技术处理协调中心天津分支
论文介绍:监督语音增强从神经网络的最新进展中获得了重大进展,特别是由于它们能够非线性地拟合目标语音的各种表示,例如波形或频谱。然而,它们中的大多数在具有挑战性的声学场景中仍然面临语音质量下降和残留噪声的问题。在本文中,为了缓解上述问题,我们提出了一个残差迭代语音校正框架,以进一步校正现有增强解决方案预增强的语音的声学结构。具体而言,受信息链式法则的启发,我们以残差迭代的方式执行多次校正,以细化预增强语音的频谱结构细节。在 DNS-Challenge 数据集上的实验结果表明,我们的解决方案在仅增加 1.18 M 个参数的情况下,相比基线持续提高了 0.3+ PESQ 分数。
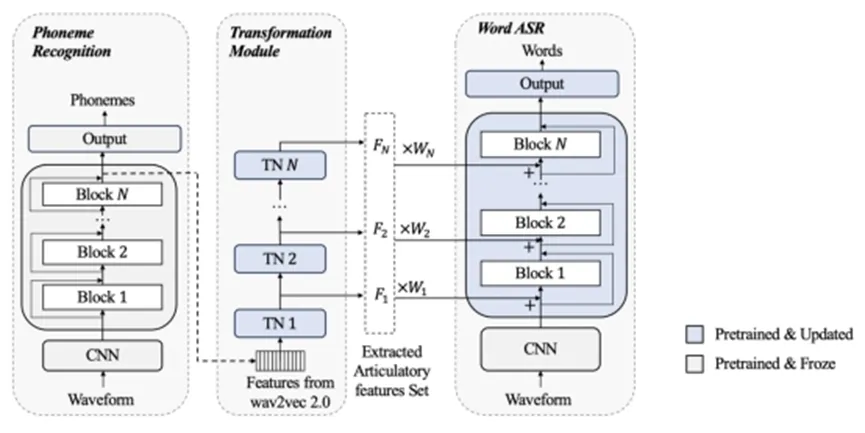
Exploring Pre-trained Speech Model for Articulatory Feature Extraction in Dysarthric Speech Using ASR
论文作者:林羽钦、王龙标、党建武、Nobuaki Minematsu
论文单位:天津大学、东京大学、慧言科技(天津)有限公司、深圳先进技术研究院
论文介绍:大多数语音技术对正常说话者是有益的,但对有语音障碍的说话者效果较差。构音障碍是一种运动语言障碍,涉及到语言产生过程中的一些障碍。因此,发音信息对这一特殊群体非常重要。然而,由于发音标注方面的挑战,发音特征难以提取。最近的研究探索了Wav2vec 2.0预训练语音模型中的音位特征,发现它们携带了一些发音相关的信息。在此基础上,本文提出了DS-AAFE方法,从基于音位特征的预训练语音模型中提取更准确的发音特征。在DS-AAFE中,通过与ASR联合优化,将部分发音特征从音位特征中分离出来。使用发音属性检测对所提特征中的发音信息进行评估,发音属性检测的准确性显著提高。此外,在UASpeech和TORGO构音障碍数据集上的实验表明,所提出的特征提高了构音障碍语音的ASR性能。
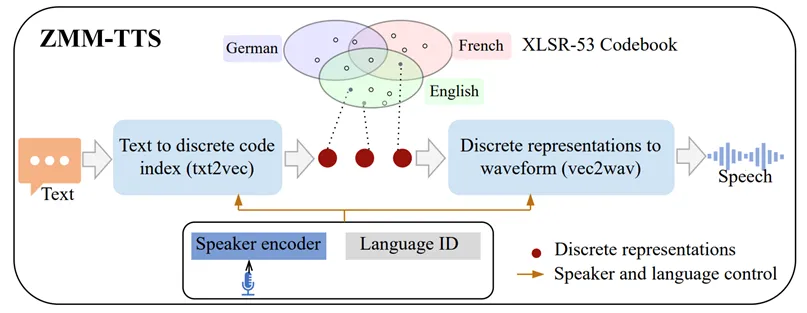
An Initial Investigation of Language Adaptation for TTS Systems under Low-resource Scenarios
论文作者:贡诚、Erica Cooper、王鑫、强春雨、Mengzhe Geng、Dan Wells、王龙标、党建武、Marc Tessier、Aidan Pine、Korin Richmond、Junichi Yamagishi
论文单位:天津大学、日本国立情报学研究所、加拿大国家研究委员会、爱丁堡大学、日本国立信息通信技术研究所
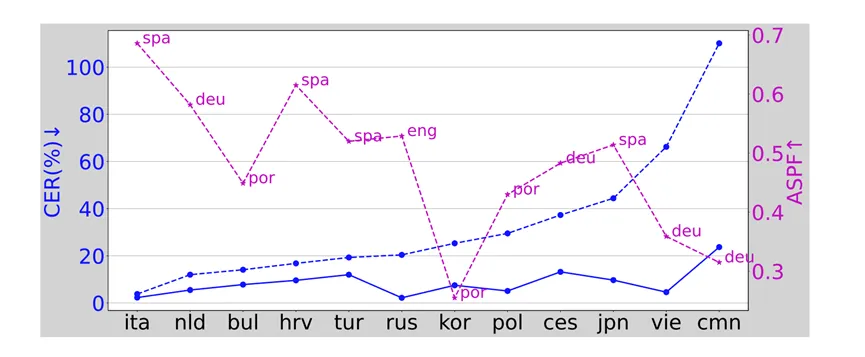
论文介绍:利用规模多语言数据自监督学习(Self-supervised learning,SSL)的模型中学习到的跨语种表示为低资源语种的语音处理提供了一种有前景的解决方案,然而,语音合成(Text-to-speech, TTS)系统对于不同语种的适应仍然是一个开放问题。本文在我们之前提出的基于离散SSL表征的多语种多话者合成系统ZMM-TTS上,探究了其对不同语种的适应能力。本文利用有限的训练数据,在12种语言上,进行了多组不同微调策略的实验。实验结果展示了预训练语言和目标语言之间的语音相似性以及语言类别会影响目标语言的适应性能。此外,本文还发现微调数据集的大小和说话人个数也会影响模型的适应能力。令人惊讶的是,从实验结果还可以观察到,使用配对数据进行微调并不总是比仅使用音频数据更优。除了语音可懂性之外,本文的实验评估还涵盖了说话者相似度、语言识别和预测的主观质量评分(MOS)。
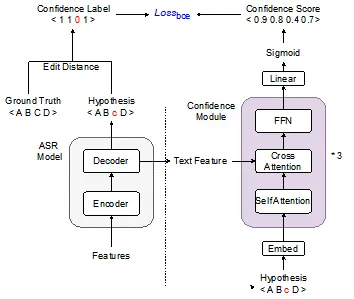
Error Correction by Paying Attention to Both Acoustic and Confidence References for Automatic Speech Recognition
论文作者:舒钰淳、胡泊、何一峰、史昊、王龙标、党建武
论文单位:天津大学、百度、日本京都大学、慧言科技(天津)有限公司、中国科学院深圳先进技术研究所
论文介绍:语音纠错任务的目标是在语音识别(ASR)假设中准确地找到错误的词并将其正确恢复。在语音纠错任务中,往往存在以下几个挑战。1:语音识别的错误比较稀疏,通常错误率不到10%,模型必须精准地找到并修改这些错误,同时避免修改正确的单词。2: 错误纠正的参考信息是什么,正确的结果如何得出。3: 推理速度应该尽可能快,满足工业部署要求。4: 当纠错模型采用非自回归生成方式时,如何恢复删除错误导致的丢失字符,实现可变长的纠错。