分享上交大听觉认知与计算声学实验室6篇被SLT 2024收录的论文,论文方向涵盖目标语音提取,声音异常检测,多语种语音识别和语音增强等。1、DISCRIMINATIVE DIFFUSION MODEL FOR TARGET SPEECH EXTRACTION
用于目标语音提取的判别扩散模型
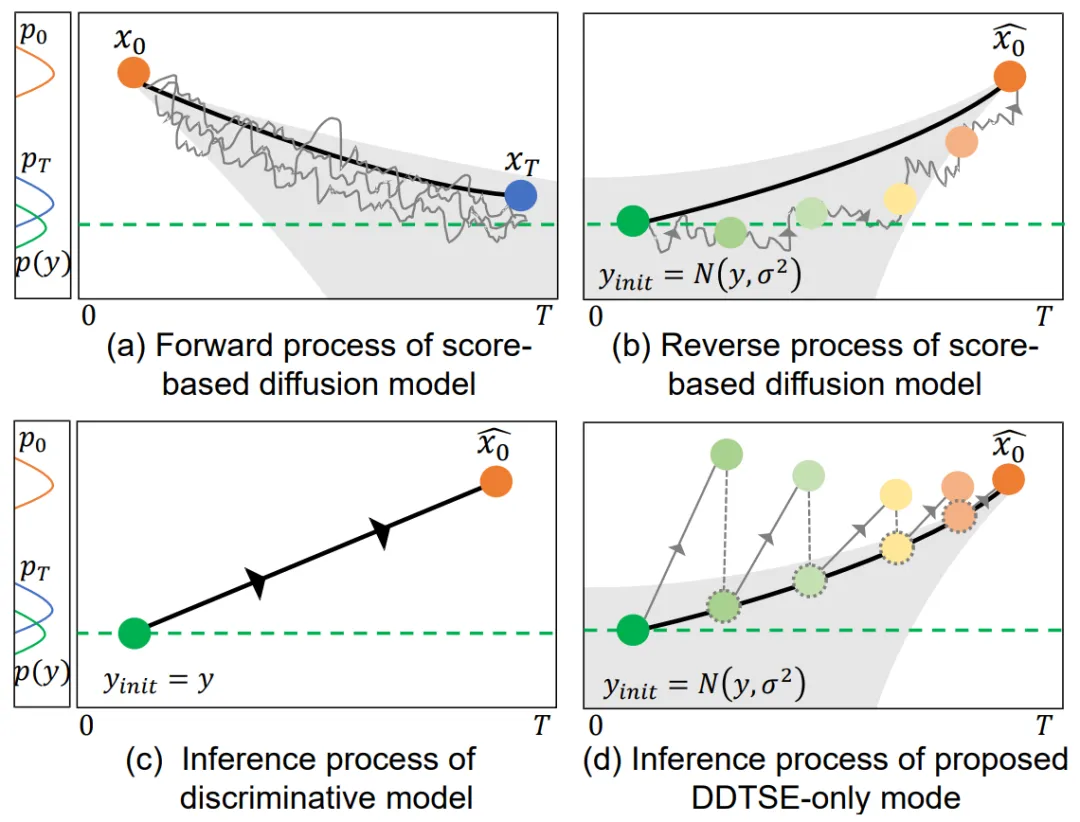
论文作者:张乐莹,钱瑶,余林峰,王鹤鸣,杨和敏,刘树杰,周龙,钱彦旻该论文提出了一种用于目标语音提取的全新模型:判别扩散模型(DDTSE)。该框架采用与扩散模型相同的前向过程,并使用类似于判别方法的重建损失。该模型具有两阶段训练策略,不仅可以作为独立的系统运行,还可以在不进行额外训练的情况下进一步提升判别式模型的性能。与传统的扩散模型相比,DDTSE不仅在感知质量上有显著提升,还将推理速度提升了3倍。判别式模型和生成式模型是用于语音增强和目标语音提取任务的两种不同方法。前者学习输入和输出之间的最佳映射,而后者学习目标分布,能生成多个估计结果。尽管判别式模型在以往研究中取得了诸多进展,但在面对未见过的噪声类型或说话人时,它偶尔会表现出有限的泛化能力。生成式模型,尤其是扩散模型,在生成自然和多样的语音方面有更强的能力。然而,扩散模型需要多步迭代导致推理速度过慢,且其正向过程与反向过程之间存在差异,可能导致模型性能的下降。为了克服这些问题,我们提出了判别扩散模型,该模型结合了扩散模型的正向过程与判别式模型的训练目标。我们设计了两阶段的训练方法,第一阶段学习如何在给定目标说话人嵌入的条件下提取干净语音,第二阶段则旨在弥合训练和推理之间的差异。我们提供了两种使用模式以提升灵活性,其中DDTSE-only作为独立系统运行,实现端到端目标语音提取,而X+DDTSE通过修正现有判别式模型来提升整体系统性。我们的大量实验表明,DDTSE在感知质量上优于判别方法,尤其在嘈杂环境下。此外,当与现有模型集成时,它超越了单独的判别式模型,展示出作为即插即用模块的潜力。DDTSE不仅适用于多说话人和单说话人场景,还能有效处理环境噪声。我们设计了两阶段训练过程。第一阶段学习如何在给定目标说话人嵌入的条件下提取干净语音,第二阶段则旨在弥合训练和推理之间的差距。更多样例:https://vivian556123.github.io/slt2024-ddtse/
2、IMPROVING ANOMALOUS SOUND DETECTION VIA LOW-RANK ADAPTATION FINE-TUNING OF PRE-TRAINED AUDIO MODELS
使用低秩微调音频预训练模型改进声音异常检测
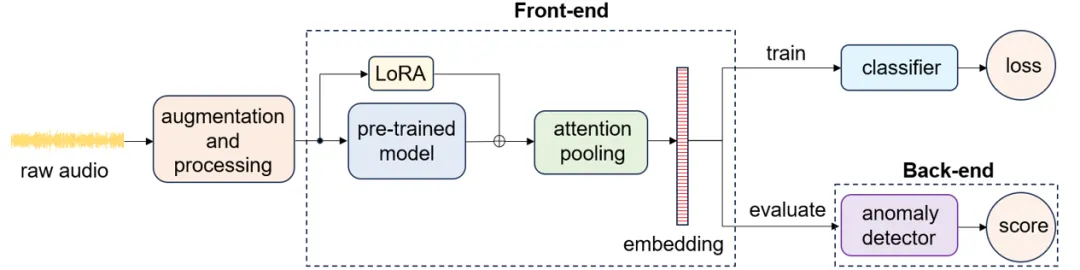
论文作者:郑欣虎,姜安柏,韩冰,钱彦旻,樊平毅,刘加,张卫强本论文提出了一种改进的异常声音检测(ASD)模型,利用音频预训练模型和低秩适配(LoRA)微调技术来解决数据有限的问题。通过在DCASE2023 Task2数据集上的实验,该方法在评估集上取得了平均AUC分数77.75%的新基准成绩,相比于以往的最先进模型提高了6.48%。研究显示,利用LoRA调优的预训练音频模型在异常声音检测任务中具有显著优势,实验还通过消融研究展示了该方法的有效性。工业自动化中,异常声音检测(ASD)对于维护设备运行完整性至关重要,但由于数据收集困难和环境因素复杂,使得ASD系统在实际生产环境中难以广泛应用。与传统的音频或语音任务不同,ASD任务需要系统区分正常操作噪声与潜在的异常声音,这要求模型深入理解特定环境中的正常声音特征。虽然已有研究探索了包括自监督学习在内的多种方法来提升ASD的准确性,但仍面临挑战,如数据标注不足和领域迁移问题。本论文首先在DCASE2023 Task2数据集上微调不同主流的预训练模型进行对比,包括语言预训练模型Wav2Vec2,Qwen-Audio和音频预训练模型BEATs和CED,发现在Audioset上预训练的音频模型具有显著性能优势,同时提出了一种创新方法,通过对预训练音频模型进行微调,并结合数据增强策略SpecAug来提升模型性能,并首次将低秩适配(LoRA)应用于预训练音频模型的微调,以应对有限数据和领域偏移的问题。实验结果表明,该方法在DCASE2023 Task2数据集上达到了当前最先进的性能,显示了预训练音频模型和LoRA调优的有效性。
3、JOINT DISTILLATION AND QUANTIZATION FOR EFFICIENT MULTILINGUAL SPEECH RECOGNITION
联合知识蒸馏和网络量化的高效多语种语音识别
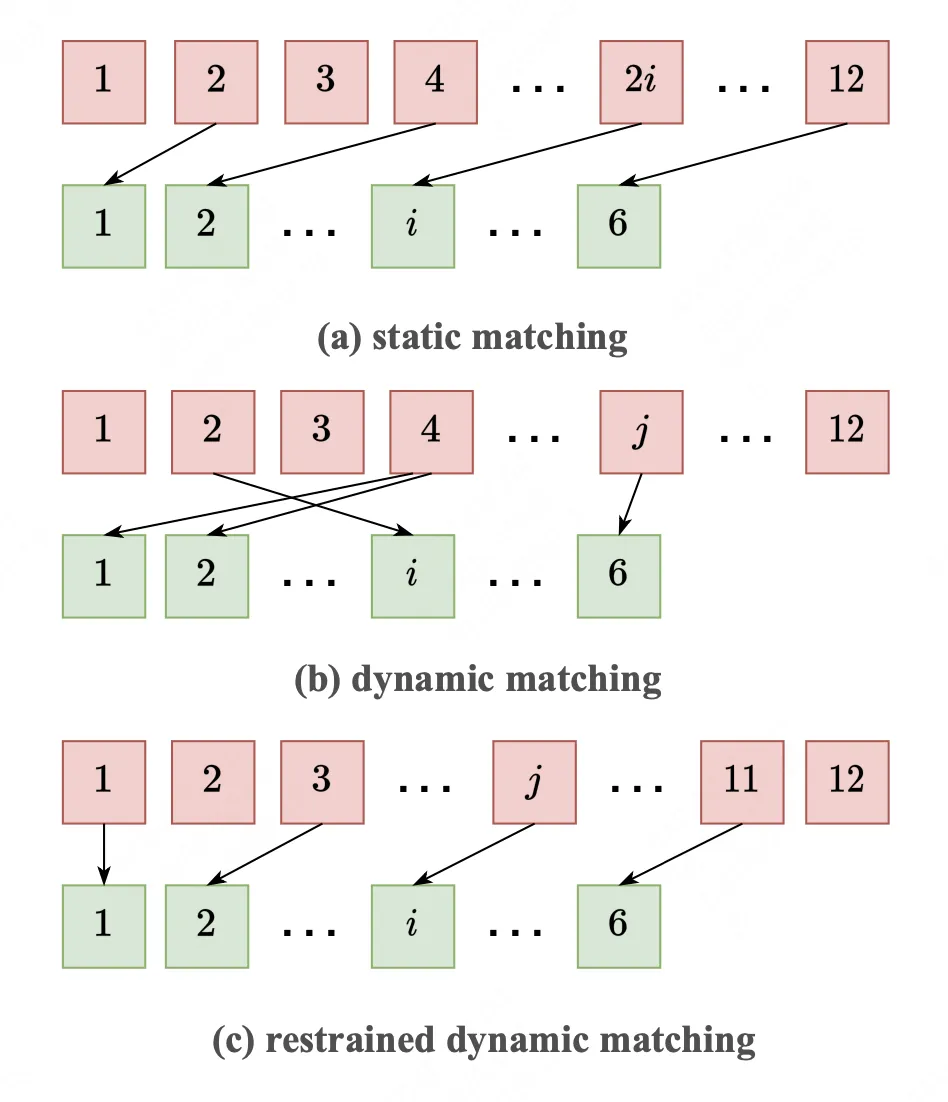
为了提升小型 Whisper 模型的多语种处理能力,我们提出了一种名为 DQ-Whisper 的新颖轻量化框架,结合了知识蒸馏与网络量化技术,旨在压缩模型并提高推理效率。首先,我们引入了一种动态匹配的知识蒸馏策略,随后通过量化感知方法将量化与知识蒸馏有机结合。该框架在不增加计算开销的前提下,有效提升了小型 Whisper 模型的多语种表现。尽管性能略有下降,模型体积最多减少了 5.18 倍。此外,我们还发现网络量化与知识蒸馏具有互补性,能够进一步提升压缩效果。近期研究表明,Whisper 模型存在“多语种诅咒”现象,即在不同语种的语音识别中,特别是在资源匮乏和中等资源的语种上,大规模参数的 Whisper 模型与其较小版本之间存在显著性能差距。提升小型 Whisper 变体的多语种语音识别能力已成为一个关键且紧迫的挑战。为此,本文提出了一种名为 DQ-Whisper 的新颖框架,结合了知识蒸馏与网络量化技术,旨在在实现高效推理的同时,保持模型的多语种处理能力。我们首先设计了一种动态匹配蒸馏策略,不同于以往的方法,我们的方法能够从教师网络中选择合适的层次来引导学生网络的学习。接着,我们将量化感知的蒸馏框架引入其中,将量化与蒸馏有机结合。实验结果表明,在多个多语种数据集上,DQ-Whisper 可以在不增加计算成本的前提下显著提升小型 Whisper 模型的多语种能力。模型体积缩小了 5.18 倍,性能仅有轻微下降。此外,将蒸馏与量化结合,能够在保持模型性能的同时进一步提高压缩效率。在 COMMONVOICE 数据集上的评估结果也验证了我们的方法可以有效压缩 Whisper 模型,同时保留其多语种语音识别的能力。
4、Diffusion-based Generative Modeling with Discriminative Guidance for Streamable Speech Enhancement
使用判别式指导的在线扩散生成式语音增强
论文作者:李晨达,Samuele Cornell,Shinji Watanabe, 钱彦旻
完成单位:上海交通大学,卡内基梅隆大学
论文亮点
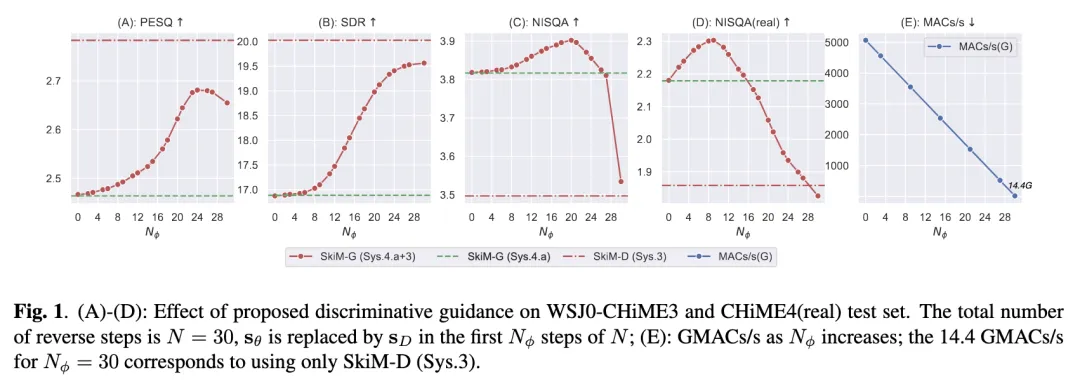
本文的主要贡献包括:1)我们首先尝试使用扩散模型来构建在线语音增强系统。为了减少推理过程中的计算开销,我们创新性地提出了梯度指导方法。在扩散模型的推理过程中,我们利用判别模型对数据的梯度进行粗略估计,得到判别模型的输出结果后,这种估计不再需要任何神经网络的参与,从而大幅降低了推理过程中的计算开销;2)实验证明,这种梯度指导的方法在部分评测指标上可以达到超过原始两类模型的效果;3)我们采用跳跃记忆网络(Skipping Memory, SkiM),并重新设计了扩散模型的网络结构,构建了可用于流式推理的在线生成式语音增强模型。与离线基线系统相比,我们提出的模型在在线处理时能保持相当的性能,算法延迟仅为50毫秒。
基于扩散的生成模型在语音增强研究中越来越受到关注。与传统的判别式方法相比,生成式模型展示了更强的泛化能力。然而,扩散模型在推理过程中需要多次迭代,导致计算开销巨大,限制了其在在线语音增强中的应用。本文提出了一种利用判别式模型指导生成式语音增强的方法。在推理过程中,仅需一次判别式模型的传播即可近似计算多步迭代的数据梯度,从而大幅减少扩散模型的计算开销,使得实时在线语音增强成为可能。我们提出了一种新颖的可流式处理的生成式语音增强模型,其算法延迟仅为50毫秒,与离线模型相比,性能没有显著下降。另一方面,实验还证明,结合了判别式指导的生成式语音增强模型,在部分指标的评测下表现出了相较于原始的两类模型更好的性能。
5、Enhancing Speaker Extraction through Rectifying Target Confusion
通过纠正说话人困惑现象增强目标说话人提取性能
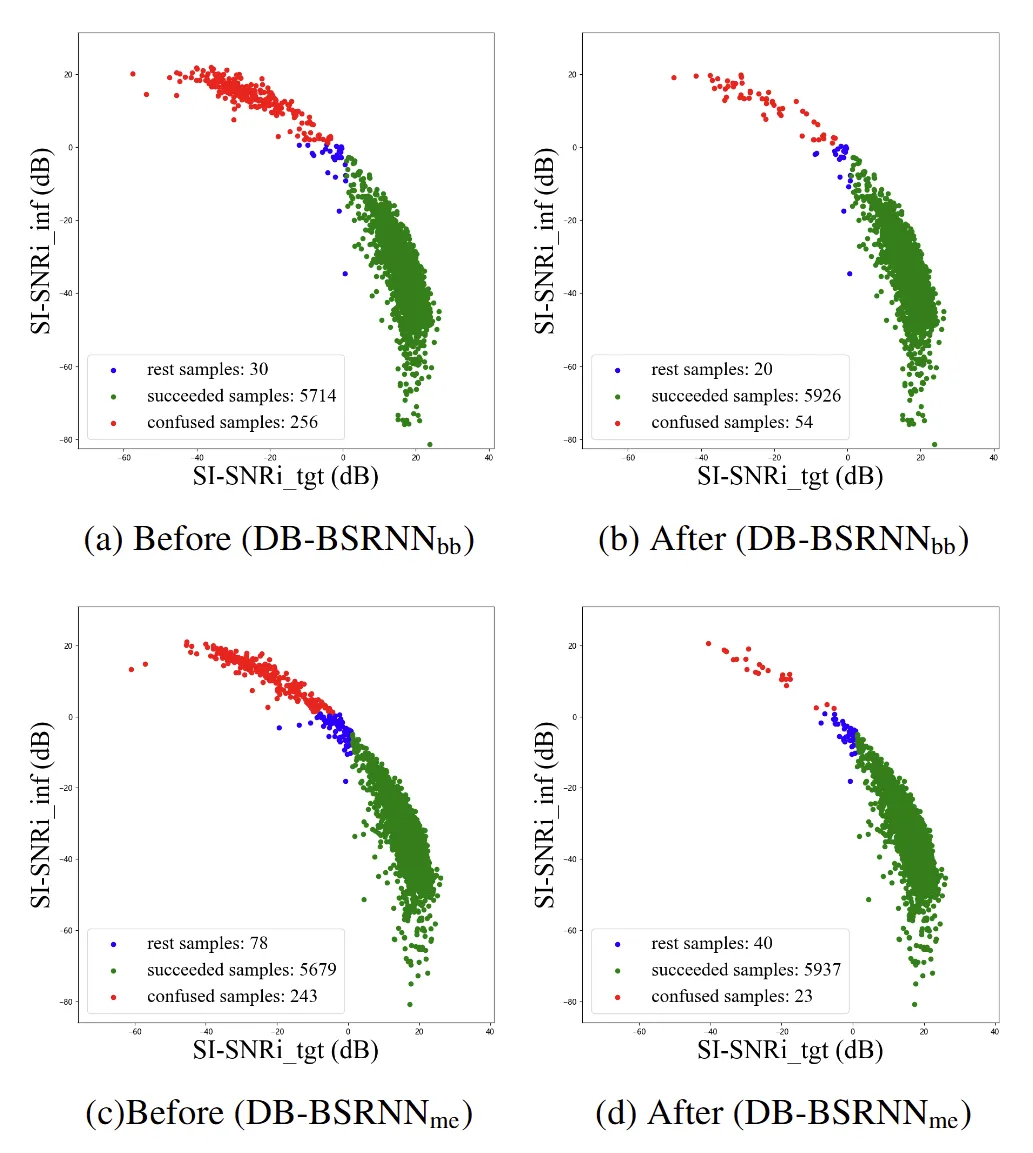
论文作者:王嘉禾、王帅、李俊杰、张克、钱彦旻、李海洲完成单位:上海交通大学、深圳市大数据研究院、香港理工大学、东北大学、香港中文大学(深圳)该论文针对目标说话人提取(TSE)任务中常见的问题——说话人困惑现象(Target Confusion Problem,即目标说话人提取模型输出了纯净的干扰语音信号)提出了一种全新的双分支模型架构和后处理纠错机制。模型首先通过同时提取和抑制目标语音以增强音色建模能力,之后在推理阶段对发生说话人困惑现象的样本进行纠正。在Libri2Mix(mix_clean)和Libri2Mix(mix_both)数据集下,模型相比使用了相同主干的单分支基线,均大幅提升了提取性能,尤其是提取的正确率(该指标的稳定提升体现了模型对说话人困惑问题的针对性优化)。目标说话人提取(TSE)任务中存在一个普遍的问题——说话人困惑现象。其表现为TSE模型虽然提取了纯净的语音信号,但不是来自目标说话人的语音,而是干扰说话人的语音。这也是TSE模型相比于使用相同主干的盲源分离(BSS)模型性能较弱的主要因素,其原因可能在于注册语音(enrollment speech)的质量不足。该论文针对此问题提出了解决方案。论文首先以BSRNN作为主干网络,介绍了经典的单分支TSE网络的结构,并作为研究的基线(baseline)。接着,该论文在此基础上提出一种创新的双分支TSE模型,模型的两条分支分别命名为目标分支和干扰分支,进行提取目标语音和抑制目标语音的任务。该方法可以提升模型对混合语音的建模能力,获得更鲁棒的潜在特征。论文提出了两种在不同的阶段进行分支的子模型,分别命名为双主干网络(DB-BSRNN_bb)和双掩码提取器网络(DB-BSRNN_me)。两种模型相比单分支基线在相同的训练机制下均获得了一定的性能提升。该论文之后对双分支模型两条分支的输出进行了分析,发现两条分支的输出存在极强的相关性,倾向于同时输出正确的目标语音和干扰语音,或同时发生困惑现象(即两条分支输出与预期相反的信号)。基于此结论,该论文提出一种说话人困惑纠错(Target Confusion Rectification,TCR)算法。算法在模型完成首次提取之后,使用一个预训练好的说话人编码器计算注册语音与两个输出之间的相似度。在发生说话人困惑的情况下,由于两条分支的输出与预期相反,注册语音与目标分支输出之间的相似度会显著低于其与干扰分支之间的相似度。通过这种方法,TCR算法可以以极高的成功率侦测说话人困惑问题,并进行纠错步骤。论文对于纠错步骤也提出了三种不同的后处理方法,分别为直接交换两条分支的输出、将目标分支的输出作为新的注册语音进行二次提取并采用新的干扰分支输出、和将干扰分支的输出作为新的注册语音进行二次提取并采用新的目标分支输出。三种方法均带来了稳定的性能提升。除在SI-SNRi和PESQ分数方面的提升外,该方法在提取正确率方面的提升尤为明显,在Libri2Mix(mix_clean)和Libri2Mix(mix_both)数据集下,模型的推理正确率提升了3.0%至4.4%不等(在未加噪数据上的性能略高),这体现了其对说话人困惑现象的针对性优化。后续的性能分析以及该研究与BSS模型+select方案的比对也证明了该研究的优势。
6、Disentangling the Prosody and Semantic Information with Pre-trained Model for In-Context Learning based Zero-Shot Voice Conversion
通过预训练模型解耦基于上下文学习的音色转换系统中的韵律和语义信息
论文作者:陈正阳,王帅,张明阳,刘学琛,Junichi Yamagishi, 钱彦旻
完成单位:上海交通大学,香港中文大学(深圳),深圳大数据研究院,日本国立情报研究所
论文亮点
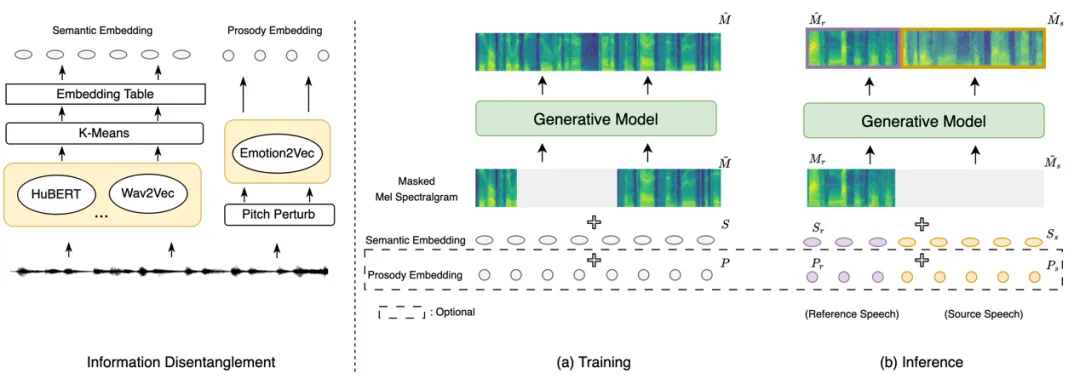
在音色转换任务中,我们往往需要解耦语音的音色和内容。首先,我们发现k-means可以作为一个通用的tokenization方式从不同的预训练模型中提取semantic token来解耦内容信息。此外,在一些音色转换的应用场景,我们还需要保持源语音的韵律信息。为了达到这个目标,我们提出通过情感识别预训练模型emotion2vec来解耦韵律信息。我们的实验显示通过emotion2vec模型解耦的韵律表征具有很好的泛化性,在跨数据集场景下可以生成质量更高的语音。
论文简介
本论文首先提出了一个基于上下文学习的音色转换系统ICL-VC。在训练过程中,模型有三部分输入:(1)梅尔频谱特征(2)从预训练模型提取的语义向量(3)从Emotion2vec模型提取的韵律向量。我们在训练过程中通过掩码频谱并重建的方式训练模型。在测试的时候,通过掩码源语音的频谱,从而完成音色转换的任务。我们在实验中发现,在提取semantic token的时候,k-means可以作为一个通用的聚类方法,即使预训练模型的训练目标与k-means无关(比如wav2vec模型)。实验中,我们首先在LibriTTS数据上评测了我们提出的ICL-VC系统,该系统在音色转换上超过了基线系统。然后,我们在Emotion Speech Dataset (ESD)上测试了ICL-VC系统对于源语音韵律信息的保持能力。我们发现,在使用Emotion2vec模型提取韵律向量并作为模型输入之后,我们的ICL-VC模型可以很好的保持源语音的韵律信息。

 语音小管家