
 语音小管家
来源丨GitHubStore
Omni SenseVoice 基于SenseVoice构建,针对闪电般的快速推理和精确的时间戳进行了优化,可以提供更智能、更快速的方式来处理音频转录!
安装
pip install . 用法
omnisense transcribe [OPTIONS] AUDIO_PATH --language: 自动检测语言或指定(auto, zh, en, yue, ja, ko)。--textnorm:选择是否应用逆文本标准化(withitn for inverse normalized或woitn for raw)。--device-id:在特定 GPU 上运行(默认值:CPU 为 -1)。--quantize:使用量化模型来加快处理速度。--help: 显示详细帮助信息。
基准
omnisense benchmark -s -d --num-workers 2 --device-id 0 --batch-size 10 --textnorm woitn --language en benchmark/data/manifests/libritts/libritts_cuts_dev-clean.jsonl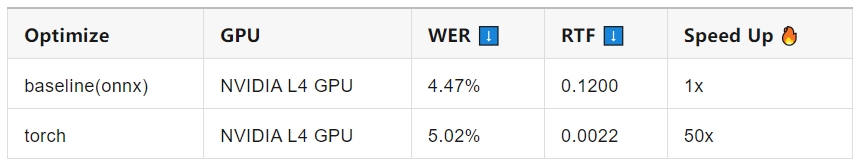
With Omni SenseVoice, experience up to 50x faster processing without sacrificing accuracy.借助 Omni SenseVoice,您可以在不牺牲准确性的情况下体验高达 50 倍的处理速度。
# LibriTTS
DIR=benchmark/data
lhotse download libritts -p dev-clean benchmark/dataLibriTTS
lhotse prepare libritts -p dev-clean benchmark/data/LibriTTS/LibriTTS benchmark/data/manifests/libritts
lhotse cut simple --force-eager -r benchmark/data/manifests/libritts/libritts_recordings_dev-clean.jsonl.gz \
    -s benchmark/data/manifests/libritts/libritts_supervisions_dev-clean.jsonl.gz \
benchmark/data/manifests/libritts/libritts_cuts_dev-clean.jsonl
omnisense benchmark -s -d --num-workers 2 --device-id 0 --batch-size 10 -
-textnorm woitn --language en benchmark/data/manifests/libritts/libritts_cuts_dev-clean.jsonl
omnisense benchmark -s --num-workers 4 --device-id 0 --batch-size 16 --textnorm woitn --language en benchmark/data/manifests/libritts/libritts_cuts_dev-clean.jsonl 