近年来,大模型因其在各类深度学习任务中的卓越表现,受到了研究者们的广泛关注。以语音领域为例,通过在大规模、多样化的语音数据上进行预训练,利用数亿甚至数十亿级别的参数进行学习,语音大模型能够在诸如自动语音识别(Automatic Speech Recognition,ASR)、语音翻译(Speech Translation,ST)等多种下游任务中表现出优异的泛化能力和鲁棒性。然而,现有的语音大模型通常仅考虑单一说话人语音输入,难以有效处理多说话人重叠语音,即著名的“鸡尾酒会”场景。如何有效扩展语音大模型以应对多说话人重叠语音的挑战,成为研究热点。最近,西北工业大学音频语音与语言处理研究组(ASLP@NPU)与卡内基梅隆大学(CMU)合作的论文“SQ-Whisper: Speaker-Querying based Whisper Model for Target-Speaker ASR” 被语音研究领域顶级期刊 IEEE/ACM Transactions on Audio, Speech and Language Processing (TASLP) 录用。该论文探讨了语音大模型在目标说话人语音识别中的应用,提出了一种基于说话人查询的 Whisper 模型(Speaker-Querying based Whisper,SQ-Whisper)。具体来说,给定目标说话人注册语音,该模型通过一组可训练的查询向量,从多说话人重叠语音信号中学习目标说话人提示(Target-Speaker Prompt),从而引导模型准确提取目标说话人特征并识别其语音内容。以下将对该论文进行简要的解读和分享。论文题目:SQ-Whisper: Speaker-Querying based Whisper Model for Target-Speaker ASR作者列表:郭鹏程,常烜恺,吕航,Shinji Watanabe,谢磊发表期刊:IEEE/ACM Transactions on Audio, Speech and Language Processing
现有的语音大模型通常仅考虑单一说话人语音输入,难以应对多说话人重叠语音,即著名的“鸡尾酒会问题”。从零训练针对多说话人重叠语音的大模型需要面对数据收集规模巨大、训练成本高昂等挑战。因此,如何有效地将预训练的语音大模型扩展到重叠语音场景,成为一个备受关注的研究方向。目标说话人语音识别作为一种解决重叠语音问题的方法,旨在根据目标说话人的特征(如说话人向量或注册语音),从多说话人重叠语音中转录出目标说话人的语音内容。先前的研究工作,例如基于目标说话人提取(Target-Speaker Extraction,TSE)的自适应方法 [1] 和目标说话人 HuBERT(Target-Speaker HuBERT,TS-HuBERT)模型 [2],大多依赖于额外的说话人模型来提取说话人向量,并且忽略了不同干扰说话人带来的可变性。本文旨在扩展现有语音大模型的能力,消除多说话人重叠语音中干扰说话人的影响,从而实现目标说话人语音识别。以语音大模型 Whisper [3] 为基座模型,我们首先探讨了其与基于 TSE 的自适应方法 [1] 的结合,即TSE-Whisper模型。随后,我们提出了一种创新结构——基于说话人查询的 Whisper 模型(Speaker-Querying based Whisper,SQ-Whisper )。给定目标说话人注册语音,SQ-Whisper 通过一组可训练的查询向量,从重叠语音中学习目标说话人提示(Target-Speaker Prompt),从而引导模型提取说话人特定的特征并准确识别其抄本。在模拟数据集 Libri2Mix 和 WSJ0-2Mix 上的实验结果表明,SQ-Whisper 相较于之前性能最优的 TS-HuBERT,单词错误率(Word Error Rate, WER)相对降低了 15% 和 10%。通过数据增广,SQ-Whisper 在这两个数据集上进一步实现了 14.6% 和 4.4% 的最佳 WER 结果。此外,在真实会议数据集 AMI上的实验结果显示,SQ-Whisper 相较于其他目标说话人语音识别方法,同样展现了稳定的性能提升。
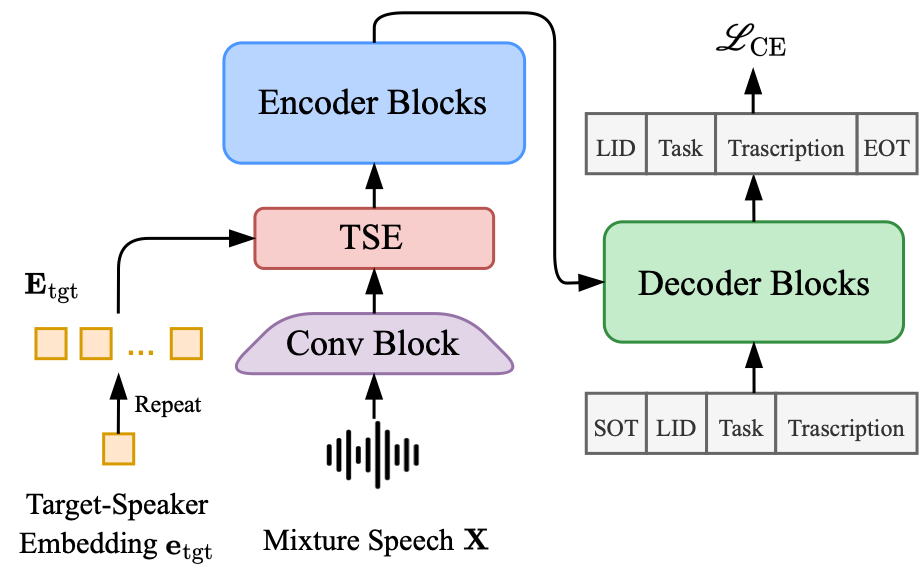
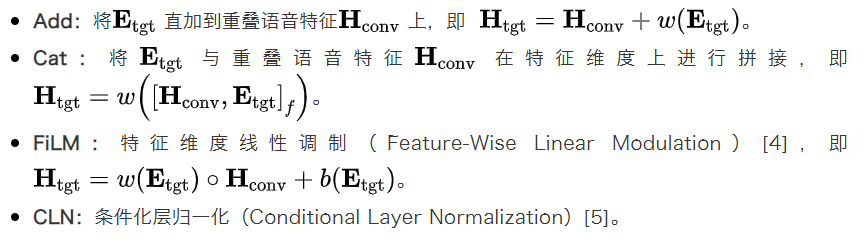
在 Huang 等人提出的基于 TSE 的自适应方法 [1] 中,TSE 模块将预先提取的目标说话人向量作为额外输入,学习从重叠语音特征中提取目标说话人的特征,从而引导模型识别目标说话人的语音。在此基础上,我们首先尝试将 TSE 模块集成到 Whisper 模型中,提出了 TSE-Whisper 模型。图 1 展示了 TSE-Whisper 模型的整体结构。
图 1:TSE-Whisper 模型结构。
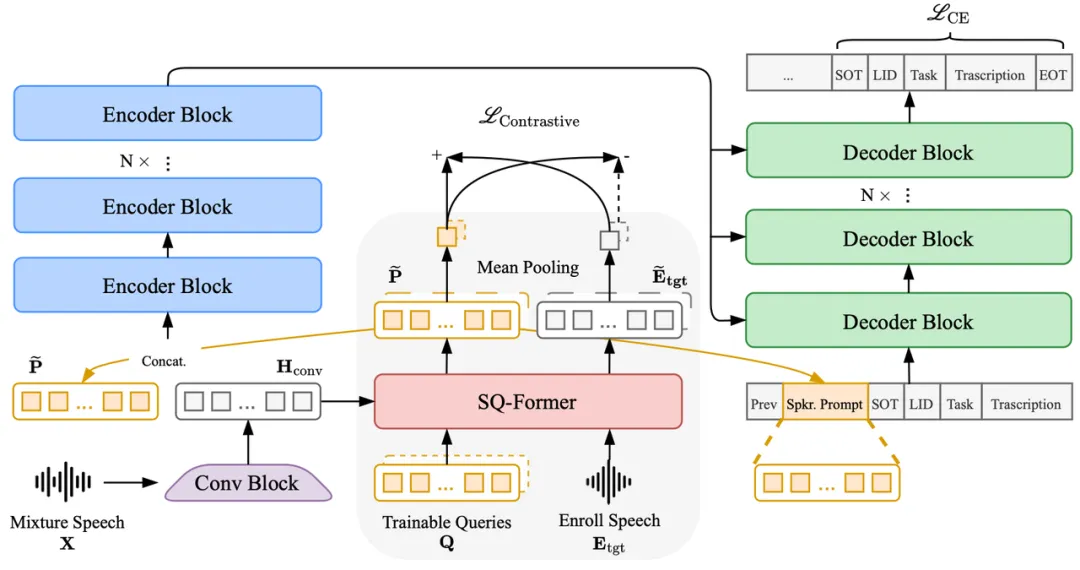
BILP-2 [6] 模型引入了一个基于查询机制的 Transformer 模块(Querying Transformer,Q-Former),通过查询向量与文本指令和图像特征进行交互,从中提取与文本最相关的视觉特征。受其启发,我们提出了一种基于说话人查询的 Transformer 模块(Speaker-Querying Transformer,SQ-Former),该模块旨在给定目标说话人注册语音,使用一组可训练的查询向量,从多说话人重叠语音中学习一系列目标说话人 prompt。这些 prompt 用于提示模型完成目标说话人语音识别。与 Q-Former 的两阶段预训练不同,SQ-Former 作为适配器直接与 Whisper 模型联合微调。SQ-Whisper 模型整体框架如图 2 所示。图 2:SQ-Whisper 模型结构。
SQ-Former 模块
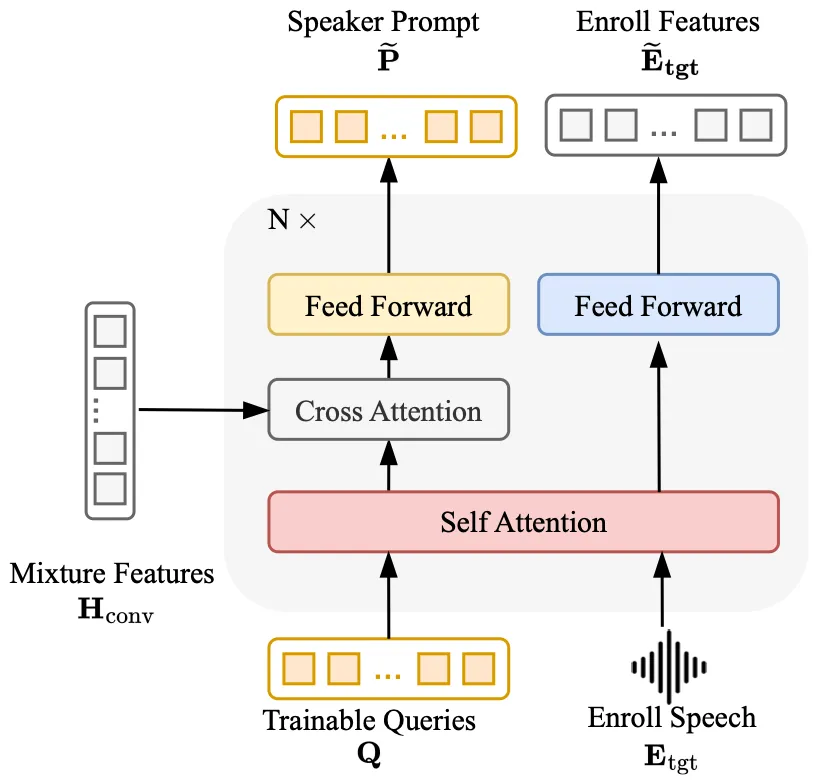
图 3 展示了 SQ-Former 模块的详细架构。该模块由多个 Transformer 块组成,每个块包括一个自注意力模块(SelfAttn)、一个交叉注意力模块(CrossAttn)以及两个独立的前馈网络(FFNs),分别用于可训练查询向量和注册语音特征。图 3:SQ-Former 模块结构。
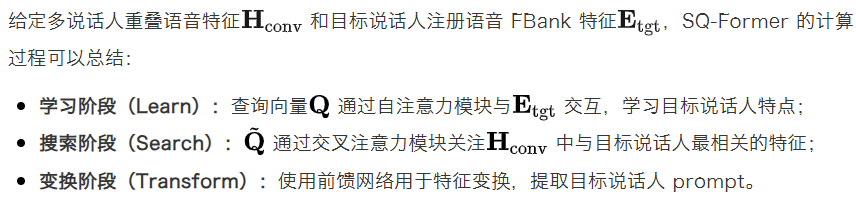
给定多说话人重叠语音特征和目标说话人注册语音 FBank 特征,SQ-Former 的计算过程可以总结:Q-Former 和 SQ-Former 的主要区别在于:- Q-Former 作为信息瓶颈,根据文本指令总结视觉特征;而 SQ-Former 旨在从多说话人重叠语音中检索与目标说话人注册信息相关的特征;
- Q-Former 用于两阶段预训练;SQ-Former 作为适配器直接与 Whisper 模型联合微调;
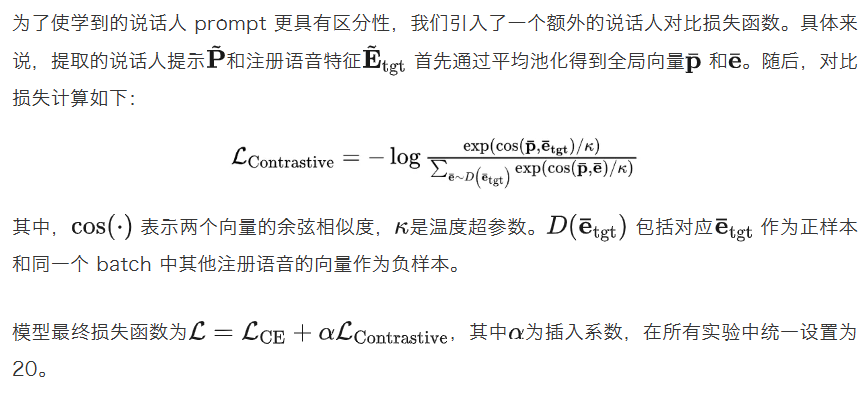
- SQ-Former 引入了额外的说话人对比损失函数,用于生成更具有区分性的说话人 prompt。
说话人对比损失
说话人提示策略
学习到的目标说话人 prompt 通过两种方式引导模型:- Enc. Prompt:将目标说话人 prompt 拼接到 Encoder 输入特征之前;
- Dec. Prompt:将目标说话人 prompt 插入到 Decoder 输入的特殊标记⟨|Prev|⟩和⟨|SOT|⟩的向量空间之间。
参数高效微调
由于语音大模型参数量庞大,针对新任务进行全量微调(Full Fine-tuning)难度较大。本文还探索了参数高效微调的方法,采用了广泛应用的低秩适配(Low-Rank Adaptation,LoRA)技术。
实验数据
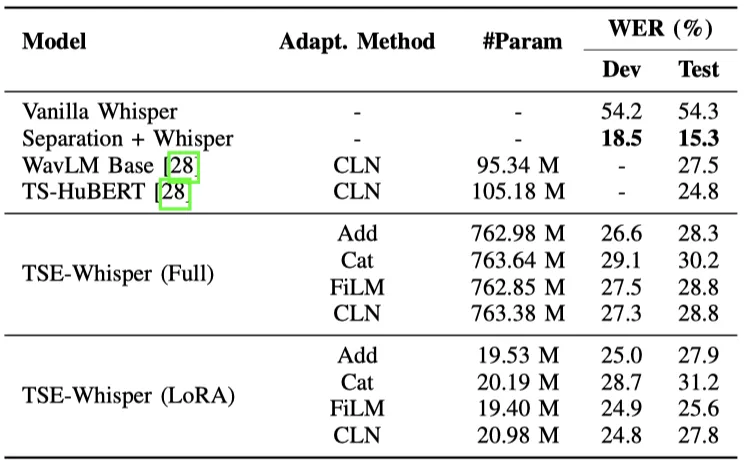
本文分别在两个常用的模拟语音重叠数据集 Libr2Mix [7] 和 WSJ0-2Mix [8],以及一个真实会议场景语音重叠数据集 AMI [9] 上验证了提出方法的有效性。TSE-Whisper 模型效果
表 1 对比了 TSE-Whisper 中不同 TSE 模块的实验结果。在没有目标说话人信息的情况下,原始 Whisper 模型在目标说话人语音识别任务中表现较差。TSE-Whisper 模型显著提升了性能,将 Dev 集和 Test 集的 WER 分别从 54.2% 和 54.3% 降至 26.6% 和 28.3%。然而,与采用 Separation + Whisper 的级联系统相比,TSE-Whisper 仍存在较大差距,这可能是由于分离模型使用了更多的训练数据量,以及 TSE-Whisper 模型本身的能力有限。与先前研究相比,TSE-Whisper(LoRA)模型的结果相当,但仍低于最佳的 TS-HuBERT 模型。
表 1:Libri2Mix 数据集上 TSE-Whisper 模型结果(WER %)。
SQ-Whisper 模型效果
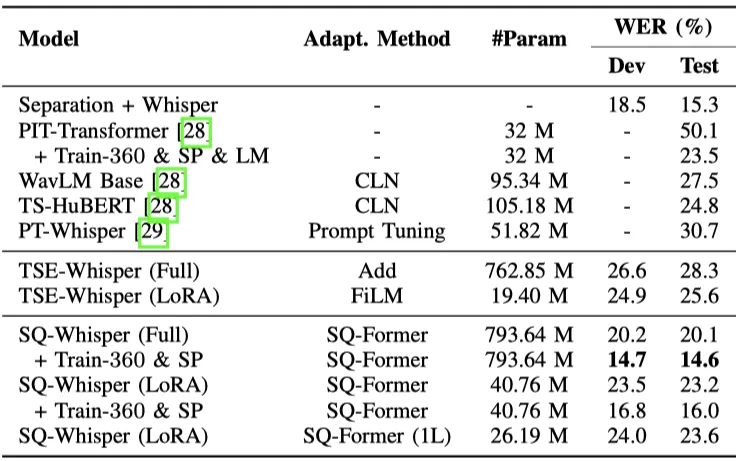
表 2 列出了本文提出的 SQ-Whisper 模型的实验结果。对于全量微调的模型,SQ-Whisper 相比于基线 TSE-Whisper 取得了显著提升,将 Dev 集和 Test 集的 WER 从 26.6% 和 28.3% 分别降低至 20.2% 和 20.1%。与之前表现最优的 TS-HuBERT 模型相比,SQ-Whisper 实现了约 19% 的相对 WER 改善,验证了其有效性。此外,SQ-Whisper 甚至优于使用更多数据训练的 PIT-Transformer 模型,将测试集的 WER 从 23.5% 降至 20.1%,相对降低约 15%。通过引入额外的 Train-360 数据集和速度扰动技术,SQ-Whisper 进一步提升,在两个测试集上分别得到了 14.7% 和 14.6% 的最佳 WER 结果。为了验证性能提升并非完全来源于参数量的增加,本文从两个方面进行了实验:使用 LoRA 方法进行微调以及减少 SQ-Former 的层数以控制参数规模。在 LoRA 微调下,SQ-Whisper 模型仅使用一半的可训练参数,仍优于 TS-HuBERT 模型,将测试集 WER 从 24.8% 降至 23.2%,实现了约 6.5% 的相对 WER 降低。通过仅使用 1 层 SQ-Former 限制参数规模,SQ-Whisper 的测试集 WER 仍优于基线模型(23.6% 对比 25.6%)。
表 2:Libri2Mix 数据集上 SQ-Whisper 模型结果(WER %)。
消融实验:查询向量数量的影响
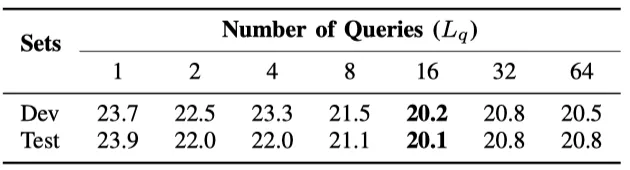
本节探讨了查询向量数量对模型性能的影响。从表 3 可以观察到,随着的增加,WER 持续下降。但当数量超过 16 时性能开始恶化。这表明少量查询即可有效地捕获目标说话人特征,而过多的查询可能引入噪声或导致过拟合。表 3:不同数目查询向量的影响(WER %)。
消融实验:说话人对比损失函数的影响
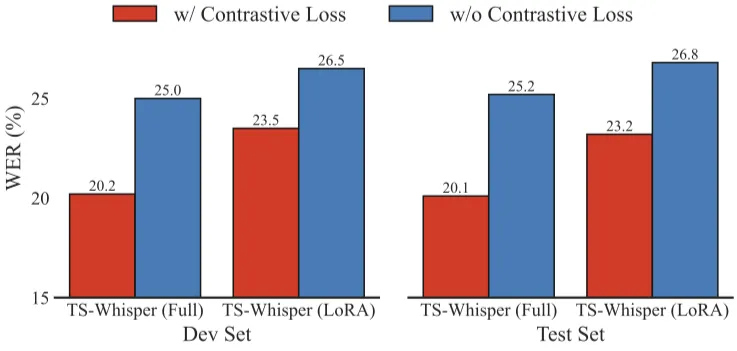
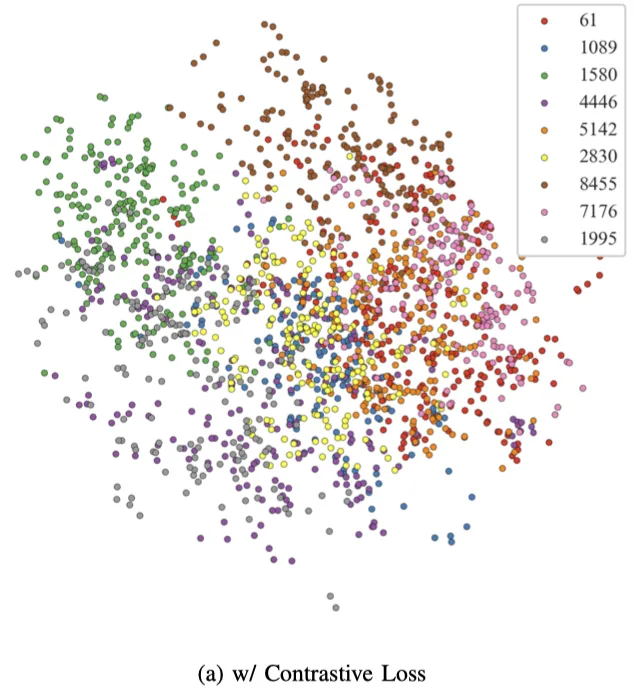
本节探讨了说话人对比损失函数的作用。从图 4 可以看出,去除说话人对比损失函数会显著降低性能。我们还使用 t-SNE 可视化方法展示了有无对比损失函数情况下的说话人 prompt 的特征分布,如图 5 所示。结果表明,引入对比损失后,说话人 prompt 的区分性显著提升。图 4:说话人对比损失函数的影响。
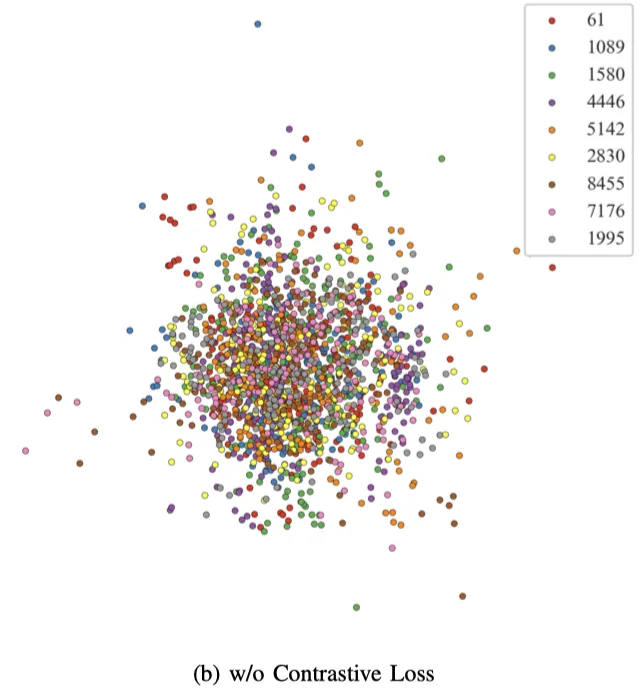
图 5:说话人 prompt 的 t-SNE 可视图。
消融实验:不同说话人提示策略的影响
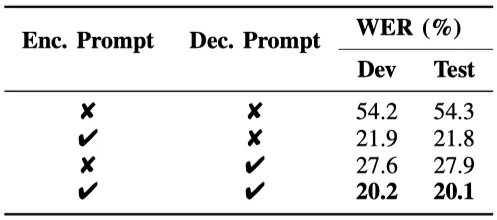
表 4 总结了不同说话人提示策略对模型性能的影响。实验结果表明,在 Encoder 拼接说话人 prompt 在引导模型区分目标语音方面起到了关键作用。此外,同时在 Encoder 和 Decoder 使用说话人 prompt 时得到进一步提升。表 4:不同说话人提示策略的影响(WER %)。
WSJ0-2Mix 数据集结果
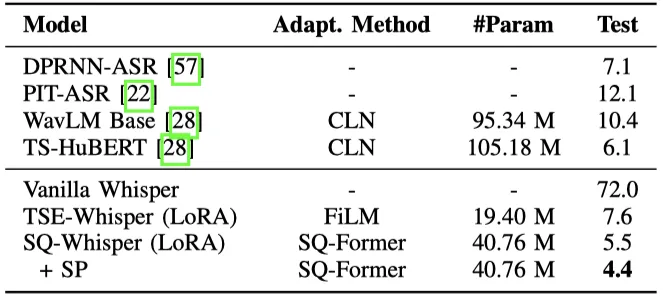
表 5 展示了 SQ-Whisper 模型在 WSJ0-2Mix 数据集上的 WER 结果。TSE-Whisper 仍与表现最佳的 TS-HuBERT 模型存在较大差距(7.6% 对比 6.1%)。相比之下,本文提出的 SQ-Whisper 模型显著提升了性能,WER 降低至 5.5%,相较于 TS-HuBERT 实现了约 10% 的相对提升,同时可训练参数量仅为 TS-HuBERT 的一半。使用数据增广后效果进一步提升,WER 降至 4.4%。表 5:WSJ0-2Mix 数据集结果(WER %)。
AMI 数据集结果
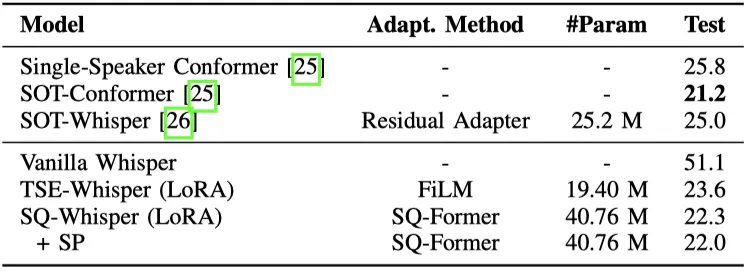
表 6 展示了 SQ-Whisper 模型在真实会议场景数据集 AMI 上的结果。可以观察到,SQ-Whisper 模型在 AMI 数据集上表现出一致的改进,相较于 TSE-Whisper 模型进一步降低了 WER。表 6:AMI 数据集结果(WER %)。
本文探讨了语音大模型在多说话人重叠语音场景中的应用,尤其是针对目标说话人语音识别。以 Whisper 模型为基座模型,我们首先分析了其与现有目标说话人自适应方法的集成。随后,提出了一种基于说话人查询的 Whisper 模型(Speaker-Querying based Whisper,SQ-Whisper)。该模型能够通过多说话人重叠语音和目标说话人注册语音动态学习说话人提示。这些提示用于引导模型提取目标说话人特定的特征,并准确识别目标说话人的语音转录内容。在两个模拟数据集(Libri2Mix 和 WSJ0-2Mix)以及一个真实会议数据集(AMI)上的实验结果表明,所提出的方法显著提升了性能。未来工作将致力于将 SQ-Former 扩展至更大规模的基础模型上,并进一步增强 Whisper 模型的多模态和多通道能力,以提升其在更广泛应用场景中的实用性。[1] Z. Huang, D. Raj, P. Garc ́ıa, and S. Khudanpur, "Adapting self-supervised models to multi-talker speech recognition using speaker embeddings," in Proc. IEEE ICASSP, 2023, pp. 1–5.
[2] W. Zhang and Y. Qian, "Weakly-supervised speech pre-training: A case study on target speech recognition," in Proc. Interspeech, 2023, pp. 3517–3521.
[3] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, "Robust speech recognition via large-scale weak supervision," in Proc. ICML, 2023, pp. 28 492–28 518.
[4] E. Perez, F. Strub, H. De Vries, V. Dumoulin, and A. Courville, "FiLM: Visual reasoning with a general conditioning layer," in Proc. AAAI, vol. 32, no. 1, 2018.
[5] J. Pilault, A. Elhattami, and C. Pal, "Conditionally adaptive multi-task learning: Improving transfer learning in NLP using fewer parameters & less data," in Proc. ICLR, 2021.
[6] J. Li, D. Li, S. Savarese, and S. Hoi, "BLIP-2: Bootstrapping language image pre-training with frozen image encoders and large language models," in Proc. ICML, 2023, pp. 19 730–19 742.
[7] J. Cosentino, M. Pariente, S. Cornell, A. Deleforge, and E. Vincent, "LibriMix: An open-source dataset for generalizable speech separation,"arXiv preprint arXiv:2005.11262, 2020.
[8] J. R. Hershey, Z. Chen, J. Le Roux, and S. Watanabe, "Deep clustering: Discriminative embeddings for segmentation and separation," in Proc. IEEE ICASSP. IEEE, 2016, pp. 31–35.
[9] J. Carletta, S. Ashby, S. Bourban, M. Flynn, M. Guillemot, T. Hain, J. Kadlec, V. Karaiskos, W. Kraaij, M. Kronenthal, et al., "The AMI meeting corpus: A pre-announcement," in Proc. MLMI, 2005, pp. 28– 39.

 语音小管家