在语音识别技术飞速发展的今天,其在各个领域的应用已经展现出巨大的潜力和效率。然而,最近来自英国谢菲尔德大学的研究人员开展的一项研究提醒我们,这项技术在性别公平性上仍存在挑战。相关研究成果发布在 arXiv 上。
这项由 Hend ElGhazaly、Bahman Mirheidari 等人开展的研究,突破了以往仅从人口统计学角度的常规研究方式,旨在全面探究影响自动语音识别(ASR)系统性别偏见的因素。
研究人员提出了两个关键问题:训练集中不同的性别分布如何影响 ASR 性能和公平性?除了性别比例,还有哪些因素会影响 ASR 性能?
研究选用了 LibriSpeech 数据集和 Whisper small 模型。LibriSpeech 语料库在 ASR 研究中应用广泛,其中包含约 1000 小时来自 LibriVox 的英语有声读物转录内容,由 2484 名说话者朗读。研究人员利用该语料库创建了 11 个具有不同性别分布的训练子集,通过逐步改变训练集中女性音频文件的占比,从 0% 到 100%,来观察对 ASR 性能的影响。
同时,选用预训练的 Whisper small 模型作为基线模型,在实验前对其进行微调,并使用词错误率(WER)评估模型性能,通过计算男女说话者 WER 的差异来衡量性别偏见。
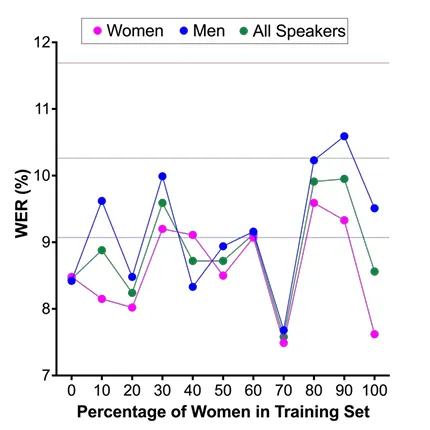
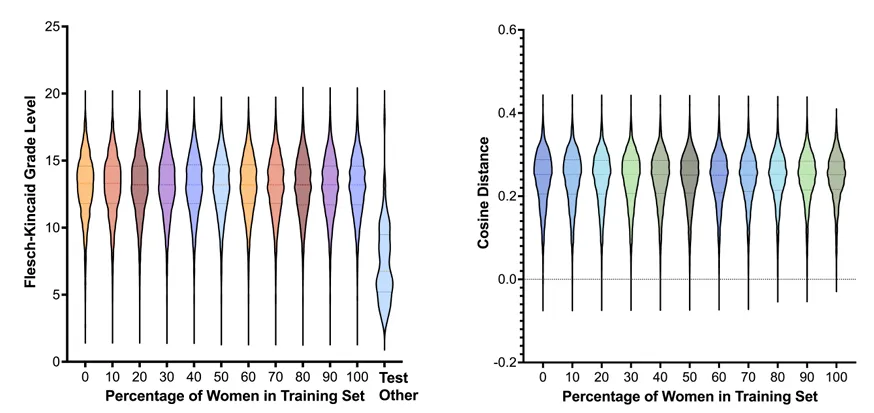
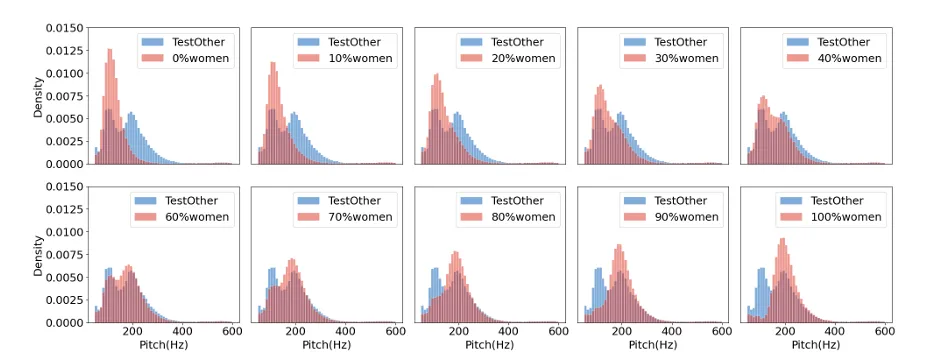
研究发现,原始的 Whisper small 模型存在对女性的偏见,女性的 WER(11.69%)高于男性(9.07%),差距达到 2.62%。经过微调后,虽然模型性能有所提升,性别偏见也最多降低了 97%,但训练集中的性别比例与 WER 之间并非简单的线性关系。并非 50:50 的性别划分就能带来最佳效果,而是在特定的性别分布(如 70% 女性)下,模型能实现最佳的整体 WER(7.58%) 。微调模型在 TestOther 评估中的平均词错误率(WER)。水平虚线表示原始 Whisper 模型的结果。此外,极端的性别不平衡(如 10% 或 100% 女性)会扩大 WER 差距,而 60% 女性的比例则在准确性和公平性之间达到了最佳平衡,此时 WER 差距最小(0.09%)。除了性别比例,研究人员还对文本内容和说话者的音高分布等因素进行了探究。在文本方面,通过 Flesch - Kincaid 年级水平可读性指标测量训练集和测试集的文本难度,并计算文本的余弦距离衡量语义相似性,结果发现文本难度和语义相似性对 WER 没有显著影响。训练集和测试集文本难度(左)以及语义相似度(右)的对比。而在音高分布上,研究发现训练集的音高分布与测试集越相似,模型性能越好。例如,更平衡的训练集涵盖了更多的音高分布,与测试集更相似,相应模型的 WER 较低;相反,不平衡的训练集,如男性主导的训练集在高音区域多样性不足,以女性声音为主训练的模型在低音区域频率较低,都会导致较高的 WER。训练子集(红色)和 TestOther 测试集(蓝色)的音高分布示意图这项研究为我们理解 ASR 系统中的性别偏见提供了更深入的视角。它明确指出,训练数据的分布对模型性能和公平性至关重要,不能简单认为性别平衡就一定能带来更好的结果,而是要综合考虑多种因素,选择能在不同性别下最小化 WER 且不影响整体性能的模型。同时,这也提醒了相关从业者,在构建和优化 ASR 系统时,需要更细致地处理训练数据,不能仅关注性别比例,还应重视说话者的语音属性多样性,如音高分布等。不过,该研究也存在一定的局限性。研究仅基于英语数据集,而不同语言在形态学、句法和词嵌入等语言特征上存在差异,未来的研究可以拓展到其他语言和更多的 ASR 模型,进一步验证这些发现是否具有普遍性。更多信息:ElGhazaly, H., Mirheidari, B., Moosavi, N. S., & Christensen, H. (2025, February 25). Exploring Gender Disparities in Automatic Speech Recognition Technology. arXiv preprint arXiv:2502.18434v1.
 语音小管家