语音小管家
分享3篇西工大语音与语言处理研究组被语音研究顶级期刊IEEE Transactions on Audio, Speech and Language Processing (TASLP)录用的论文,相关研究成果包括基于语音向量和语义标记的多任务语音生成大模型Vec-Tok Speech、基于解耦量化的多语种语音识别方法DQ-Data2vec、基于序列的多语种说话人匿名方法MUSA。论文的合作单位为:喜马拉雅和字节跳动。
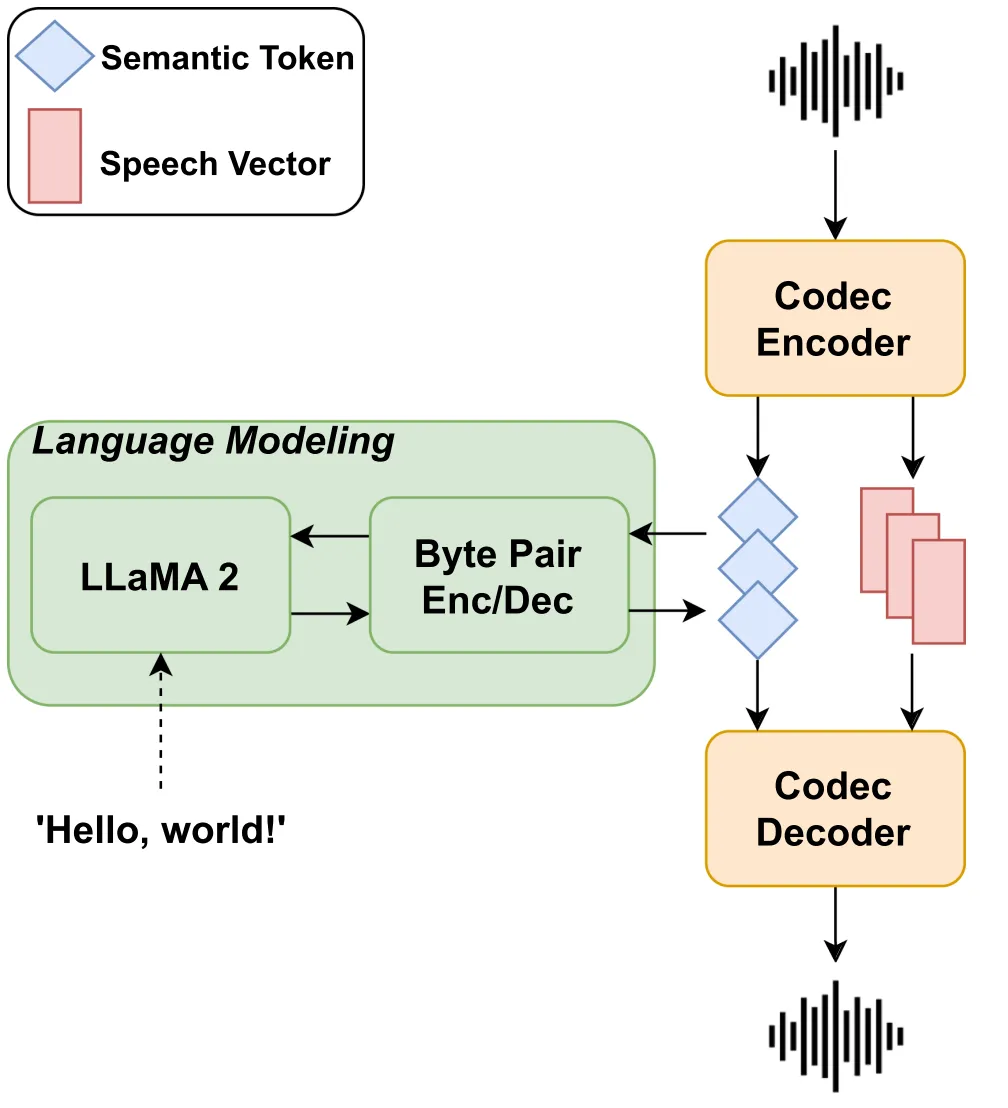
论文题目:Vec-Tok Speech: speechvectorization and tokenization for neural speech generation
作者列表:朱新发,吕元骏,雷怡,李涛,贺雯迪,周鸿斌,卢恒,谢磊
合作单位:喜马拉雅
论文链接:https://ieeexplore.ieee.org/document/10906431
摘要:近期语言模型(LMs)在自然语言处理和计算机视觉领域蓬勃发展,可以生成高质量的文本或图像。相比之下,当前的语音生成模型仍然在语音质量和任务多样性之间挣扎。为此本文提出了Vec-Tok Speech,一个适用于众多下游任务的的可扩展框架,生成富于表现力的高保真语音。具体来说,本文提出了一种新的基于语音向量(SpeechVectors)和语义单元(SemanticToken)的语音编解码器(Vec-Tok Codec)。语音向量包含有助于高保真语音重建的声学细节,而语义单元关注语音的语言内容,便于语言建模。基于Vec-Tok Codec,Vec-Tok Speech利用语言模型来作为语音生成的核心生成语义单元;并引入字节对编码(BPE)来减少令牌长度和比特率,从而降低曝光偏差(Exposure Bias)获得更长的上下文覆盖,从而提高语言建模的性能。Vec-Tok Speech可以用于同语种和跨语种的零资源(Zero-shot)语音转换(VC)、零资源风格迁移的文本语音生成(TTS)、语音翻译(S2ST)、语音去噪、去说话人以及匿名化等任务。实验表明,基于5万小时语音训练的Vec-Tok Speech比目前单任务模型具有更好的表现。
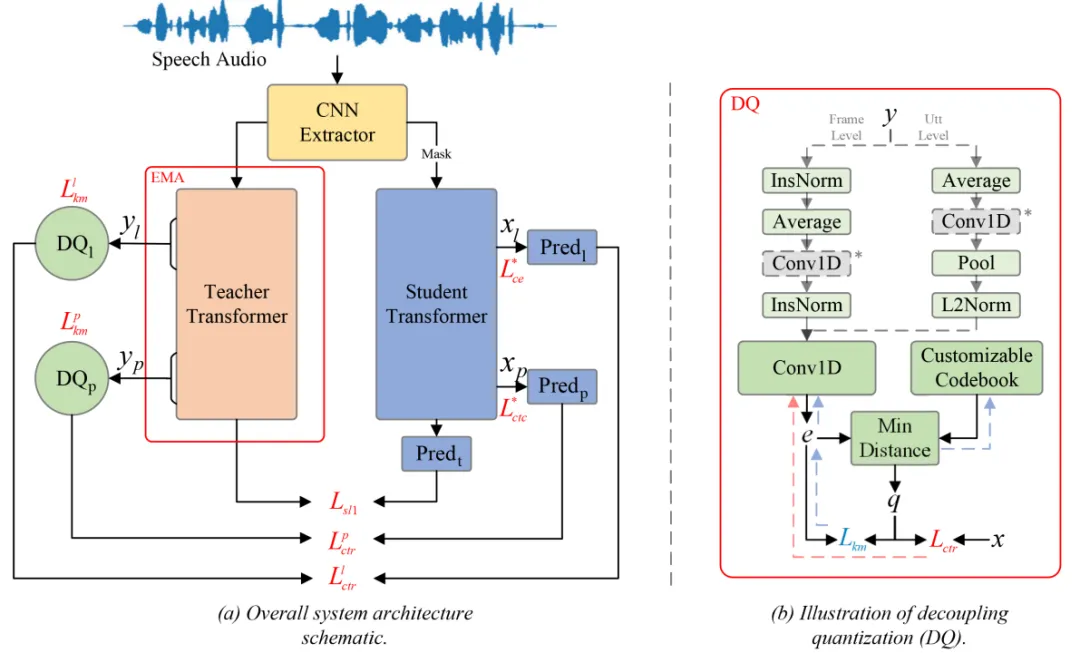
论文题目:DQ-Data2vec: Decoupling Quantization for Multilingual Speech Recognition
作者列表:邵琪杰, 董林昊, 魏坤, 孙思宁, 谢磊
合作单位:字节跳动
论文链接:https://arxiv.org/abs/2501.13497
摘要:Data2vec是一种自监督学习(SSL)方法,采用教师-学生架构,通过掩码预测进行上下文表示学习,在单语种语音识别(ASR)中表现出色。它的浅层捕捉了说话人和语种信息,中层编码了音素和单词特征,而深层则负责重建,然后再通过将多层输出进行平均以生成掩码帧的目标表示。然而,先前的研究表明,语种和音素特征对于多语种ASR至关重要,但Data2vec的这种多层平均不可避免地耦合了这些特征,导致没能充分利用多语种场景中特有的信息。为了解决这一局限性,我们提出了一种基于解耦量化的Data2vec(DQ-Data2vec)用于多语种ASR,它包括一个Data2vec主干和两个改进的在线K-means量化器。我们的核心思想是使用具有指定聚类数的K-means量化器来解耦语种和音素信息以进行掩码预测。具体来说,在语种量化中,考虑到语种数量与其他无关特征(如说话者)显著不同,我们将聚类数设置为与语种数量匹配,明确将浅层的语种相关信息与无关特征解耦。这一策略也应用于解耦中层的音素和单词特征。在不使用任何标签的自监督场景下,以及引入语种标签和高资源语种文本标签的弱监督场景下,DQ-Data2vec相对于经典的Data2vec结构均展现出明显的性能提升。
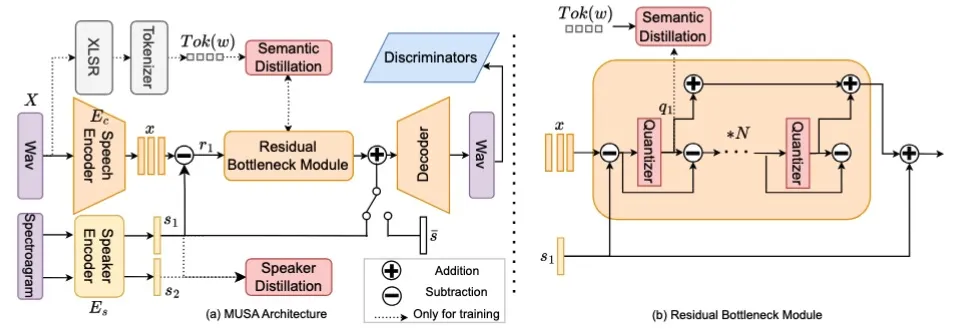
论文题目:MUSA: Multi-lingual Speaker Anonymization via Serial Disentanglement
作者列表:姚继珣,王晴,郭鹏程,宁子谦,杨宇光,潘宇,谢磊
合作单位:喜马拉雅
论文链接:https://arxiv.org/pdf/2407.11629
摘要:说话人匿名化是一种有效的隐私保护解决方案,旨在隐藏说话人身份的同时保留原始语音的语言学内容和副语言信息。现有说话人匿名化研究多局限于单一语种,而一个理想的说话人匿名化系统应具备跨语种的通用能力。本文提出一种基于分步解缠策略的多语言说话人匿名化方法(MUSA),通过从全局时不变表征到时序时变表征的递进解耦实现说话人身份的隐藏。该方法通过语义蒸馏和自监督说话人蒸馏策略,避免引入强归纳偏置,在多种语言上展现出优异的泛化性能。同时,我们提出采用零值空嵌入模拟身份隐藏过程的匿名化策略,无需转换至伪说话人身份,显著降低了匿名化流程的复杂度。在VoicePrivacy官方数据集和多语言数据集上的实验表明,MUSA在有效保护说话人隐私的同时,能较好保持语言学内容和副语言信息的完整性。