
 语音小管家
本期将为大家介绍上海交通大学听觉认知与计算声学实验室被ICASSP2025录用的7篇论文,研究领域涵盖说话人识别、语音增强、语音合成、语音分离等多个方向。
01、Flow-TSVAD:Target-Speaker Voice Activity Detection via Latent Flow Matching for Speaker Diarization
Flow-TSVAD:基于隐空间流匹配算法的目标说话人检测说话人日志系统
论文作者:陈正阳,韩冰,王帅,蒋一迪,钱彦旻
完成单位:上海交通大学,香港中文大学(深圳),新加坡国立大学
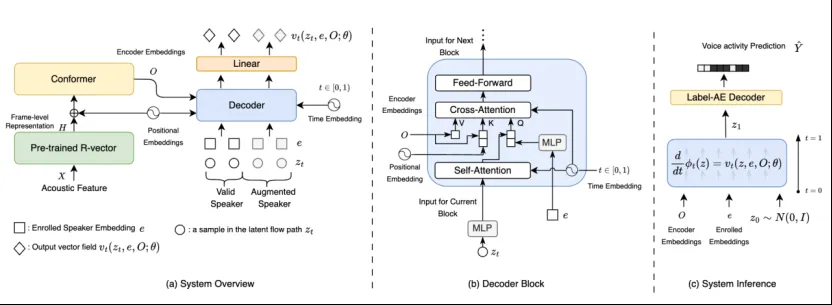
论文亮点:本文首次将生成式算法用到目标说话人检测系统中,用来提升说话人日志任务的性能。在文中的实验中,我们注意到流匹配(Flow-Matching)生成式算法更适用于连续空间上表征的生成,而说话人日志的标签往往是二值离散序列。为解决这个问题,我们提出了一个隐空间标签自编码器(Label-AE)将二值离散标签压缩到更加连续低维的隐空间。基于此,我们发现,论文提出的Flow-TSVAD可以在较低迭代步数的情况下快速收敛到最优结果,并超过了Seq2seq-TSVAD基线系统。此外,Flow-TSVAD作为生成式模型在多次采样过程中的结果并不相同,对多次采样结果进行ensemble还可以进一步提升模型性能。
论文简介:基于神经网络的说话人日志系统往往是基于判别式算法的,也就是说,对于固定的输入会有固定的输出。说话人日志的标签是一种说话人区间的标注,这种标注往往在边界区域具有一定的误差,这种误差可能会对判别式算法的优化造成扰动。我们认为,可以使用生成式算法对这个误差的分布做一个建模,也就是说,我们不再建模固定的输出,而且建模关于输出的一个分布。其实,在我们的工作之前,在很多其他的语音领域已经有人使用生成式算法解决原来使用判别式算法的任务,比如语音增强,目标说话人提取。此外,在图像领域,也有一些研究人员使用生成式算法解决目标检测和实例分割这种经典判别式任务。
在论文中,我们提出将流匹配(Flow-Matching)生成式算法应用到序列到序列目标说话人检测系统(Seq2seq-TSVAD)。在这个系统中,我们不再直接建模说话人日志的最后标签,而是建模流匹配算法中的向量场。在测试过程中,我们对这个向量场进行积分就可以得到最后的说话人日志结果。在实验中,我们还发现,将Flow-Matching直接用到二值的说话人标签序列基本上是不work的,这是因为Flow-Matching算法是被设计用来连续分布的建模为了解决这个问题,我们提出了一个标签自编码器(Label-AE)将二值标签序列映射到一个更加低维且连续的隐空间,在这个隐空间上进行Flow-Matching算法,就可以取得合理的结果。
在实验结果中,我们发现,尽管在一些语音生成和图像生成领域,使用Flow-Matching算法往往需要迭代多步,我们才能得到一个比较好的结果。在说话人任务中,我们只需要迭代两步,就可以超过Seq2seq-TSVAD的基线。此外,作为一个生成式模型,不同次采样Flow-TSVAD会产生不同的结果,对这些不同的结果进行一次ensemble还能进一步提升性能。
02、Data-Efficient Low-Complexity Acoustic Scene Classification via Distilling and Progressive Pruning
通过蒸馏和多步剪枝的高效音频场景分类
论文作者:韩冰,黄文,陈正阳,姜安柏,樊平毅,路程,吕志强,刘加,张卫强,钱彦旻
完成单位:上海交通大学,清华大学
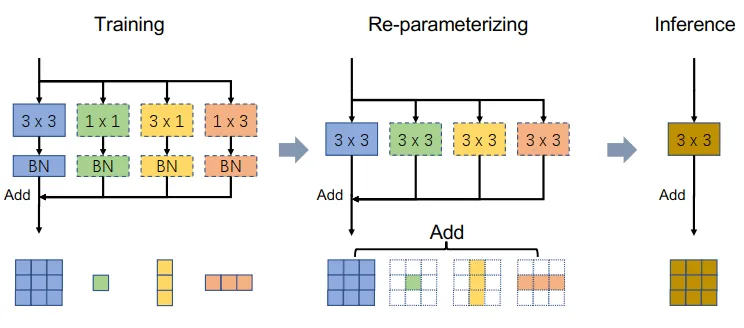
论文亮点:该论文主要针对声学场景分类任务设计了数据高效的低复杂度框架,包括轻量化卷积网络 Rep-Mobile、知识蒸馏及渐进式剪枝来提高模型的分类性能和推理效率。实验表明使用这些策略在TAU 测试集上和同等复杂度极限模型相比达到 SOTA 结果,且在 DCASE2024 task1 中获得第一名。
论文简介:声学场景分类(Acoustic Scene Classification, ASC)是一项重要的音频识别任务,旨在根据环境声音对其所属的场景进行分类。然而,ASC 任务在实际应用中面临设备不匹配、计算资源受限以及训练数据有限等挑战。为此,本文提出了一种数据高效、低复杂度的 ASC 方法,结合轻量级卷积网络 Rep-Mobile、知识蒸馏(Knowledge Distillation, KD)以及渐进式剪枝(Progressive Pruning)来提高模型的分类性能和推理效率。Rep-Mobile 通过多分支可重参数化(multi-branch reparameterization)机制提升特征提取能力,同时保持推理阶段的高效性。为了增强数据有限条件下的泛化能力,我们引入多教师模型蒸馏策略,结合 CNN 和 Transformer 模型进行知识迁移。此外,渐进式剪枝方法通过逐步减少冗余参数,实现模型压缩的同时保持精度。在 TAU Urban Acoustic Scene 2022 Mobile 数据集上的实验结果表明,我们的方法在准确率和计算效率上均优于主流模型,并在 DCASE2024 竞赛中获得第一名,验证了所提方法的有效性。
03、Advanced Zero-Shot Text-to-Speech for Background Removal and Preservation with Controllable Masked Speech Prediction
环境感知的可控背景去除和保留的语音合成系统
论文作者:张乐莹,张王优,陈正阳,钱彦旻
完成单位:上海交通大学
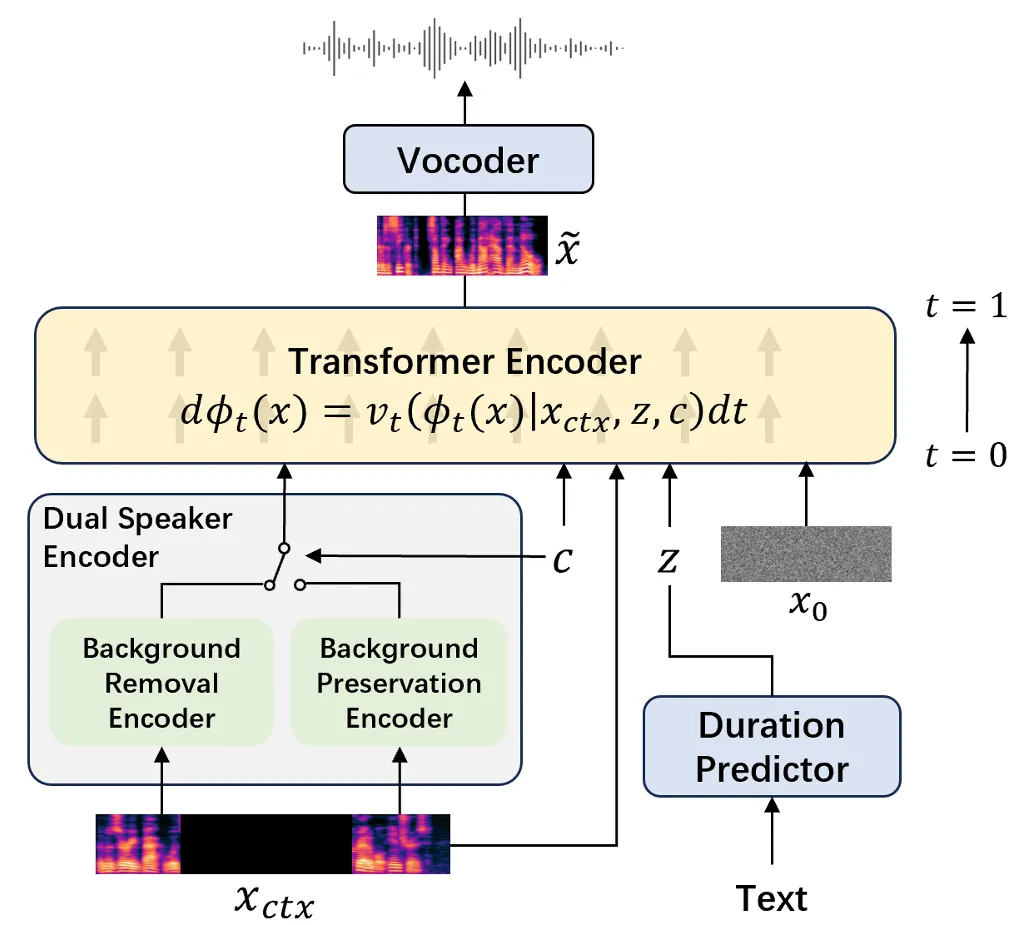
论文亮点:本研究提出了一种创新的可控掩蔽语音预测策略及双说话人编码器,能够根据具体需求精确控制语音中的背景声去除或保留。该方法在多种声学条件下表现出色,并在未见场景中展现出强大的泛化能力,有效解决了现有零样本语音合成系统在处理含背景声语音提示时的挑战。
论文简介:在人类的自然对话中,背景声音起着至关重要的作用。它提供了语境,帮助听众理解说话人所处的环境和情形。然而,过于强烈的背景声则会干扰听众对语音的理解。如何处理这些背景声音取决于具体情境:有时,我们需要去除背景以确保获取清晰的语音,但有时,我们希望保留背景声音从而帮助听众理解所处的环境。尽管零样本文本到语音和语音克隆技术近年来取得了进展,但现有的系统在处理包含背景的语音提示时仍常常面临挑战。为解决这些难题,我们提出了一种可控掩蔽语音预测策略,并双说话人编码器,利用与任务相关的控制信号来同时指导和实现去除背景声和保留背景声的任务。实验结果表明,我们的方法能够在各种声学条件下精确控制背景的去除或保留,并在未见场景中展现出强大的泛化能力。
04、SLIDE: Integrating Speech Language Model with LLM for Spontaneous Spoken Dialogue Generation
SLIDE:基于语音和语言模型的自发口语对话生成系统
论文作者:陆海天,程高峰, 罗柳平,张乐莹,钱彦旻,张鹏远
完成单位:中科院声学所,中国科学院大学,广东省公安厅,上海交通大学
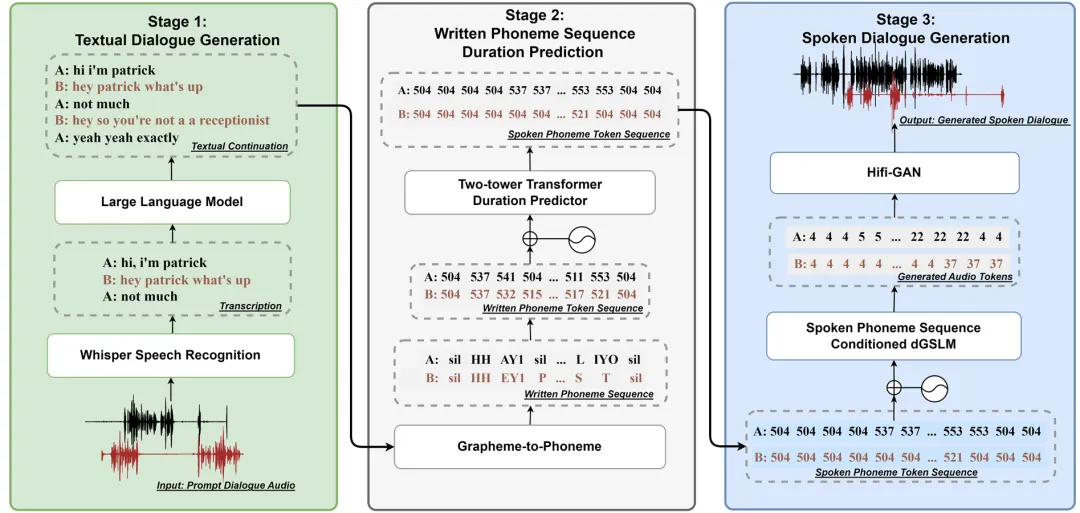
论文亮点:本研究提出了一种创新的口语对话生成模型SLIDE,通过将大型语言模型(LLM)与语音语言模型(SLM)相结合,解决了传统方法中语义连贯性和语音自然性难以兼顾的问题,实现了自然且语义连贯的口语对话生成。
论文简介:基于语音单元的“无文本”语音语言模型(SLMs)在生成自然语音方面,包括非语言性发声,取得了巨大进展。然而,生成的语音样本往往缺乏语义连贯性。在本文中,我们提出了用于自发口语对话生成的SLM和LLM集成系统(SLIDE)。具体而言,我们首先利用一个大型语言模型(LLM)生成口语对话的文本内容。接下来,我们将文本对话转换为音素序列,并使用基于双塔Transformer的持续时间预测器来预测每个音素的持续时间。最后,我们使用基于口语音素序列的SLM来为文本对话配音。在Fisher数据集上的实验结果表明,我们的系统能够在保持高语义连贯性的同时生成自然的口语对话。
05、Generalizable Audio Deepfake Detection via Latent Space Refinement and Augmentation
基于潜在空间优化与增强的音频深度伪造检测泛化方法
论文作者:黄文,顾艳梅,王志铭,祝慧佳,钱彦旻
完成单位:上海交通大学、蚂蚁集团
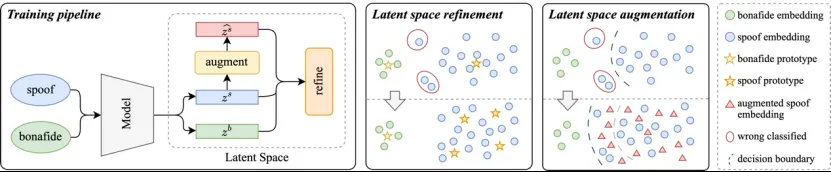
论文亮点:本论文提出了两种基于潜在空间的策略——潜在空间优化(LSR)与潜在空间增强(LSA),以提升深度伪造语音检测的泛化能力。LSR 引入多个伪造原型以优化特征表达,LSA 在潜在空间进行数据增强以扩展伪造模式分布。论文在四个具有代表性的公开数据集上进行了全面实验,结果表明两种策略均可单独提升检测性能,二者结合后在多个数据集上实现了媲美或超越当前SOTA方法的表现,验证了该方法在提升伪造检测系统跨场景泛化能力方面的有效性。
论文简介:近年来,文本转语音(TTS)和语音转换(VC)等语音合成技术的进步,使得深度伪造语音的检测变得越来越具有挑战性。现有的防伪技术在面对未知攻击时往往难以有效泛化。为了解决这一问题,我们提出了一种新策略,将潜在空间优化(LSR)和潜在空间增强(LSA)结合,以提升深度伪造检测系统的泛化能力。LSR 通过为伪造类别引入多个可学习的原型,优化潜在空间,从而更精细地刻画伪造数据的复杂变化。LSA 直接在潜在空间中应用数据增强技术,使模型能够学习更广泛的伪造模式,从而进一步丰富伪造数据的表示。我们在四个代表性数据集(ASVspoof 2019 LA、ASVspoof 2021 LA、ASVspoof 2021 DF 和 In-The-Wild)上对所提出的方法进行了评估。实验结果表明,LSR 和 LSA 各自均能显著提升检测性能,而它们的结合可以达到甚至超越当前最先进方法的性能。
06、Advancing Non-intrusive Suppression on Enhancement Distortion for Noise Robust ASR
通过非侵入式增强失真抑制实现噪声鲁棒语音识别
论文作者:王巍,赵思怡, 钱彦旻
完成单位:上海交通大学
论文亮点:该论文提出了一种轻量级的失真抑制(Distortion Suppression, DS)网络,以解决语音增强(SE)前端对自动语音识别(ASR)系统带来的性能退化问题。现有方法通常依赖对 SE 或 ASR 模型的微调或重新训练,而该论文的方法无需修改 SE 或 ASR 模型,而是将其视为固定的黑箱进行处理。论文在单声道与多通道 SE 前端,以及不同的 ASR 后端上进行了实验,并在中英文 ASR 任务上验证了该方法的有效性。DS 模块能够显著提升 SE-ASR 系统的识别性能,即使在商用 ASR 后端上也能取得良好的效果。
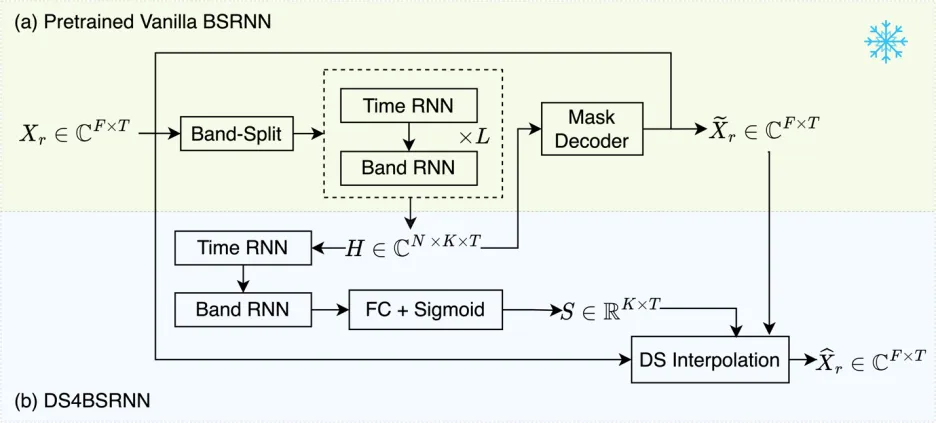
论文简介:与现有的大多数针对 SE-ASR 系统的改进方法不同,我们提出了一种轻量级的失真抑制(Distortion Suppression, DS)网络,以非侵入式的方式缓解语音增强(SE)引入的失真对语音识别系统(ASR)性能的影响。现有方法通常依赖于对 SE 或 ASR 进行重新训练和微调,这在实际应用中并不总是可行。相比之下,我们的目标是在不修改 SE 或 ASR 模型的前提下,提升 SE-ASR 系统的识别性能,使其能够作为黑箱运行。DS模块的输入是原始与增强后的语音信号,利用原始 T-F 信息补偿 SE 失真。具体而言,我们引入了 失真抑制系数,以子带和语音帧为单位自适应地融合原始与增强后的复数频谱信息,从而减少增强模型带来的失真。
DS 模块可以独立于 ASR 后端运行,并适用于不同的ASR 结构。在不改变ASR模型参数的情况下,即可显著提升 SE-ASR 系统的性能。此外,我们还提出了一种与 Band-split RNN(BSRNN)耦合的 DS 变体,该变体在保持 ASR 性能提升的同时,进一步降低了计算复杂度。我们在单通道和多通道 SE 前端,以及不同的 ASR 后端上进行了实验,涵盖了中英文 ASR 任务。实验结果表明,即使在商用 ASR 后端的情况下,DS 模块仍能显著提升 SE-ASR 识别性能,验证了其有效性和通用性。
07、Efficient Pruning for Large-Scale Seq2Seq Speech Models without Back-Propagation
无需反向传播的大规模序列到序列语音模型高效剪枝方法
论文作者:顾天腾,刘贝、钱彦旻
完成单位:上海交通大学
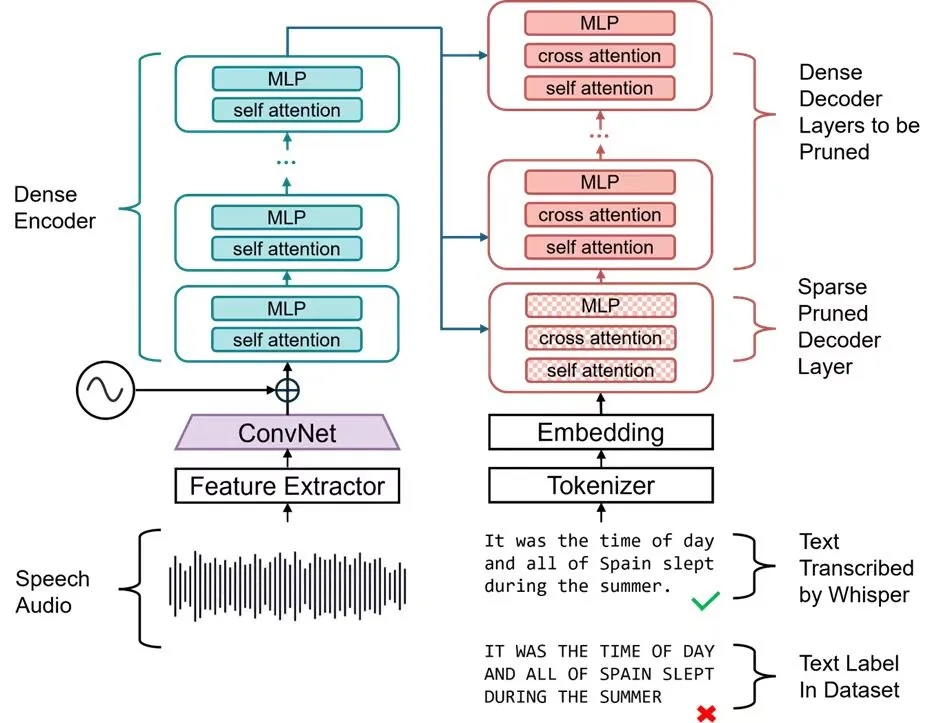
论文亮点:本研究针对大规模Seq2Seq语音模型(如Whisper)的部署瓶颈,提出了一种基于前向传播的高效剪枝框架,无需依赖反向传播与重训练即可实现模型压缩。该方法通过改进层间剪枝流程与动态稀疏度分配策略,在参数量减少60%的条件下,仍能维持原模型在多语言、多场景语音识别任务中的性能表现。核心创新包括:(1)设计双模态校准数据集,采用模型自身生成的规范化文本与原始编码器输出分别稳定解码器与编码器剪枝过程;(2)提出基于权重矩阵重构误差的自适应混合稀疏度分配方法,仅通过单次前向计算即可量化参数重要性,显著降低剪枝对模型鲁棒性的影响。实验表明,剪枝后的Whisper-large-v3在LibriSpeech、Common Voice等6个数据集上的平均词错率(WER)仅上升0.43%,且与知识蒸馏方法结合后,参数量可进一步压缩至原模型的25%。
论文简介:本文聚焦于解决大型编码器-解码器结构语音模型的轻量化部署问题。现有剪枝方法因依赖反向传播计算梯度或Hessian矩阵,难以适用于十亿级参数量的Seq2Seq模型。本研究提出一种轻量级剪枝框架,其技术路径包含两个关键模块:首先,在解码器剪枝阶段,采用Whisper自动生成的带标点文本作为解码器输入校准集,同时保留未剪枝编码器的隐藏状态作为跨注意力层校准集,有效缓解传统层间剪枝中的误差传播问题;其次,针对不同层权重矩阵的重要性差异,通过前向传播计算各矩阵在不同稀疏度下的输出重构误差,动态选择满足阈值约束的最大稀疏度,形成混合稀疏度配置方案(实验设定8类权重分组,稀疏度范围30%-80%)。在Whisper-large-v3上的验证结果显示,该方法仅需单张RTX 4090 GPU耗时6小时,即可生成参数量807M的60%稀疏模型(原模型1.55B),在LibriSpeech test-clean/test-other数据集上的WER分别从2.02%/3.91%微增至2.12%/4.24%,同时支持英语、法语、德语等多种语言的语音识别任务。该方法为资源受限场景下的语音模型部署提供了新的技术路径。
