
 语音小管家
近期,由西工大音频语音与语言处理研究组(ASLP@NPU)和字节跳动合作的论文“DQ-Data2vec: Decoupling Quantization for Multilingual Speech Recognition”发表在语音研究顶级期刊IEEE Transactions on Audio, Speech and Language Processing(TASLP)。
该论文提出了一种基于解耦量化的Data2vec(DQ-Data2vec)方法用于多语种ASR,该方法包含一个Data2vec主干网络和两个改进的在线K-Means量化器。论文的核心思想是使用指定K-Means的聚类数的方法来对语种和音素信息进行解耦,以用于掩码预测。具体而言,在语种量化过程中,鉴于语种数量与其他无关特征(如说话人)数量存在显著差异,通过设置聚类数与语种数量相匹配,从而明确地将浅层中与语种信息从无关特征中解耦出来。 这一策略同样应用于将中层的音素从单词特征中解耦。CommonVoice数据集上的实验表明,在自监督和弱监督场景下,DQ-Data2vec与Data2vec和UniData2vec相比,音素错误率(PER)相对降低了9.51%和3.75%。
论文题目:DQ-Data2vec: Decoupling Quantization for Multilingual Speech Recognition
作者列表:邵琪杰, 董林昊, 魏坤, 孙思宁, 谢磊
论文链接:https://arxiv.org/abs/2501.13497
近年来,基于自监督学习(SSL)的多语种语音识别方法[1-4]通过充分利用无标签的语音数据,取得了显著的成绩。根据预训练中所使用的数据,这些SSL方法可以分为两类:(a)标准自监督学习方法,预训练中不依赖任何标注数据,例如XLS-R[1]和BEST-RQ[2];(b)弱监督学习方法,预训练中额外结合了非目标语种的标注数据,例如UniSpeech[3]和UniData2vec[4]。
Data2vec[5]是一种代表性的语音SSL方法,它基于教师-学生(teacher-student)框架,其中教师模型负责为被屏蔽的帧生成由前K层输出的平均而得出的语音标签,然后激励学生模型从未被屏蔽的上下文信息中重建这些目标帧的标签。教师分支与学生的结构完全相同,并且通过EMA方法从根据学生模型的参数进行更新。这确保了教师模型拥有与学生模型相近的上下文理解能力,从而产生连续且与上下文相关的目标语音标签。这种连续语音标签比wav2vec 2.0、hubert中使用的离散标签包含更多信息,从而带来更出色的语音识别性能。
尽管Data2vec在多语种语音识别中已被证明有效,但它并未能充分利用一些对多语种语音识别任务有帮助的信息[6](如跨语种共享音素和语种信息),这限制了其的性能进一步提升。先前Pasad等人的[7]表明,Data2vec的浅层捕捉与说话人和语种相关的信息,中层包含与音素和单词相关的信息,而更深层则负责重建。但是在Data2vec中构造语种和音素相关的语音标签却并非易事,因为教师模型前K层的平均操作将与音素和语种相关的信息耦合在一起。此外,即使分别对浅层和中层的输出进行平均,由于同一层中仍然存在其他不相关的细节(例如说话人和单词),这种耦合依然存在,这使得无监督地解耦与音素和语种相关的信息变得具有挑战性。
本文提出了一种基于解耦量化的多语种SSL框架DQ-Data2vec(Decoupling Quantization based Data2vec),它由一个Data2vec主体结构和两个经过改进的在线K-Means量化器组成。本文的核心思想是使用具有指定聚类数量的K-Means量化器来解耦语种和音素信息,以优化掩码预测的效果。具体而言,在自监督场景中,首先,本文的DQ-Data2vec利用Data2vec作为主体结构,从教师模型分支中提取浅层和中层特征。这确保了所提取的特征中包含了语种和音素的特性。然后,本文进一步改进了经典的在线K-Means向量量化器,以便从无关的细节中解耦出语种和音素的特性。在语种量化方面,考虑到语种的数量与其他不相关特征有显著差异,本文通过指定聚类数量与语种数量相对应,从而明确地将与语种相关的信息和与语种无关的信息(例如说话人信息)分离开来。在解耦音素和单词信息时也采用了同样的策略。最后,本文使用对比损失函数来促使学生模型分支重建与语种和音素相关的语音标签。此外,在弱监督场景中,通过有监督损失函数融入语种标签和非目标语种文本标签,同时对量化器的输出和学生模型分支的输出进行约束,从而得到更清晰的语种和音素标签,以进一步提升ASR性能。
如图1所示,DQ-Data2vec包含一个基于教师-学生结构的Data2vec主干结构以及两个在线K-Means向量量化器。这些量化器用于提取与语种和音素相关的声学表征。然后,通过鼓励学生分支重构它们,进而优化模型多语种ASR的效果。
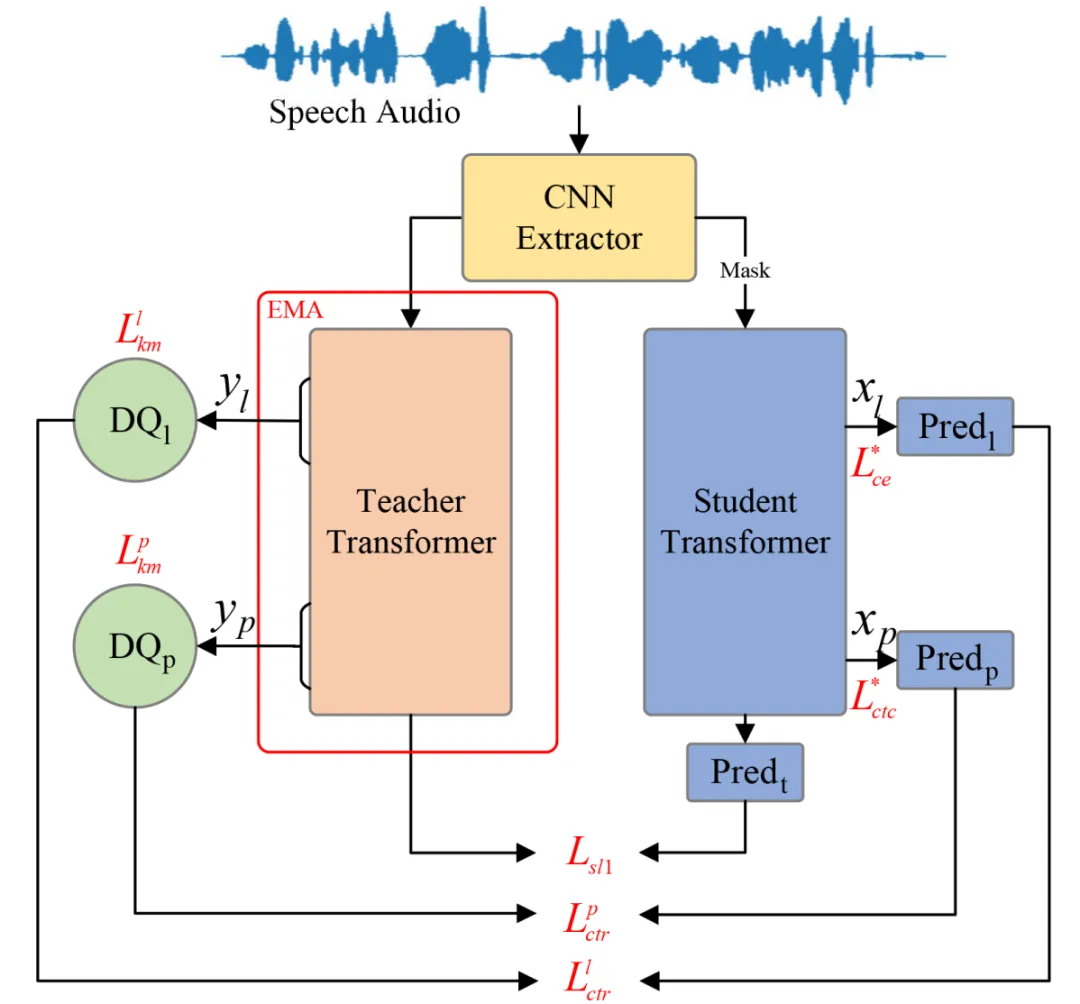
图1 DQ-Data2vec模型的系统结构示意图
Data2vec的主体结构
Data2vec[5]是一种表现出色的语音自监督学习模型。它基于教师-学生框架,其教师分支能够在不同层中表达多样化且未被屏蔽的信息。这种多样化的表示,是随后进行量化解耦以提取语种和音素信息的基础。此外,自监督学习是一种微妙的平衡状态,在预训练过程中容易出现坍塌的情况,在引入多个量化器后,这种脆弱性会尤为明显。而Data2vec的主干结构可以稳定训练过程,有效缓解引入量化器带来的问题。具体而言,Data2vec的主体结构包含一个CNN特征编码器、一个教师Transformer编码器和一个学生Transformer编码器。教师编码器的参数通过EMA方法从学生编码器更新,并且停止所有梯度反向传播。Data2vec骨干的计算过程可以简要记录如下:
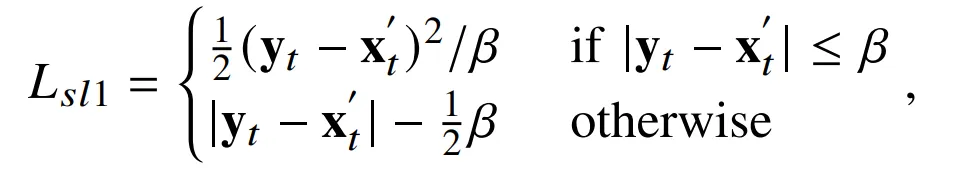
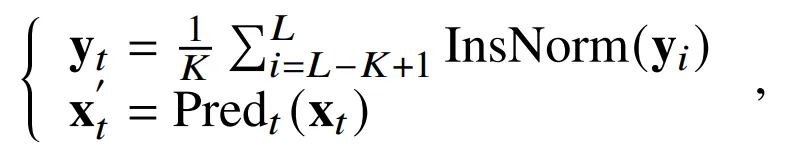
浅度解耦
研究表明[7],Data2vec浅层捕捉与说话人及语种相关的信息,中层包含与音素及单词相关的信息。然而,某一层可能耦合着多种类型的信息,例如,语种和说话人信息可能共存于同一浅层中。本文通过引入两个改进型在线K-Means量化器,用于从Data2vec教师分支中进一步解耦语种和音素表征。如图2所示,具体来说,当试图提取句子级别且与语种相关的语音表征时,引入时间维度的池化可以消除帧级别的信息,并且进一步调整聚类中心的数量使其与语种的数量相匹配,能够显著地解耦说话人信息。在需要帧级别且与音素相关的目标语音标签的情况下,可以将聚类中心的数量设置为音素的数量,并且可以省略时间池化。
在本章研究中,作者将这种情况称为浅度解耦,它不依赖于任何带标签的数据,仅通过指定层的位置、聚类中心的数量以及是否使用池化来明确语音表征的内容。值得注意的是,将聚类数量设置为语种数量的目的,并非是要在量化表征和语种之间建立一一对应的映射关系,因为缺乏标签的约束,这种一一对应是不切实际的。本章的动机在于利用无关信息和目标信息在数量级上的差异,使聚类结果尽可能接近目标。
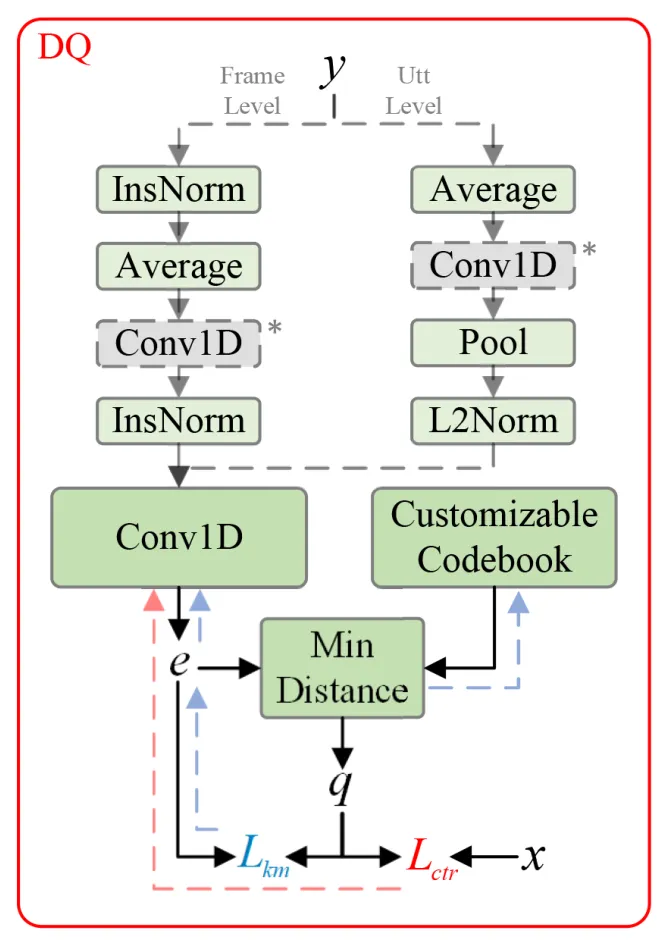
图2 解耦量化器示意图
深度解耦
利用无标注数据建立的语种和音素量化的浅度解耦是一种弱约束,其准确性有限。引入标注数据有望进一步提高量化语音表示的质量。与低资源语种的文本标注相比,非目标高资源语种的语种标注和文本标注更容易获取。利用这些标注可以在不显著增加成本的情况下进一步提升本章方法的性能。借鉴于Uni-Speech[3]和UniData2vec[4],作者将这种额外使用了非目标高资源语种的文本标注,以及所有语种标注的场景称为深度解耦。
在深度解耦的情况下,通过将学生层的输出x和量化向量q以1:1的比例混合,创建了一种统一的声学表示,记为u。具体如下:
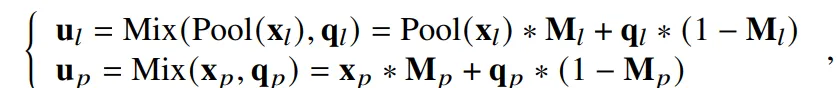
然后,对于语种和音素的显式约束分别使用CE和CTC损失,计算如下:
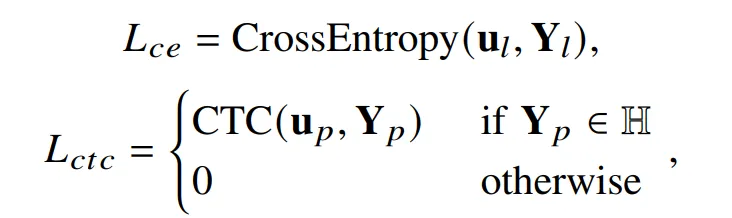
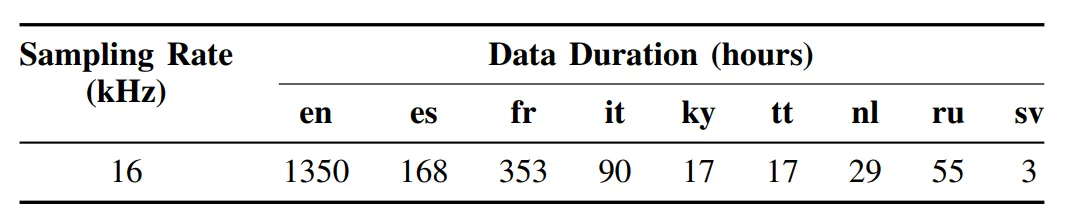
本文使用CommonVoice 6.0 [8]多语种数据集中的9个语种,其中各语种只有1小时被作为标注数据使用,其余数据均作为无标签数据使用。数据集具体如表1所示:
表1 CommonVoice 6.0数据集详情
其余主要设置如下:
用phonemizer为所有语种提取IPA音素,并共享同一个含169音素的词典;
使用fairseq预训练了400k步,微调阶段有13k步;
考虑到数据严重不平衡,引入了数据平衡策略。
浅度解耦和深度解耦的有效性
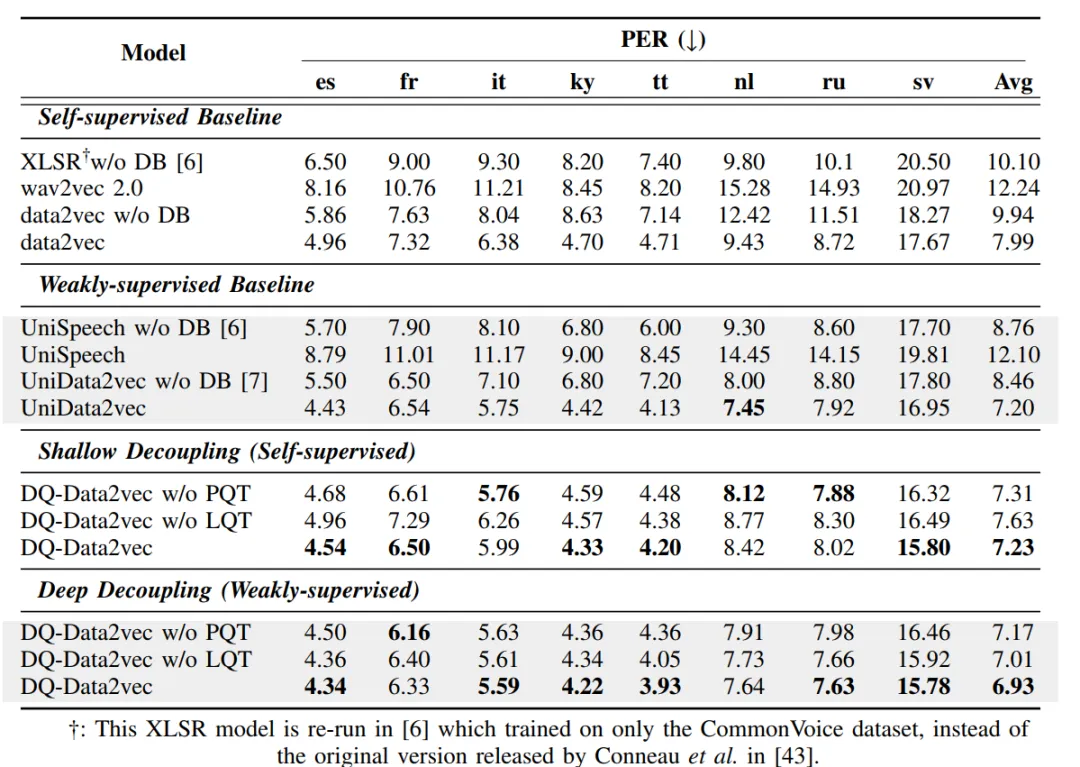
如表2所示,在自监督基线中,可看到data2vec取得了最好的效果,PER为7.99,这包括了数据平衡的贡献。与之相比,DQ-Data2vec在浅度解耦场景下的PER为7.23%,相对降低了9.51%。在弱监督基线中,同样地,Unidata2vec取得了最好的效,PER为7.20,而DQ-Data2vec在深度解耦场景下相对降低为3.75%。
表2 CommonVoice数据集上的音素错误率(PER)。实验默认使用了第3节B部分中提到的数据平衡策略。表格中的DB、PQT和LQT分别指数据平衡、音素量化器和语种量化器。灰色背景表示使用英语文本标签以及所有语种标签进行的实验。
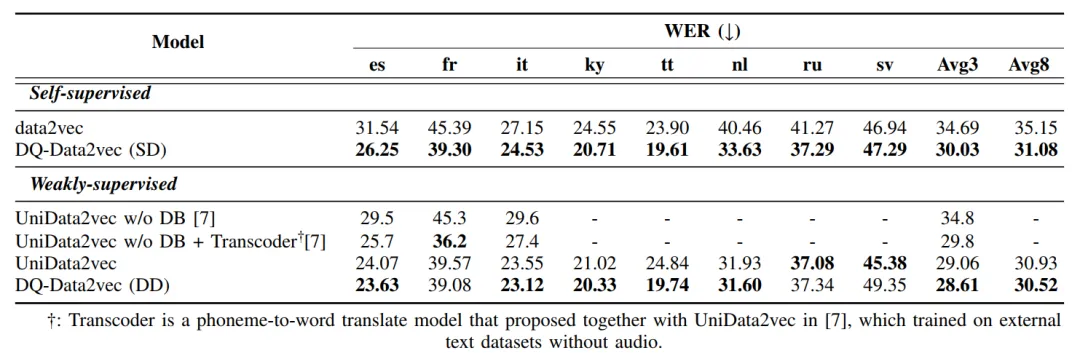
此外,本文还进行了字母级微调以进一步验证词错误率(WER)上的效果,实验结果如表3所示。总体来说,DQ-Data2vec在WER上依然可以展现出对于Data2vec和UniData2vec的优势,即使后者还是用了含有大量文本信息的Transcoder模块。
表3 CommonVoice数据集上的词错误率(WER)。表格中的SD和DD分别指浅度解耦和深度解耦。
量化器性能分析
语种聚类效果如图3所示,从图中可以看出,即使是没有使用语种标签的浅度解耦场景,语种聚类效果也十分显著,从图中可以清晰地看到语种和聚类中心的对齐关系。而对于引入了标签的深度解耦场景,聚类效果进一步提升,甚至LNMI指标已经接近于1,这也符合预期。
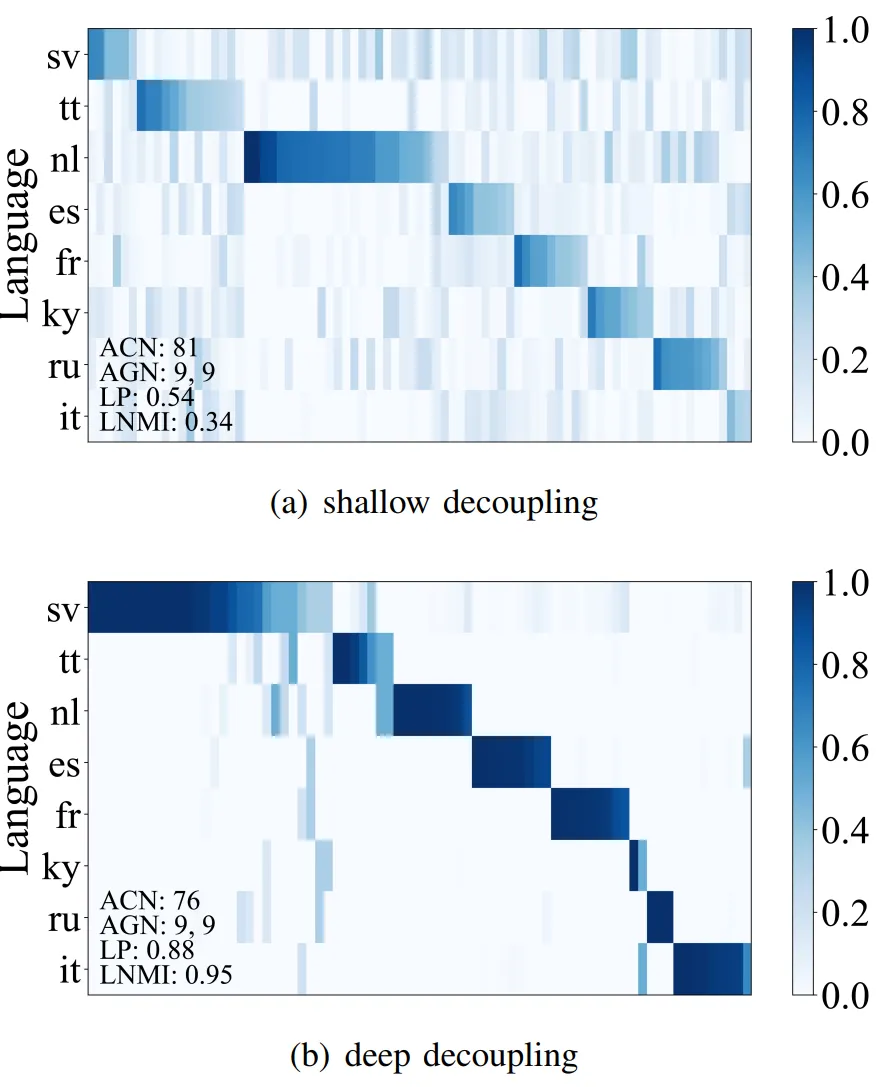
图3 CommonVoice测试集上的语种聚类条件概率P(lang|code)。在图中,ACN表示有效码本项数量,而AGN表示两个聚类组内的有效聚类。LP表示语种纯度,LNMI指的是经过语种归一化处理的互信息。
音素聚类效果如图4所示,从图中可以看出,在浅度解耦场景,图中右上角出现了一条较淡的对齐路径,虽然不够醒目但确实是存在的。而深度解耦场景的对齐效果显著增加,可以看见清晰的对齐路径。音素聚类的PNMI在0.2~0.3之间,低于类似评估中其他主流方案(如HuBERT为0.6-0.7)。
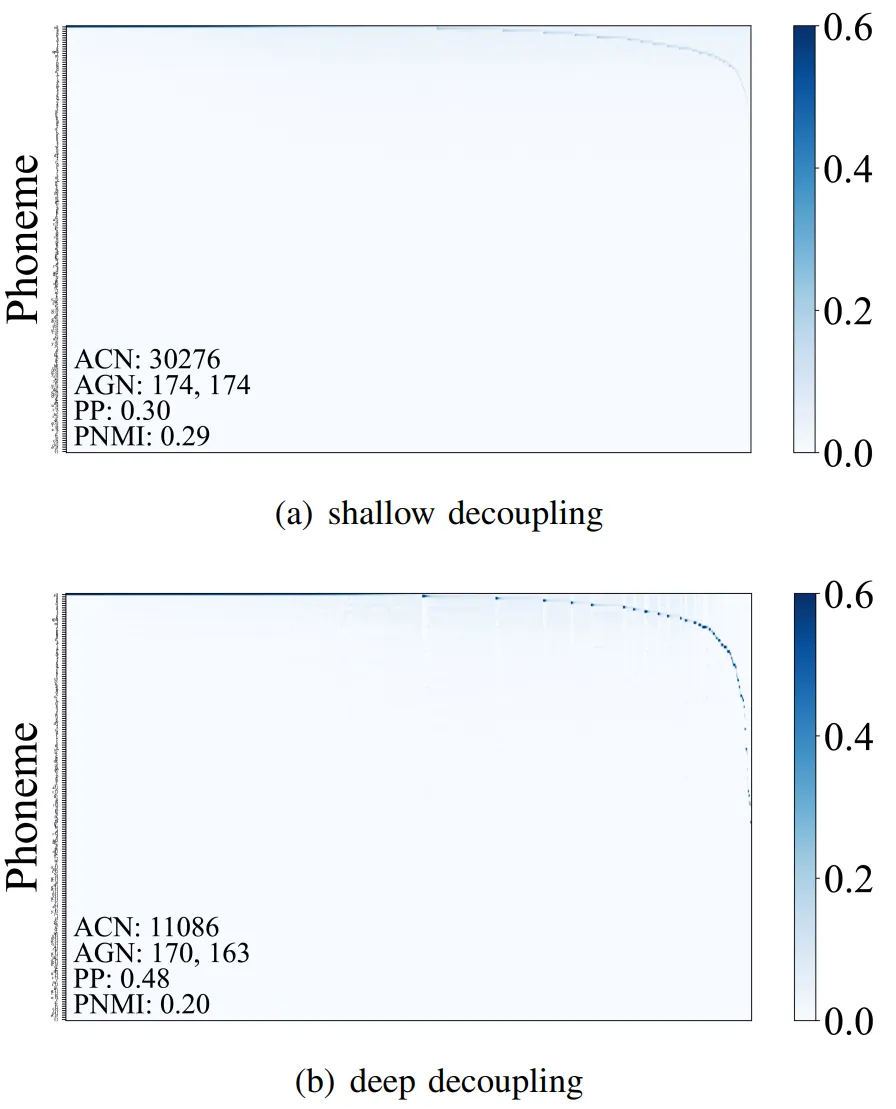
图4 CommonVoice测试集上的音素聚类条件概率P(phone|code)。在图中,ACN表示有效码本项数量,而AGN表示两个聚类组内的有效聚类。PP表示音素纯度,PNMI指的是经过音素归一化处理的互信息。
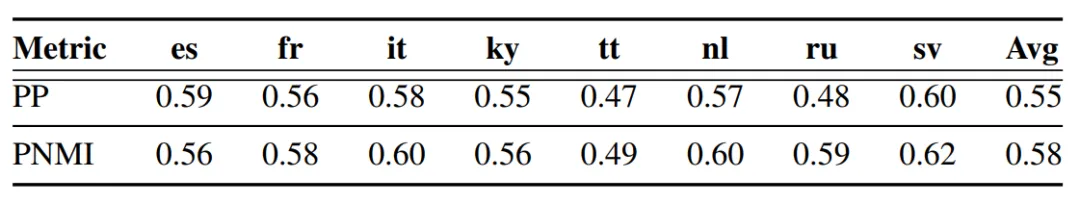
为进一步研究PNMI较低和浅度解耦对齐路径模糊的原因,本文将所有语种分开进行了独立统计,结果如表4所示。实验发现对齐路径显著变清晰,而且PNMI大幅度提高至0.5-0.6之间,已和HuBERT非常接近。这种差异主要归因于音素分布的不平衡。具体来说,在单个语种的测试集中,音素数量在29到90之间,而多语种测试集则包含总共174个音素,这表明许多音素仅在一种语种中出现。然而,无论是在单个语种还是多语种测试集中,静音('sil')的出现概率都约为33%。因此,在单个语种的测试集中,剩余的28到89个音素共享约67%的概率,而在多语种测试集中,由173个音素共享这67%的概率。显然,在多语种测试集中,每个音素的观测概率远低于单个语种测试集,这导致了PNMI和PP的较差表现。当统计单个语种的聚类性能时,DQ-Data2vec的音素量化器的PNMI显著增加,这证明了DQ-Data2vec中音素聚类的有效性。
表4 各语种分开统计的浅度解耦聚类指标
本文提出了DQ-Data2vec,这是一种用于多语种ASR的解耦量化SSL方法。该方法专门为获取音素和语种知识而设计,以提升多语种自监督学习中的ASR任务表现。该方法融入了基于教师-学生架构的主干网络以及两个经过改进的在线K-Means向量量化器。在浅度解耦的情况下,两个K-Means量化器从教师网络不同层中提取与离散语种和音素相关的语音表示,并通过指定码本数量和池化操作来对量化器对象加以约束。此外,在深度解耦的情况下,我们研究了纳入语种标签和非目标语种文本标签的方式,以便在量化向量与音素或语种之间建立更明确的关系。我们在多语种CommonVoice数据集上进行了充分的实验,证明了所提出模型的有效性。
[1] A. Babu, C. Wang, A. Tjandra, K. Lakhotia, Q. Xu, N. Goyal, K. Singh, P. von Platen, Y. Saraf, J. Pino, A. Baevski, A. Conneau, and M. Auli, “XLS-R: Selfsupervised cross-lingual speech representation learning at scale,” in Proc. INTERSPEECH, 2022, pp. 2278–2282.
[2] C.-C. Chiu, J. Qin, Y. Zhang, J. Yu, and Y. Wu, “Self-supervised learning with random-projection quantizer for speech recognition,” in Proc. ICML, 2022, pp. 3915–3924.
[3] C. Wang, Y. Wu, Y. Qian, K. Kumatani, S. Liu, F. Wei, M. Zeng, and X. Huang, “Unispeech: Unified speech representation learning with labeled and unlabeled data,” in Proc. ICML, 2021, pp. 10 937–10 947.
[4] H. Xue, Q. Shao, P. Chen, P. Guo, L. Xie, and J. Liu, “TranUSR: Phoneme-to-word transcoder based unified speech representation learning for cross-lingual speech recognition,” in Proc. INTERSPEECH, 2023, pp. 216–220.
[5] A. Baevski, W.-N. Hsu, Q. Xu, A. Babu, J. Gu, and M. Auli, “Data2vec: A general framework for self-supervised learning in speech, vision and language,” in Proc. ICML 2022, pp. 1298–1312.
[6] V. Pratap, A. Sriram, P. Tomasello, A. Hannun, V. Liptchinsky, G. Synnaeve, and R. Collobert, “Massively multilingual ASR: 50 languages, 1 model, 1 billion parameters,” in Proc. INTERSPEECH, 2020, pp. 4751–4755.
[7] Pasad, J.-C. Chou, and K. Livescu, “Layer-wise analysis of a self-supervised speech representation model,” in Proc. ASRU, 2021, pp. 914–921.
[8] R. Ardila, M. Branson, K. Davis, M. Kohler, J. Meyer, M. Henretty, R. Morais, L. Saunders, F. Tyers, and G. Weber, “Common Voice: A massively-multilingual speech corpus,” inProc. LREC, 2020, pp. 4218–4222.
