
 语音小管家
本文将为大家介绍“Falcon: A Remote Sensing Vision-Language Foundation Model”(Falcon:遥感视觉语言基础模型)。
Title:Falcon: A Remote Sensing Vision-Language Foundation Model
Paper:https://arxiv.org/abs/2503.11070
Code:https://github.com/tianhuilab/falcon
导读
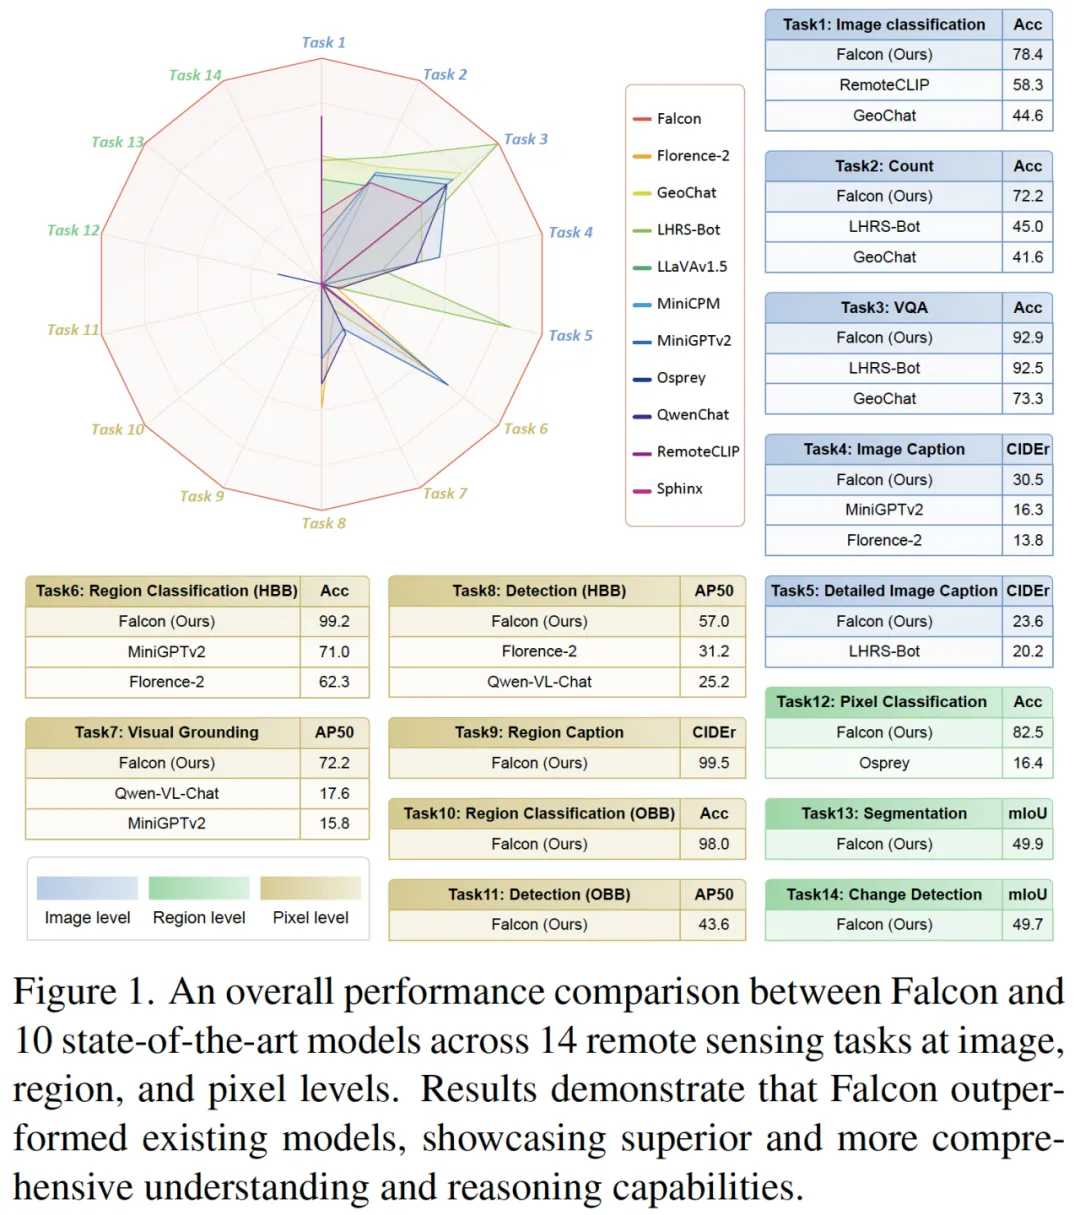
本文提出了一种面向遥感领域的视觉-语言基础模型Falcon,通过基于自然语言指令的提示范式,实现在图像、区域和像素三个层级的综合理解与分析。该模型能够基于简单语言指令和遥感图像,完成图像分类、目标检测、分割、描述等14种任务。为提升模型表征能力,研究团队构建了包含7800万高质量样本的Falcon SFT数据集,涵盖560万张多分辨率、多视角遥感图像,并通过人工核验确保数据可靠性。实验表明,仅0.7亿参数的Falcon在67个数据集上的14项任务中均取得优异表现,其完整数据集、代码和模型权重已在GitHub开源,为遥感开源社区发展提供新动能。
引言
视觉语言模型(LVLMs)在自然图像的视觉-语言任务中表现卓越,但由于遥感图像与自然图像存在显著的领域差异和知识鸿沟,开发遥感基础模型仍面临重大挑战。现有研究多局限于特定任务的专用模型(如GeoChat和RSGPT),缺乏适应复杂多场景的通用能力。随着人工通用智能(AGI)的发展,构建具备全面感知与推理能力的遥感基础模型具有重要价值,但需解决两大核心问题:一是现有模型缺乏跨任务的通用表征能力,难以支撑多层次理解;二是缺乏高质量、大规模的多任务训练数据集。
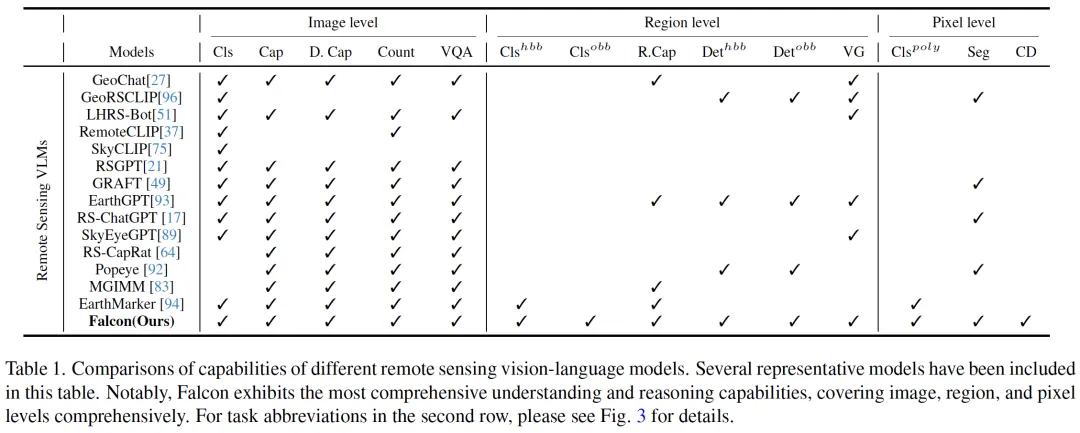
为此,研究者提出Falcon——首个面向遥感领域的多功能视觉语言基础模型,其创新性体现在三个方面:首先,通过统一架构整合图像级、区域级和像素级推理能力,首次实现单模型同时处理14类遥感任务(涵盖分类、检测、分割、图像描述、变化检测等),突破了传统模型(如仅支持有限任务的GeoChat和RSGPT)的应用局限。其次,设计受自然图像领域启发的空间层次与语义粒度融合机制,采用视觉编码器与多模态编解码器协同框架,实现跨模态表征对齐,无需额外模块即可适配多样化任务。此外,引入动态提示训练策略,通过多版本指令优化提升模型对用户指令的理解泛化能力,确保输出文本形式的统一性。
为支撑模型训练,团队构建了Falcon SFT数据集——截至2025年3月规模最大、覆盖最广的遥感多任务指令调优数据集。该数据集包含7,800万高质量样本,涵盖560万张多分辨率、多视角遥感图像,通过统一格式标准化解决了早期数据集(如单任务或小规模多模态数据)的局限性。实验验证部分,研究采用定性可视化对比与定量下游任务评估相结合的方式,证明Falcon在已知任务和零样本场景下的优越性能,并通过消融实验验证训练策略的有效性。值得注意的是,研究团队承诺将完整开源数据集、代码及模型权重,以弥合遥感与自然图像基础模型间的技术鸿沟,推动领域发展。
论文贡献可归纳为三点:1)Falcon作为首个支持图像-区域-像素三级14任务统一的遥感视觉语言模型,填补了通用表征能力的空白;2)Falcon SFT数据集以规模化和多任务特性成为领域训练资源新标杆;3)通过系统性实验验证模型性能优势,开源计划为社区提供关键基础设施,助力遥感模型的实际应用与后续研究。
方 法
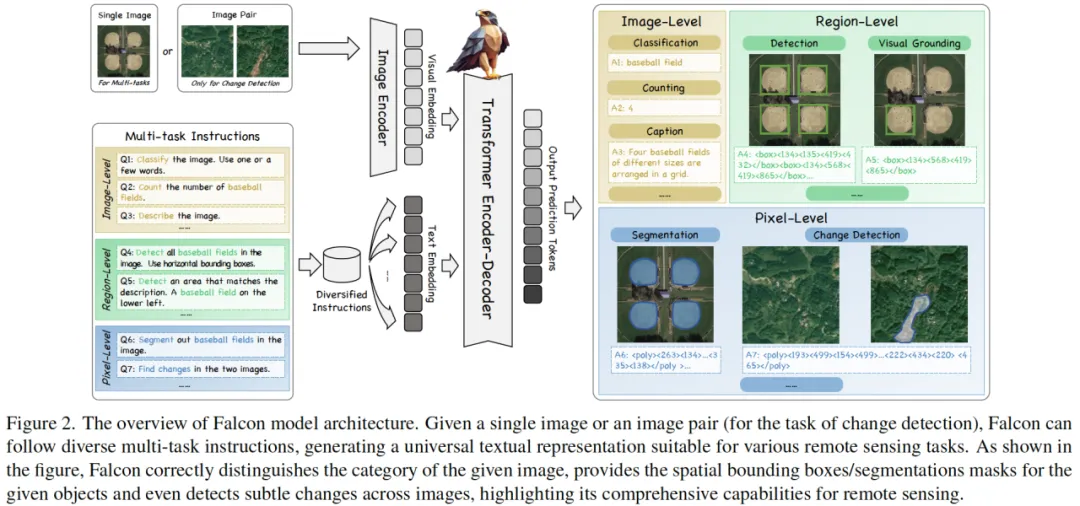
该论文提出了Falcon框架,旨在通过统一的序列到序列架构解决多模态遥感任务的复杂性。其核心设计包含以下关键组成部分:
多模态嵌入与架构设计
Falcon采用基于Transformer的编码器-解码器架构F,将图像与文本输入统一为序列化表示。具体流程为:
图像输入I通过视觉编码器G提取视觉标记嵌入V∈R^(Nv×Dv),其中Nv为标记数量,Dv为维度;
文本提示T通过嵌入函数E转化为文本标记E(T)∈R^(Nt×D);
通过视觉适配器将V转换为与文本维度对齐的V'∈R^(Nt×D),并与E(T)拼接形成多模态输入X=[V', E(T)],作为编码器-解码器的输入。该设计实现了跨模态特征融合,同时保持任务无关性。
动态提示训练策略
为减少对任务特定标记的依赖,Falcon提出动态提示生成机制:
对原始提示T,从预定义池中采样M个语义相似但表达形式不同的变体{T'_i};
生成多组输入X={[V', E(T'_i)]}进行联合训练。该策略通过增强语言表达的多样性,提升了模型对自然语言指令的鲁棒理解能力。
任务统一表示方法
所有任务被重构为序列翻译任务,关键创新包括:
空间坐标量化:将边界框坐标离散化为1000个区间,以标签及量化坐标标记形式嵌入指令(如:"Describe the x1 y1 x2 y2 in the image.");
扩展分词器:在词汇表中新增位置标记类型,支持坐标与文本的联合编码;
结构化指令模板:根据不同任务需求设计标准化指令模板,例如区域描述任务采用"Describe the ..."的固定句式,实现输入输出格式的统一。
优化目标与训练
采用交叉熵损失函数进行端到端优化,覆盖14种遥感任务:
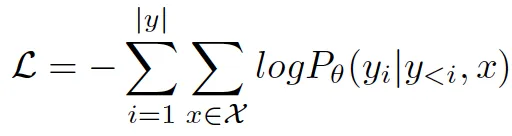
数 据
该研究团队为提升Falcon模型的图像、区域及像素级多模态理解能力,构建了首个大规模遥感多任务指令微调数据集Falcon SFT。该数据集通过系统性整合多源遥感数据与创新性指令生成方法,实现了跨模态训练数据的标准化处理与多样性扩展,具体构建过程包含以下关键环节:
数据收集与预处理
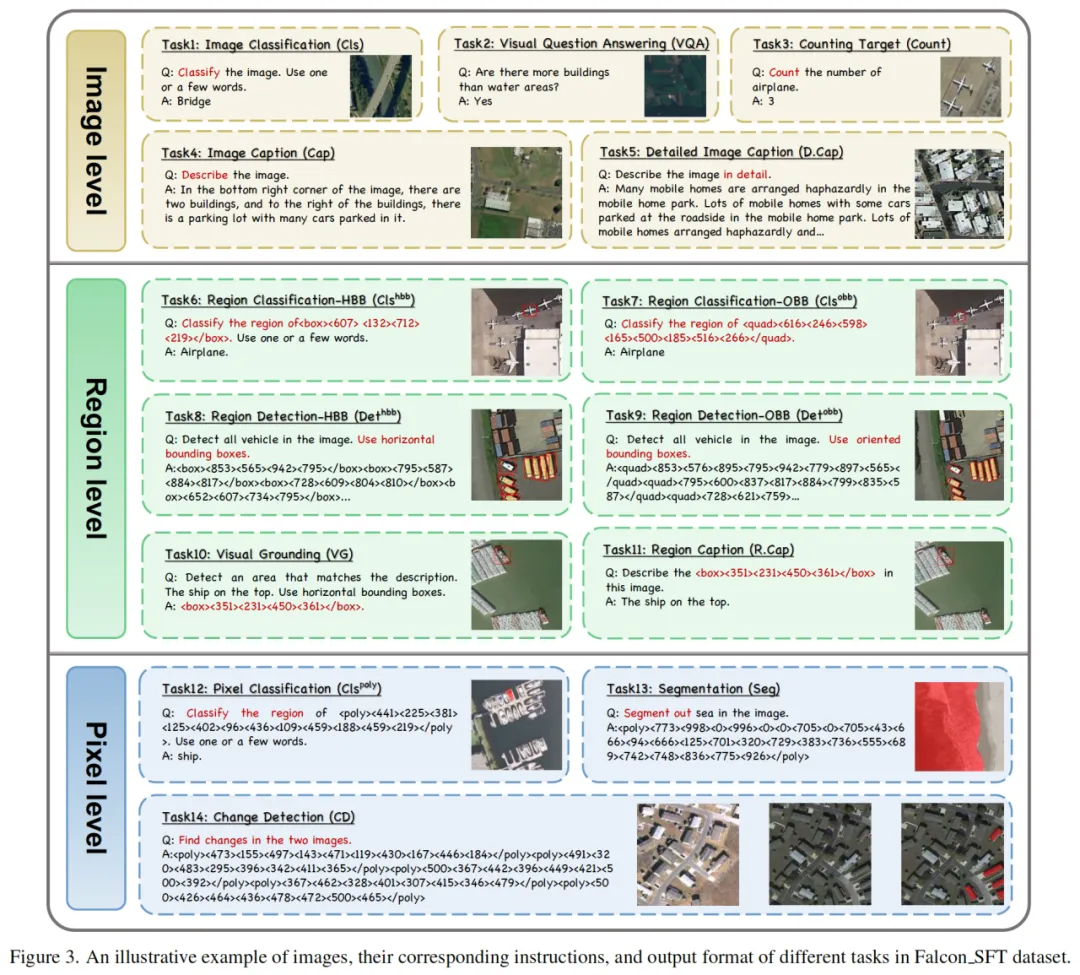
研究团队从卫星、航空器、无人机等平台收集了90个开源RGB遥感数据集(如Million-AID、RSICD、DOTA等),经人工筛选保留67个高质量数据集,涵盖多分辨率、多视角特性。通过统一标注格式(将多边形、掩码图像等异构标注标准化)并扩展原有数据结构,将任务类型拓展至14种,形成三级空间层次体系:
图像级(5类):图像分类、视觉问答、目标计数、图像描述及细粒度描述
区域级(6类):基于水平/旋转框的分类检测、视觉定位及区域描述
像素级(3类):像素分类、分割及变化检测
指令生成机制
为实现视觉语言模型的指令驱动训练,团队设计了三阶段指令生成流程:
定义模板指令:针对14类任务定制结构化指令模板,例如物体检测任务采用"Detect in the image. Use Rotated bounding boxes."作为触发指令,配合四顶点千分位坐标的标签规范。
生成图像-指令对:基于任务类型将模板指令与对应图像及标注绑定,构建结构化训练样本,使模型能通过多样化指令学习任务响应。
构建多指令池:利用大语言模型对基础指令进行语义扩展,生成不同复杂度与表达方式的指令变体(如将"Describe the image."扩展为3种差异化表述),以此增强模型的语言泛化能力,降低对特定指令模式的依赖性。
数据集特征
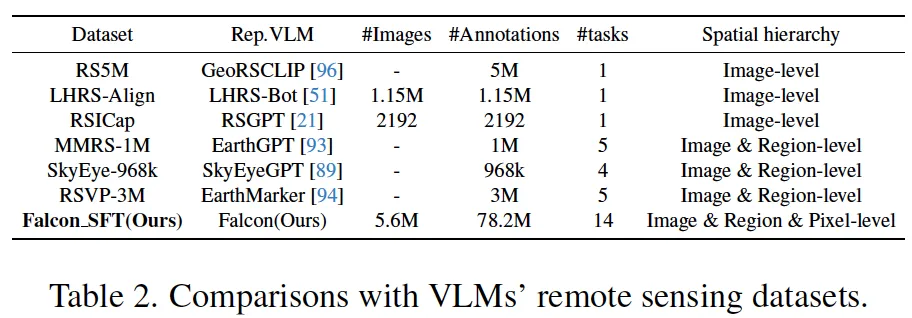
最终构建的Falcon SFT数据集包含7,800万高质量样本,覆盖560万张多源遥感图像,其规模与任务覆盖度显著超越现有同类数据集(如样本量达78倍于次优数据集)。数据集同时具备以下技术优势:
空间层次完整性:首次同步覆盖图像、区域、像素三级空间解析需求;
标注多样性:整合多平台数据并实现跨数据集标注格式统一;
指令鲁棒性:通过多指令池机制生成语义等效的指令变体,提升模型泛化性能;
研究团队同步公开了数据集的元信息(图像尺寸、空间分辨率、数量)与下载路径,为后续研究提供了标准化数据基准。
实 验
该研究通过系统性实验评估了Falcon多模态大模型在遥感领域的性能表现,重点验证其在图像级、区域级和像素级任务的综合能力。实验部分包含以下核心内容:
模型架构与训练配置
Falcon采用图像编码器与基于Transformer的编码器-解码器架构,参数量总计0.7B。模型初始化采用预训练权重,通过调整输出token长度至4096增强细节表征能力。训练阶段使用160块Nvidia A100 GPU进行4天训练,配置448×448分辨率输入、640批次大小和1e-5学习率。
多层级任务性能
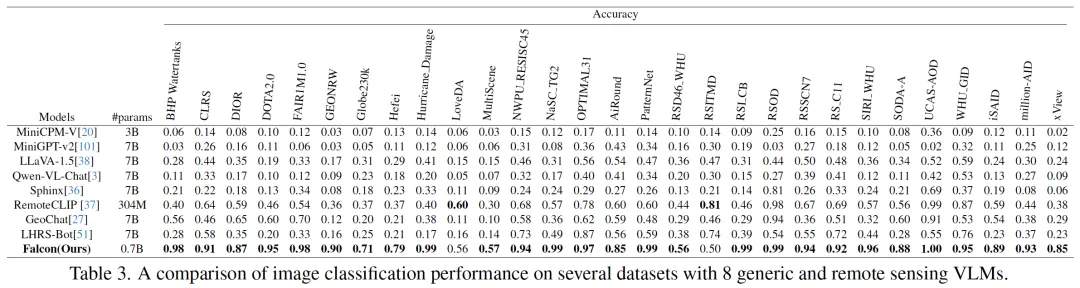
在图像级任务中,Falcon在分类、目标计数和视觉问答任务上均超越对比模型。相较于通用视觉语言模型(MiniGPT-v2、Qwen Chat)和遥感专用模型,其以更少参数实现更高准确率,尤其在需组合感知的计数任务中展现显著优势。图像描述任务通过人工评估显示,Falcon在细节丰富性、位置准确性和幻觉抑制三个维度均获最高评分。
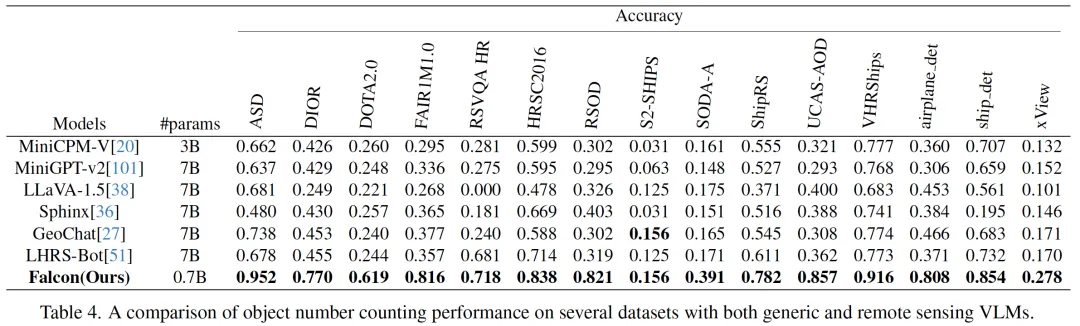
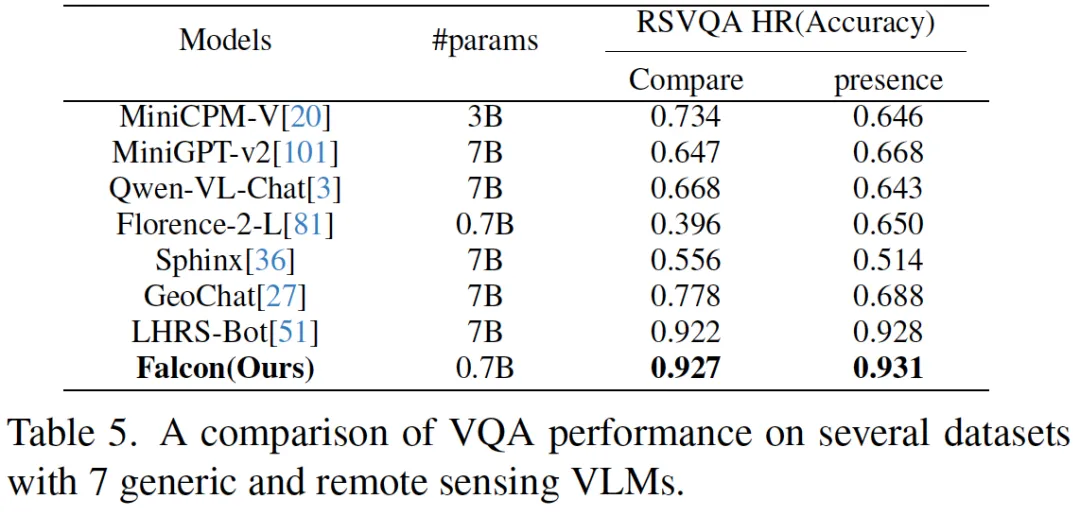
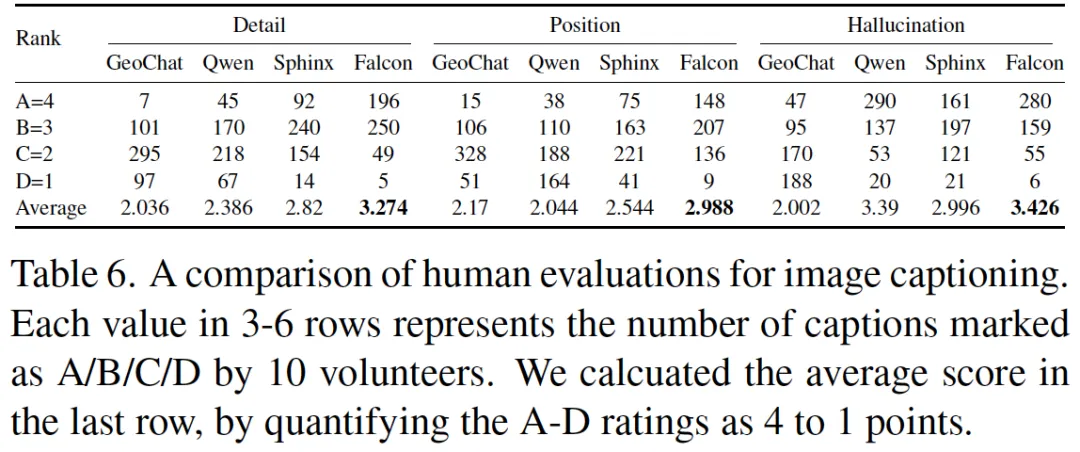
区域级任务方面,Falcon在目标检测任务中突破传统视觉语言模型的定位能力瓶颈,其水平边界框检测性能优于所有基线模型。
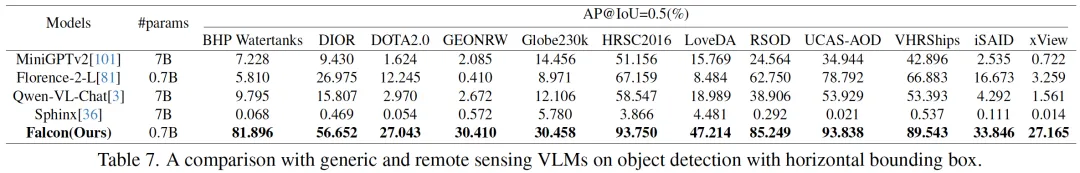
像素级任务表现则具有突破性意义,该模型成为首个在分割与变化检测任务中实现有效输出的视觉语言模型,成功完成复杂目标分割及相似图像差异识别。

零样本泛化能力
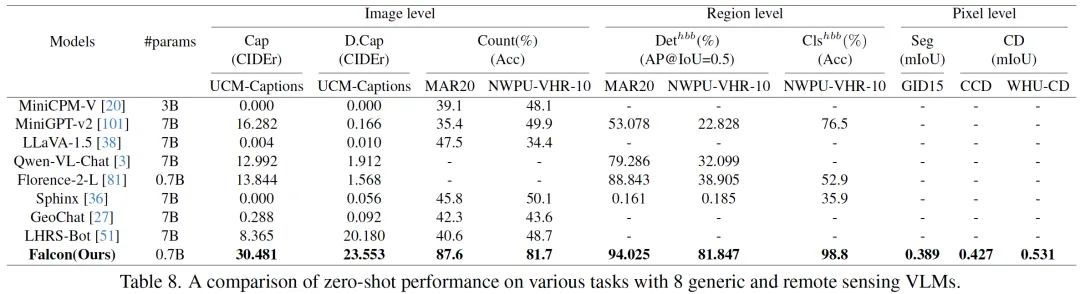
在未参与训练的零样本数据集评估中,Falcon在图像级(UCM-Captions、MAR20)、区域级和像素级任务均刷新性能记录。特别是在需要精确定位与推理的区域/像素级任务中,其表现远超缺乏相关能力的传统模型。
结论
该论文提出了Falcon,面向遥感领域设计的视觉语言基础模型,其通过整合多源感知与推理能力实现了对遥感数据的深度理解。为支撑模型训练,研究团队构建了包含7800万高质量样本的Falcon SFT数据集,其中覆盖560万张遥感影像样本,形成了目前已知规模最大的遥感领域多模态训练集。通过系统性的定性与定量实验验证,该模型在14类遥感视觉语言任务场景(涵盖超过100个测试数据集)中展现出卓越的零样本泛化能力和数据集内适应性能,特别是在图像描述生成、多模态检索、地物分类等核心任务上取得突破性进展。研究团队承诺将完整开放数据集、算法框架及预训练权重,旨在为遥感智能解译领域的研究提供基础支撑,推动多模态遥感分析技术的持续发展。
