NVIDIA 开源 Audio Flamingo Next:百万小时音频训练、时间戳 CoT 推理,长音频理解超越 Gemini 2.5 Pro

标题:《Audio Flamingo Next: Next-Generation Open Audio-Language Models for Speech, Sound, and Music》 链接:https://arxiv.org/a…
27 0 0

标题:《Audio Flamingo Next: Next-Generation Open Audio-Language Models for Speech, Sound, and Music》 链接:https://arxiv.org/a…
为促进语音技术的多元化与包容性发展,推动人工智能真正惠及每一位用户,希尔贝壳秉持“技术向善”的理念,联合西北工业大学、中国科学技术大学、南开大学、昆山杜克大学、新加坡南洋理工大学、佐治亚理工学院、StammerTalk、WeNet等顶尖学术…
本文来源丨蚂蚁灵波科技 从3000小时到整整20000小时。真实世界数据里的Scaling Law,直接喂出了个最强VLA(Vision-Language-Action)基座模型! 这就是蚂蚁灵波今天开源的具身智能基座模型——LingBot…
为促进语音技术多元化发展、推动AI在特殊语音场景下的研究与落地,希尔贝壳联合昆山杜克大学正式开源“AISHELL-6-Whisper 语料库”。作为稀缺的耳语—正常音平行对齐资源,本数据集的发布旨在填补相关领域开源数据的空白,为学术界与工业…
来源丨机器之心、具身智能大讲堂 Gen Robot.AI团队在Hugging Face平台公开了10Kh RealOmni-Open数据集,该数据集累计包含超10000小时数据、100万+任务剪辑,存储总量达95TB,是当前行业内规模领先的…
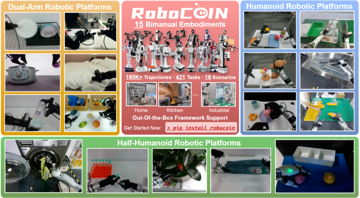
在具身智能迈向真实世界应用的关键阶段,大规模、高质量、多平台兼容的机器人操作数据已成为制约技术突破的核心瓶颈。 为破解这一难题,北京智源人工智能研究院联合蚂蚁天玑实验室、银河通用、乐聚、软通天擎、松灵、星海图、智平方、睿尔曼等产业先锋,以及…
主流自动语音识别(ASR)系统在转写词汇内容上表现优异,但普遍忽略了语音中蕴含的叹气、笑声等非语言发声(Nonverbal Vocalizations, NVs)。这一能力缺失限制了系统对人类交流意图与情感的全面理解,使得NV感知ASR(N…
语音理解与生成的飞速发展离不开大规模高质量语音数据集的推动。其中,语音识别(ASR)和语音合成(TTS)被公认为最首要的任务。但对于拥有约 8490 万母语使用者的粤语而言,受限于标注资源匮乏,研究进展缓慢,ASR 与 TTS 的表现始终不…
来源丨故障诊断与Python学习 MIMII声音数据集提供首个专注于工业机器声音的开放数据集,支持无监督异常检测算法的开发与评估,推动自动化设备维护研究。 论文:MIMII DATASET: SOUND DATASET FOR MALFUN…
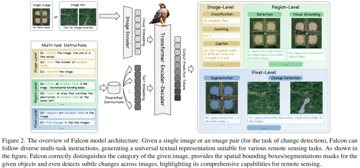
本文将为大家介绍“Falcon: A Remote Sensing Vision-Language Foundation Model”(Falcon:遥感视觉语言基础模型)。 Title:Falcon: A Remote Sensing V…