
 语音小管家
为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期分享五篇发表在ICASSP2025上的文章。本导读论文栏目持续征稿中,欢迎踊跃投稿,投稿方式请参见文末指南。
★ 第1期分享论文列表
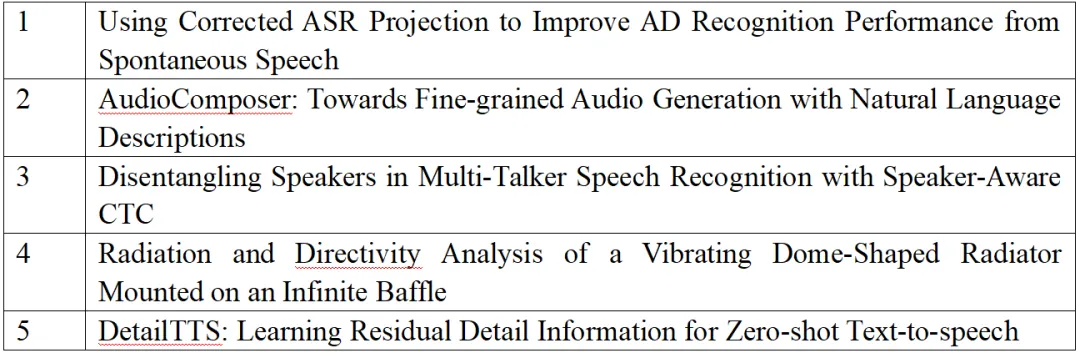
1. Using Corrected ASR Projection to Improve AD Recognition Performance from Spontaneous Speech
论文作者:张云帆,金赟(通信作者), 陈冠霖,马勇,贾懋珅,宋鹏
论文单位:江苏师范大学,北京工业大学,烟台大学
作者邮箱:2020221353@jsnu.edu.cn; jiny@jsnu.edu.cn; 2020221337@jsnu.edu.cn;may@jsnu.edu.cn; jiamaoshen@bjut.edu.cn; pengsong@ytu.edu.cn
论文链接:https://ieeexplore.ieee.org/abstract/document/10890111
论文亮点:
AD和轻度认知障碍(MCI)患者的语言功能受损导致自动语音识别(ASR)转录错误,会在特征提取过程中造成信息损失。为解决这一问题,本文提出了一种修正ASR投影(Corrected ASR Projection, CAP)模型。该模型的核心思想是通过对齐ASR转录文本与人工校正后的文本特征空间,从特征层面修正ASR转录错误带来的信息偏差。从而在测试阶段能够对ASR转录文本特征进行特征空间校正,提高AD识别率。
论文简介:
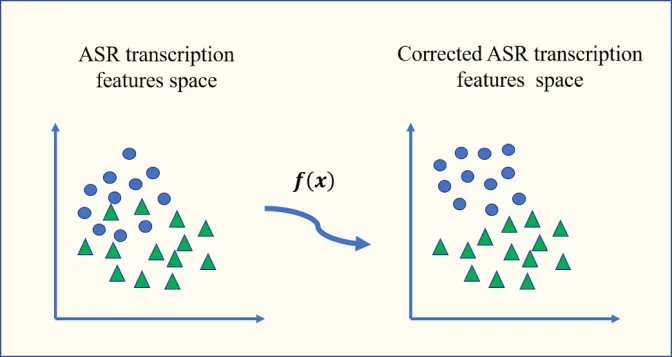
图1 CAP模型特征空间投影示意图
图1为CAP模型特征空间投影示意图。左侧为ASR转录文本的特征空间。右侧为校正后的ASR转录文本的特征空间。在训练过程中,CAP模型利用从ASR转录文本和人工转录文本中提取的文本特征进行训练,获得映射函数f(x)。在实际应用中,获取测试样本的修正文本特征空间是不现实的,因此在测试阶段,ASR转录文本特征通过函数f(x)投影到校正后的文本特征空间进行识别。在CAP模型中,f(x)可用各种神经网络结构来表示。本文中分别采用MLP、CNN和AE的网络结构,获得CAPM、CAPC和CAPA三个模型。
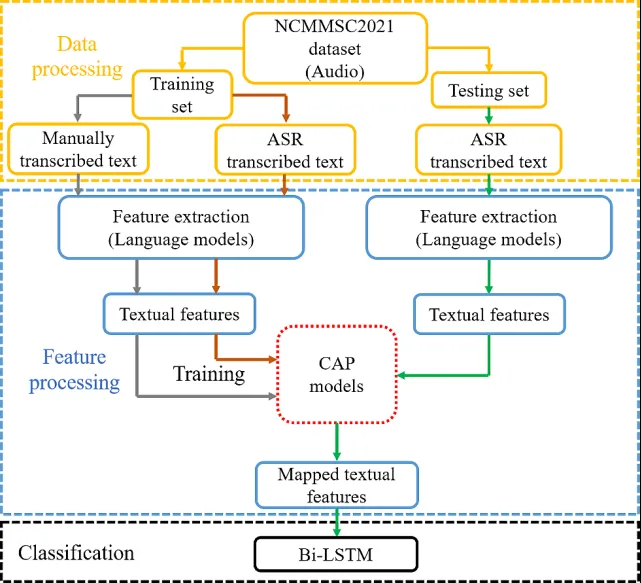
图2 基于CAP模型的AD识别系统
基于CAP模型的AD识别框架如图2所示,主要包括数据处理、特征提取以及分类三个主要步骤。首先对训练集中的语音数据,分别通过ASR和人工校正两种方式进行文本转录,对测试集仅使用ASR进行转录。利用大语言模型从转录文本中提取文本嵌入,然后用文本嵌入进行CAP模型的训练。测试时,把测试样本进行映射后输入到Bi-LSTM中进行分类。
表1 不同神经网络架构的CAP模型性能对比
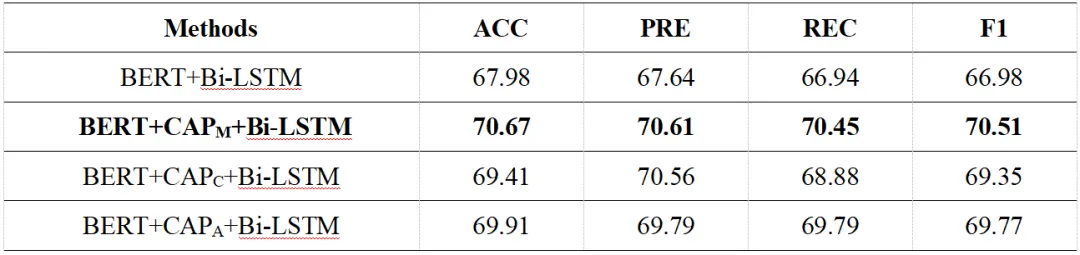
实验结果如表1所示。采用三种神经网络结构的CAP模型均优于BERT+Bi-LSTM基线。其中BERT+ CAPM +Bi-LSTM方法性能提升最为显著。
表2 不同大语言模型对CAP模型性能的影响
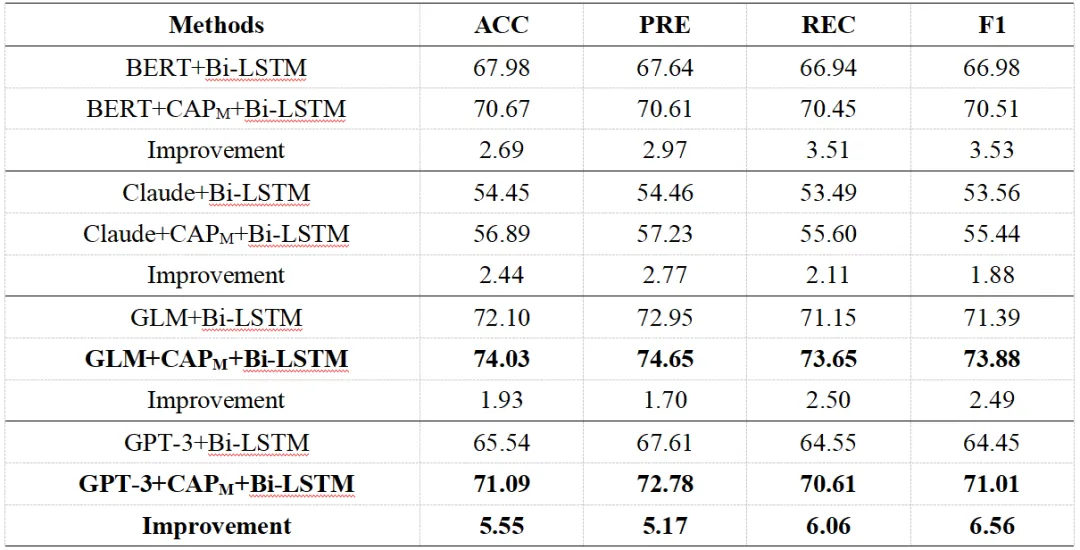
表2对比了4种大语言模型与CAP模型结合前后的性能。所有模型提取的文本特征在用CAP映射后识别性能均获得了不同程度的提升。GPT-3+CAPM+Bi-LSTM组合提升最显著,Accuracy、Precision、Recall和F1提高5.55%、5.17%、6.06%和6.56%,充分验证了CAP模型的有效性。
2. AudioComposer: Towards Fine-grained Audio Generation with Natural Language Descriptions
论文作者:王媛媛,陈航艇,杨东超,吴志勇,吴锡欣
论文单位:香港中文大学,腾讯AI Lab,清华大学
作者邮箱:yywang@se.cuhk.edu.hk
Demo:https://lavendery.github.io/AudioComposer/
Github:https://github.com/lavendery/AudioComposer/tree/main
论文亮点:
现有的TTA模型通常依赖粗略的文本描述作为输入,无法对音频生成进行精细的风格和内容控制,尤其在特定时间点上的音效控制存在很大局限。为了解决这个问题,本文提出了一个新的音频生成框架——AudioComposer,旨在通过自然语言描述(NLDs)实现细粒度的音频生成,该方法结合了流匹配和扩散变换器(DiT)的优势,通过简化的设计和高效的生成过程,显著提高了音频生成的质量和可控性。
论文简介:
随着文本到音频生成技术的不断发展,已有多种方法尝试改进音频的生成质量和可控性。然而,现有的模型大多依赖粗略的文本描述,无法提供对音频内容和风格的精细控制,尤其是在准确控制声音事件的时间、音高和能量方面存在明显限制。本文提出了AudioComposer框架,它只依赖自然语言描述(NLDs),无需附加条件或复杂的网络结构,既能有效指定音频内容,又能控制生成音频的风格,解决了传统方法中的数据稀缺、模型复杂和控制精度差等问题。
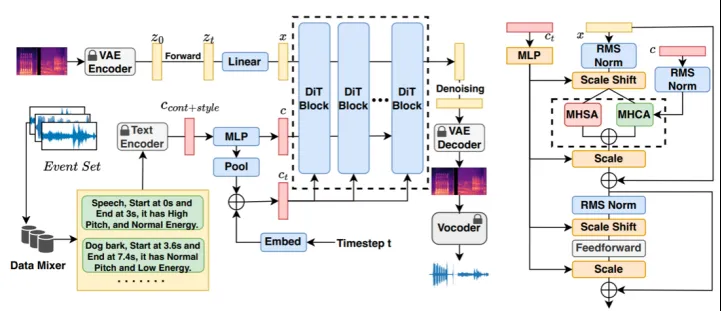
左图为 AudioComposer整体结构,右图为 DiT Block 详细结构。
首先,为了缓解数据稀缺的问题,我们引入了一种创新的在线数据模拟流程,该流程支持细粒度的风格标注,包括时间戳、音高和能量信息,并附带自然语言描述,从而大大提高了训练数据的多样性和丰富性。其次,利用自动数据模拟流程,AudioComposer 完全依赖细粒度的自然语言指导来实现音频生成的精确控制。这种方法无需额外的帧级条件(控制信息)或复杂的控制网络,从而实现了高度的简洁性和效率。最后,我们采用基于Flow的扩散变换器(DiT)结构,通过交叉注意力机制将文本信息嵌入到音频生成的过程中,可以捕捉细粒度文本表示与潜在音频表征之间的内在联系,同时处理音频内容和风格信息,进一步提升了音频生成的速度、质量和可控性。实验结果表明,AudioComposer在音频的时间戳、音高和能量的控制方面,都展现了优越的性能。
3. Disentangling Speakers in Multi-Talker Speech Recognition with Speaker-Aware CTC
论文作者:亢嘉文, 孟令威, 崔明宇, 王月娇, 吴锡欣, 刘循英, 蒙美玲
论文单位:香港中文大学
作者邮箱:jwkang@se.cuhk.edu.hk
论文链接:https://arxiv.org/abs/2409.12388论文亮点:
本文首次探索了连接时序分类(CTC)在多说话人语音识别中的作用,并提出了一种新颖的基于贝叶斯风险的Speaker-Aware CTC(SACTC)训练目标。与标准CTC相比,SACTC能显著提升系统在不同程度语音重叠场景下的识别性能,特别是在低重叠的多说话人语音中。
论文简介:
多说话人语音(MTASR)识别旨在转录包含多个说话人的重叠语音,面临着在转录时实现说话人解缠的独特挑战。目前主流方法包括分支式声学编码器和序列化输出训练(SOT)两种范式。虽然 CTC在MTASR中时常被使用,但其在MTASR中的作用机制尚未得到充分研究。本文通过可视化分析发现,CTC能够引导声学编码器(Acoustic Encoder)将不同说话人表征在声学嵌入的不同时域区域中,这种能力可能源于CTC的非自回归重排序特性(Non-autoregressive Reordering)。
基于这一发现,作者提出了Speaker-Aware CTC(SACTC)训练目标,它基于贝叶斯风险CTC框架构建,通过引入说话人感知风险函数,明确约束编码器在特定时间帧编码不同说话人的tokens。作者在主流的LibriSpeechMix数据集上进行了实验。实验表明,当SACTC与SOT结合使用时,SOT-SACTC模型在各种程度的语音重叠场景下始终优于标准SOT-CTC方法,整体实现了10%的相对词错误率降低,在低重叠语音上降低了15%。此外,作者探究了不同风险因子对模型表现的影响,并且在包含三个说话人的测试集上验证了该方法有很好的泛化性。
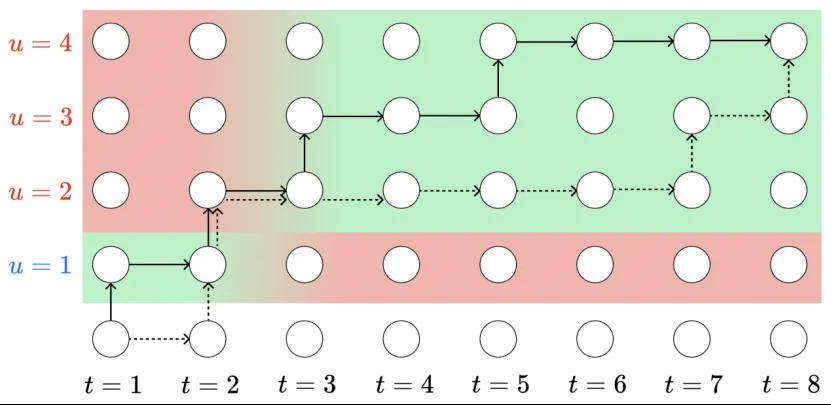
图1 提出的SACTC引导模型在特定时间帧编码特定的说话人。绿色区域代表鼓励的对齐路径,红色和蓝色代表两个不同说话人。
本研究为多说话人语言识别域探索了一个基于CTC的新方向,通过显式建模说话人解缠来提升重叠语音的识别性能,为处理自然对话中的多说话人语音提供了新思路。未来研究方向包括将SACTC扩展到流式场景和探索其在非自回归语音识别中的潜力。
4. Radiation and Directivity Analysis of a Vibrating Dome-Shaped Radiator Mounted on an Infinite Baffle
论文作者:Junqing Zhang, Wen Zhang, Jingdong Chen, and Jacob Benesty
论文单位:
CIAIC and Shaanxi Provincial Key Laboratory of Artificial Intelligence, Northwestern Polytechnical University, Xian, Shaanxi, China
INRS-EMT, University of Quebec, Montreal, Canada
作者邮箱:e-mail: junqingzhang@nwpu.edu.cn; wen.zhang@nwpu.edu.cn; jingdongchen@ieee.org
论文链接:https://ieeexplore.ieee.org/abstract/document/10889511论文亮点:
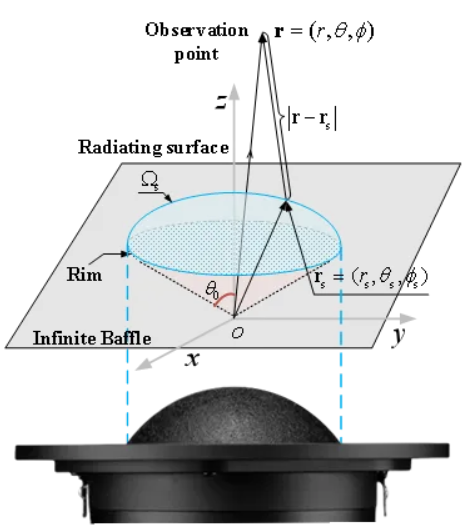
图1 无限大障板上的凸圆顶辐射器坐标图。
辐射器的精确建模和分析对研究其声辐射特性至关重要,因为其是评估实际扬声器等辐射声源性能的基础。如图1所示,本文围绕无限大障板上的凸圆顶辐射器的辐射特性开展研究。概括本文的主要贡献如下:1) 推导出障板上凸圆顶辐射器远场声压的数学表达式,其可表示为相应速度分布的三维傅里叶变换;2) 推导出凸圆顶辐射器几个关键性能指标的理论表达式,从而可以评估和比较不同的速度分布;3) 对传统速度分布的指向性因子(DF)中的零陷问题进行了深入分析,并解释了零陷出现的原因;4) 提出了一种改进的频率相关速度分布,以及相应的均衡滤波器,以减轻零陷效应并提高圆顶辐射器的辐射效率。通过仿真证明了所提出的方法相较于传统速度模型能够实现更平滑和更高的DF性能。
论文简介:
本文研究了凸圆顶辐射器的辐射特性,旨在为实际具有凸圆顶型振膜的高音扬声器单元理论模型确立提供技术支持。在远场近似下,该辐射器辐射产生的声压场是轴对称表面速度分布的三维傅里叶变换。然而,当前的理论速度分布模型在DF中会出现零陷问题,这无疑回复音质与听觉感知产生影响。,因此,本文围绕这一问题,提供了一个详细的分析来揭示产生该问题的原因。并提出了一种频率参数相关想均衡滤波器,旨在平滑整个频率范围内的DF。通过仿真验证了该方法的有效性,并展示了所提出方法的改进性能。
具体实现过程是通过设计一个与频率相关的均衡器,该均衡器的设计与凸圆顶模型结构下是声辐射特性相关。算法设计流程在图2中给出。可见,该方法在信号处理端,相当于一个预滤波器,对产生零陷相关的复指数项进行处理。
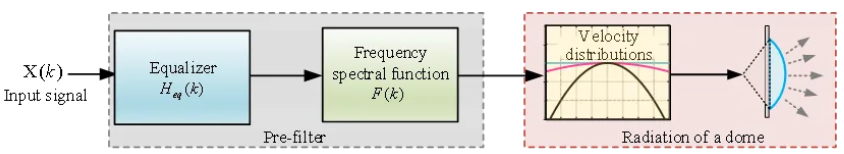
图2:凸圆顶辐射模型均衡器设计方法框图。
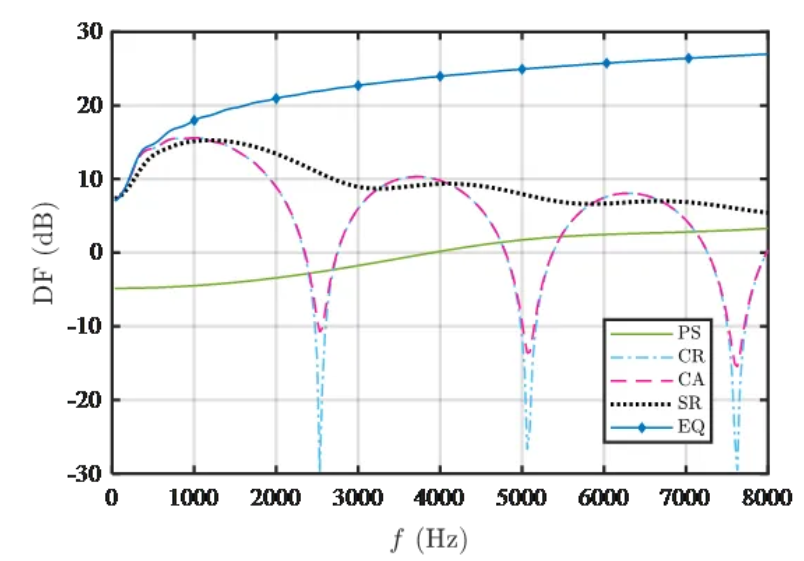
图3:各类辐射器表面速度模型下的指向性因子结果。
由图3的仿真结果可见,传统的点声源模型(point source, PS)、恒定径向 (Constant radial, CR) 、恒定轴向(Constant axial, CA),以及平滑径向(Smooth radial, SR) 速度分布均在其DF中都显示出两个零点。值得注意的是,所提出的速度均衡滤波器 (EQ) 的DF性能在整个频率范围内表现出最高和最平滑的结果,尤其在较高频率下有特别显著的改善。
5. DetailTTS: Learning Residual Detail Information for Zero-shot Text-to-speech
论文作者:王聪,韩易辰,耿翊中,高迎明,王风平,白炳松,李启飞,薛锦隆,邓雅月,温正棋,李雅
论文单位:北京邮电大学,清华大学
作者邮箱:congwang@bupt.edu.cn
论文链接:https://ieeexplore.ieee.org/abstract/document/10890840Demo:https://detailtts.github.io/
论文亮点:
该论文提出了一种基于条件变分自编码器的零样本语音合成模型DetailTTS,通过创新的先验细节模块和时长细节模块,首次在不依赖额外输入(如自监督表示或F0特征)的情况下,有效捕捉文本与语音对齐过程中遗漏的残差细节信息,显著缩小了信息鸿沟。论文通过将原始的线性谱作为增强监督信号和引入可学习的时长嵌入,在简化复杂度的情况下极大地增强语音合成的性能,同时利用对抗训练与归一化流提升鲁棒性,在零样本场景下实现了高自然度和高说话人相似度的优越性能。
论文简介:
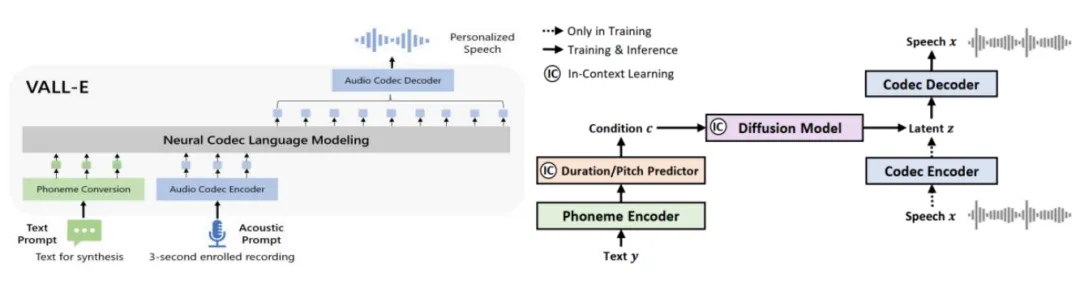
零样本语音合成模型可以使用仅需几秒的提示音频来提高语音合成的灵活性。VALL-E和VoiceCraft等自回归方法通过按顺序预测下一个输出来合成语音,无需对时长进行显式建模。但是,这会降低合成速度并导致稳定性问题,例如单词缺失和重复。NaturalSpeech和HierSpeech等非自回归方法可以并行地生成整个语音序列,但是,自然度依赖于对持续时长的建模能力,并且只使用单个向量无法有效地捕捉说话人的复杂特征。此外,在零样本的情况下,现有模型很难直接将文本和语音对齐,因此会出现发音错误和过度平滑的问题。为了缩小文本和语音之间的信息差距,过往的研究会使用Wav2Vec 2.0之类的自监督表示信息,或额外的F0表示,但计算成本增加。更重要的是,模型对齐残留的细节信息没有得到有效地利用。
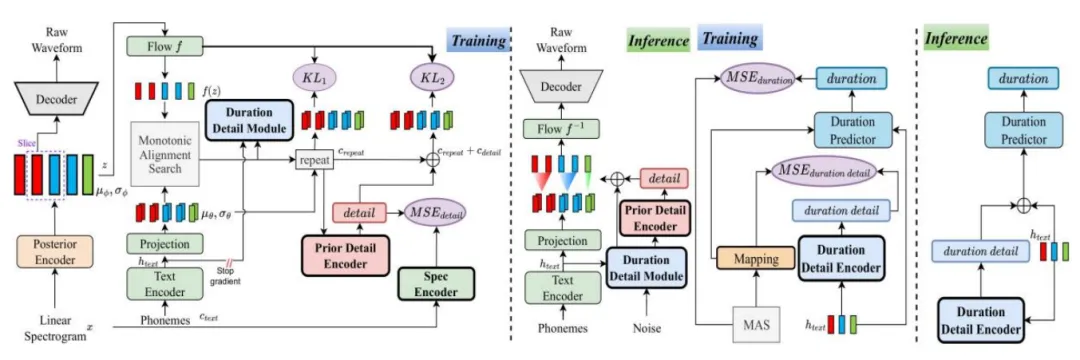
因此,为了缩小文本和语音之间的信息差距,该论文提出了 DetailTTS,这是一种能够学习残留细节信息的零样本语音合成模型。论文在增强的条件变分自编码器的基础上,对残留的细节信息进行额外编码并作为增强条件信息。具体来说,论文通过设计了先验细节编码模块和持续时间细节编码模块,可以利用原始的线性谱信息作为监督信号,帮助模型捕获文本和语音对齐过程中缺失的残留细节信息。通过将残差信息作为增强条件信息输入,模型实现了比以前更好的零样本合成性能。
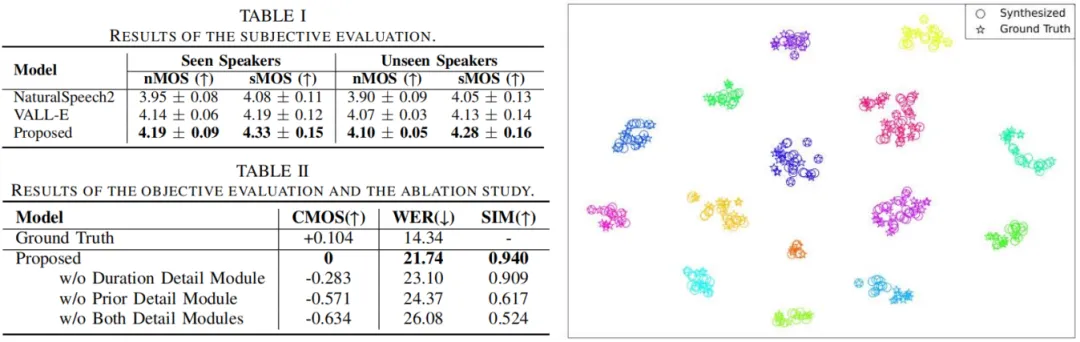
论文基于12,800小时的中文普通话数据集WenetSpeech4TTS进行了主客观实验。对比自回归模型VALL-E和非自回归模型NaturalSpeech2,DetailTTS在主观评价的自然度与目标说话人相似度上均表现出优越的性能提升。同时,在包含15个未见说话人的1,000条样本测试集上的客观实验结果也表明,模型通过残差细节编码显著提升了发音准确性和音色相似度,尤其在零样本场景下表现突出。
该论文未来研究计划扩展至跨语言及情感可控的零样本语音合成,并进一步优化残差编码方法以增强细节建模能力。当前工作虽在中文场景中验证了有效性,但未覆盖多语言与情感表达的复杂性,未来需探索更通用的残差信息表征方式,以进一步提升模型的性能和泛化性。
论文导读投稿指南
本次活动聚焦于即将在ICASSP 2025上发布的论文,征集时间为2025年4月至5月。我们诚挚邀请ICASSP 2025会议录用论文的作者参与论文导读活动,一同分享学术成果。投稿模版参见附件。稿件请以电子邮件形式提交至 tcsdap_ccf@163.com,联系人:张雯、李雅、吴锡欣。
整理编辑:张雯,李雅,吴锡欣
指导:凌震华
