
 语音小管家
随着深度学习在语音处理领域的不断突破,多说话人语音分离与识别(Multi-talker Speech Separation & Recognition)已成为推动“鸡尾酒会问题”解决的研究热点。然而,现有方法尽管在性能上取得了一定进展,却仍难以匹敌人类在嘈杂环境中聚焦和识别目标说话人的能力,特别是在面对性别相同或信噪比较低的场景时。
近期,上海交通大学听觉认知与计算声学实验室在 Nature 出版集团旗下期刊 npj Acoustics 发表题为”Contextual understanding with contextual embeddings for multi-talker speech separation and recognition in a cocktail party”的论文,提出一种融合上下文理解的多说话人语音分离与识别新型框架,通过从混合语音中直接学习对应不同说话人的上下文嵌入(Contextual Embedding),显著提升了多说话人语音的分离与识别效果。该方法启发自人类利用上下文信息进行“选择性听觉”的认知机制,结合预训练的单说话人教师模型进行知识蒸馏,并在WSJ0-2mix和WSJ0-2mix-L等基准数据集上实现了相较现有方法的显著性能提升,展现出在复杂语音环境中实现高效语音理解的潜力。
论文题目:Contextual understanding with contextual embeddings for multi-talker speech separation and recognition in a cocktail party
作者列表:钱彦旻,李晨达,张王优,林少雄
背景动机
在多说话人语音处理领域,如何在“鸡尾酒会”式的复杂环境中准确分离和识别出每一位说话人的语音内容,长期以来一直是语音处理技术面临的重大挑战。这一问题源自现实生活中的常见场景:多个说话人同时发声,语音相互重叠,且往往伴随背景噪声、混响等干扰。传统自动语音识别(ASR)系统在处理这类混合语音时效果显著下降。尽管近年来深度学习方法在语音分离与识别方面取得了显著进展,仍难以达到人类“选择性听觉”的水平——即在嘈杂环境中能自动聚焦并理解感兴趣的说话人的语音。研究发现,人类在识别复杂环境下的语音时,会利用上下文信息对缺失的语音片段进行补全和理解,这种基于上下文的语义推理能力在现有模型中尚未得到充分利用。
为此,本文提出一种模仿人类听觉机制的新型建模方式——通过引入上下文嵌入(contextual embeddings)来提升系统对混合语音的理解能力。该方法不仅能在语音分离中辅助模型更有效地区分重叠说话人,还能在语音识别阶段提供关键的上下文语义信息,从而显著提升多说话人语音处理的整体性能。
方法综述
1. 上下文嵌入学习
为了能够直接从混合语音得到对应于不同说话人的上下文嵌入,我们设计了图1中所示的知识蒸馏框架。该框架中,教师模型是一个预训练好的端到端的单说话人语音识别系统的编码器(Encoder),学生模型由3类模块组成:
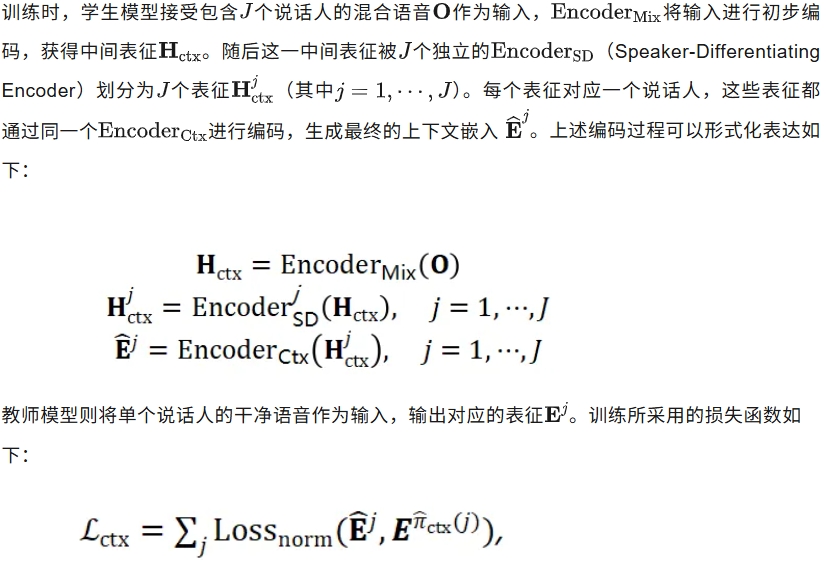
其中 表示范数损失函数,可选用-范数或-范数。括号中的索引对表示预测嵌入与标签嵌入之间的最佳排列,用于最小化整体损失,该过程通过排列不变性训练(Permutation Invariant Training,PIT)实现。
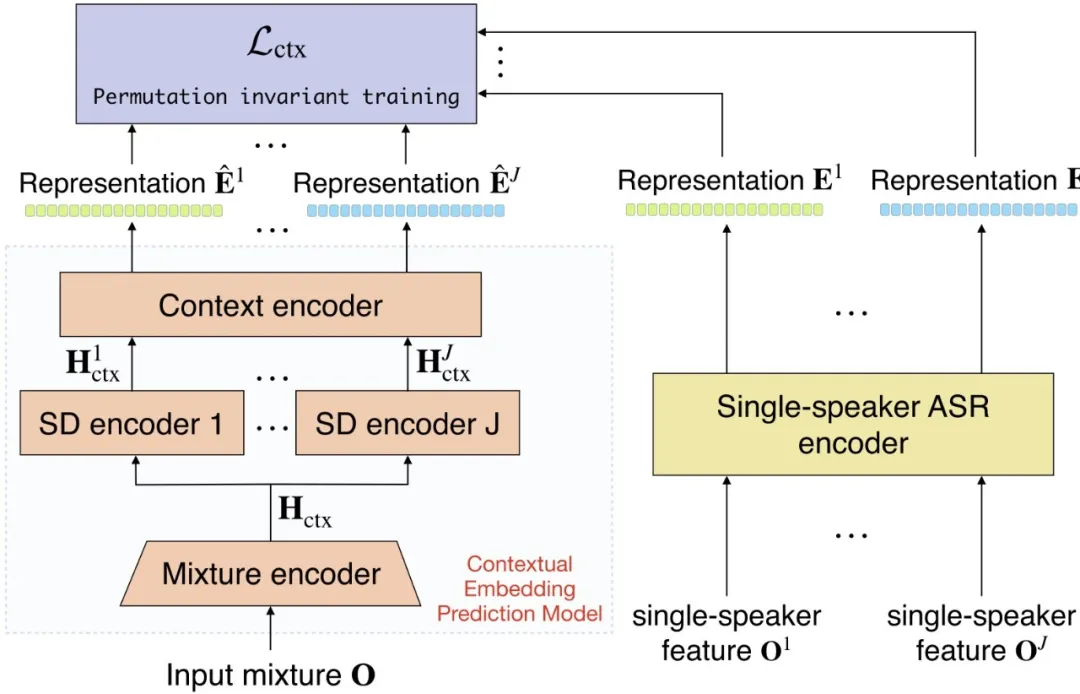
图1 通过知识蒸馏方式学习上下文嵌入
2. 利用上下文嵌入辅助语音分离
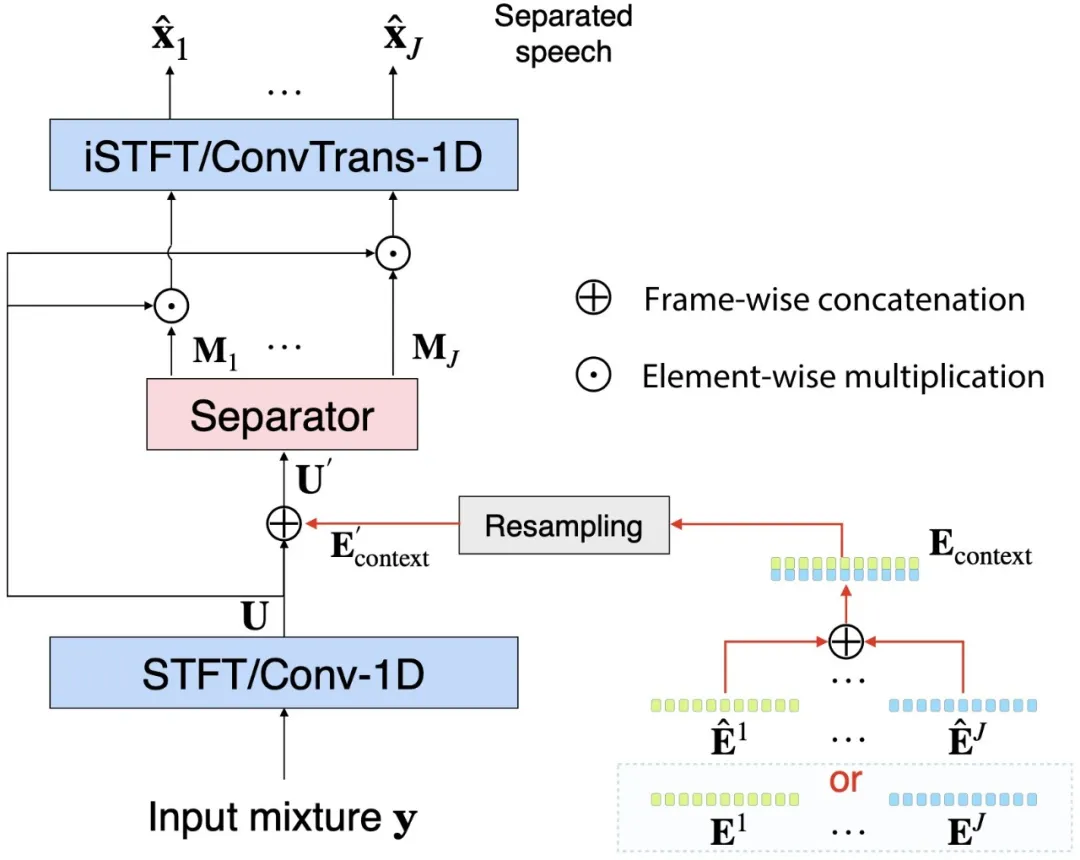
图2 所提出的利用上下文嵌入辅助语音分离的框架示意图
3. 利用上下文嵌入辅助多说话人语音识别
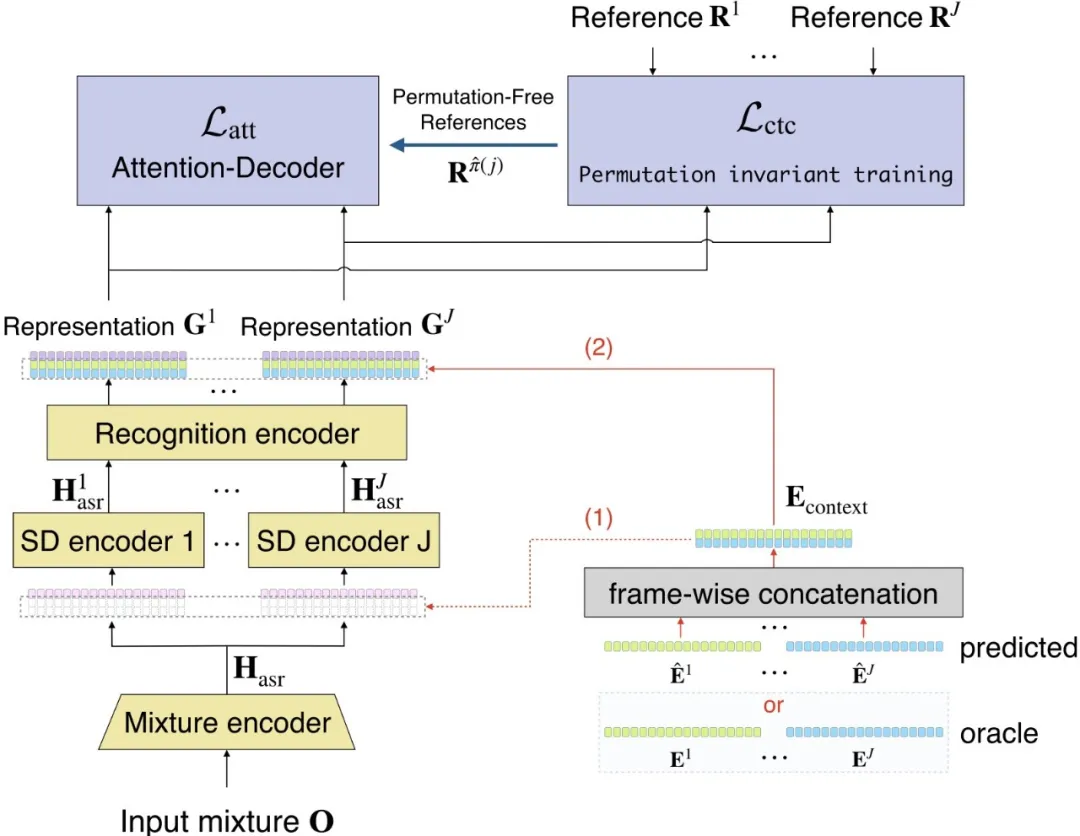
图3 所提出的利用上下文嵌入辅助多人语音识别的框架示意图
4. 上下文嵌入采样策略
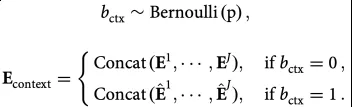
上面介绍的多说话人语音分离与识别的框架在训练阶段可以采用预测的上下文嵌入或教师模型的参考上下文嵌入,但实际应用中只能使用预测的上下文嵌入,因而可能存在失配问题。为此,我们设计了一种新训练策略,通过在训练阶段随机使用两种来源的嵌入,来缓解可能的失配问题。具体而言,我们通过伯努利分布随机抽样来确定上下文嵌入的来源。在我们的实验中,使用真实上下文嵌入的概率为p=0.7,而使用预测上下文嵌入的概率则为1-p:
5. 两阶段训练策略
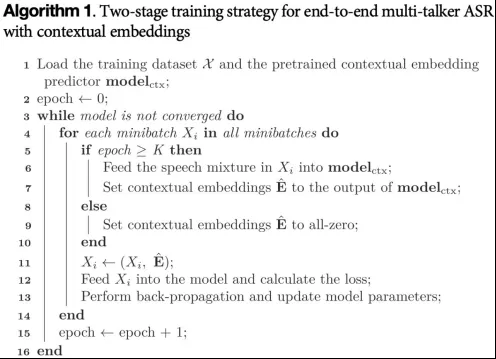
针对多说话人语音识别任务,我们发现模型的优化过程相对困难,可能存在收敛问题。因此,我们进一步提出一种两阶段训练策略,以优化带有上下文嵌入的多说话人语音识别系统的训练过程。这种策略可以降低优化过程中对上下文信息过度依赖或强调的风险。由于上下文嵌入本身即能提供丰富的语义信息,若在训练初期就直接融合这些特征,可能导致多说话人编码器本身训练不足,从而产生次优的训练效果。为缓解该问题,我们尝试将训练过程分成两个阶段。如算法1所示,在第一阶段,我们在不使用任何上下文嵌入的情况下将多说话人语音识别模型训练个轮次,使得模型在融合上下文嵌入之前能够得到充分的训练。在第二阶段,我们再按照图3所示的方法整合上下文嵌入,并继续训练模型直至收敛。
实验
1. 实验配置
针对语音分离任务,我们采用WSJ0-2mix数据集作为模型的训练和评估数据集,其中训练集、开发集和测试集的音频时长分别为30小时、10小时和5小时。针对多说话人语音识别任务,我们采用更大规模的WSJ0-2mix-L数据集,同样由WSJ0语料库合成,但使用了更多的语料源,整体数据规模更大。WSJ0-2mix-L数据集中训练集、开发集和测试集的音频总时长分别为88.2小时、1.1小时和0.9小时。在数据仿真过程中,每个样本均包含两名说话人,他们的信干比(Signal-to-Interference Ratio, SIR)随机设定在−5至5 dB之间。此外,我们还使用了原始80小时的WSJ数据集来训练单说话人语音识别系统,作为上下文嵌入学习阶段的教师模型。
针对语音分离任务的性能评估,我们采用信号失真比(Signal-to-Distortion Ratio, SDR)、短时目标可懂度(STOI)以及语音质量感知评估(PESQ)三个指标。其中,SDR是信号层面的客观评价指标,用于量化语音信号增强和失真的程度;而STOI和PESQ则属于感知层面的客观评价指标,分别用以衡量语音的可懂度和感知质量。对于多说话人语音识别任务的评估,我们采用了词错误率(Word Error Rate, WER)作为评价指标。
2. 实验结果
1) 所提出的上下文嵌入在语音分离任务中的评估
我们在 WSJ0-2mix 数据集上对所提出的上下文嵌入方法进行了语音分离实验。实验中,将前文“上下文嵌入学习”部分介绍的“参考上下文嵌入”(oracle)和“预测上下文嵌入”(predicted)分别引入到多种语音分离模型中,包括基于时频掩蔽的 ResNet 和 BLSTM 架构,以及时域的 TasNet 架构。
图4显示了 ResNet 模型在不同上下文条件下的训练曲线。结果表明,加入真实上下文信息后,模型收敛更快且效果更好。
表1展示了三类模型在测试集上的性能对比。实验结果表明,加入参考上下文信息在所有评估指标上都大幅提升了性能。虽然在实际应用中无法获得参考上下文信息,但用我们提出的预测器生成的上下文嵌入替代后,模型性能依然比原始基线有显著提升。从表1各个模型的最后一行结果可以看出,在训练阶段同时使用参考与预测上下文嵌入(O+P)并结合随机采样方法时,所有语音分离模型的性能都有小幅但稳定的提升,这体现了前面介绍的“上下文嵌入采样策略”的有效性。
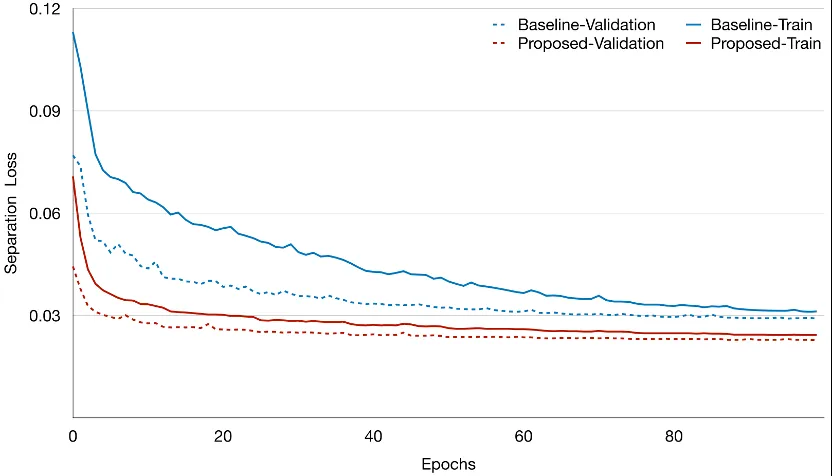
图4 基于 ResNet 的时频掩蔽架构中,基线方法与引入真实上下文理解后的方法的分离损失曲线
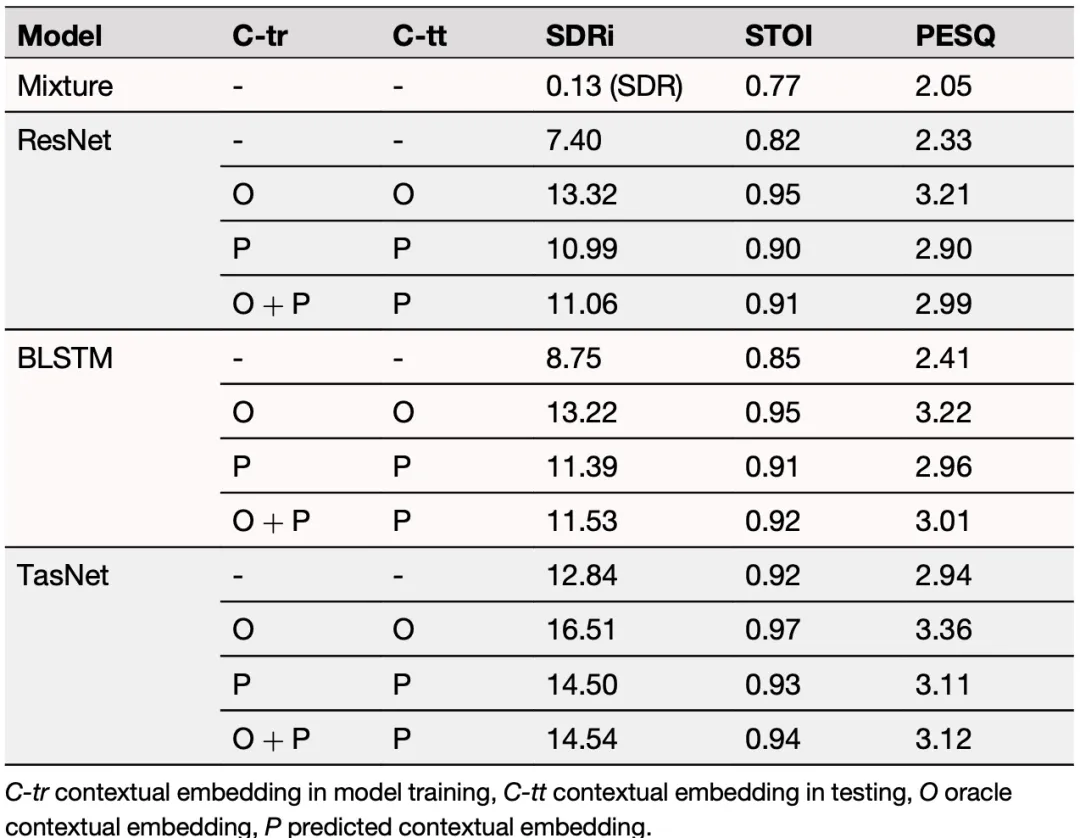
表1 在 WSJ0-2mix 测试集上,基于上下文理解的语音分离性能对比(评估指标包括 SDRi、STOI 和 PESQ)
除此之外,我们分别计算了在不同性别组合和不同信噪比(Signal-to-Noise Ratio, SNR)条件下的信号失真比,结果如表2所示。本实验采用的是基于 BLSTM 的时频掩蔽分离模型。由于两位说话人的信干比分布在 -5 dB 到 5 dB 之间,我们将 |SNR| 超过 2.5 dB 视为高信噪比情形。每种条件下都分别展示了高能量说话人(High E)和低能量说话人(Low E)的 SDR结果。从表2可以看出,引入预测上下文嵌入的模型在所有条件下都取得了 SDR提升,尤其是在低能量、同性别(男-男、女-女)混合的困难场景中,模型性能提升更为显著。
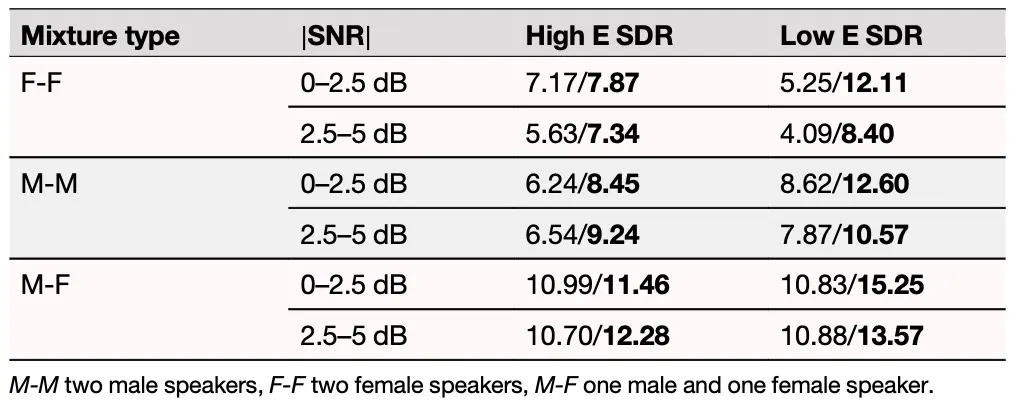
表2 在 WSJ0-2mix 测试集上,不同性别组合与信噪比条件下,使用/不使用上下文嵌入的模型在平均 SDR(dB)上的性能对比
2) 所提出的上下文嵌入在多说话人语音识别任务中的评估
我们将图5所示的多说话人语音识别系统作为基线,与图3中我们所提出的利用上下文嵌入的识别系统进行对比,结果如表3所示。结果表明,当在训练和测试阶段均使用来自单说话人语音识别编码器的参考嵌入时,我们提出的上下文理解方法能显著提升基线系统的性能,在开发集和测试集上分别实现了超过 15% 和 27% 的相对提升。当使用预测上下文嵌入时,尽管相较于参考嵌入出现了一定程度的性能下降,但相较于基线方法,模型在开发集和测试集上仍分别取得了超过 12% 和 17% 的相对词错误率(WER)提升,展现出显著的性能优势。
除了上面介绍的实验,在文中我们还探究了与的输出或者与的输出进行拼接对系统最终性能产生的影响、两阶段训练策略对性能的影响,以及对上下文嵌入和所提出系统的解码结果进了了可视化,限于篇幅不在此处逐一介绍,感兴趣的读者可以自行阅读原文。
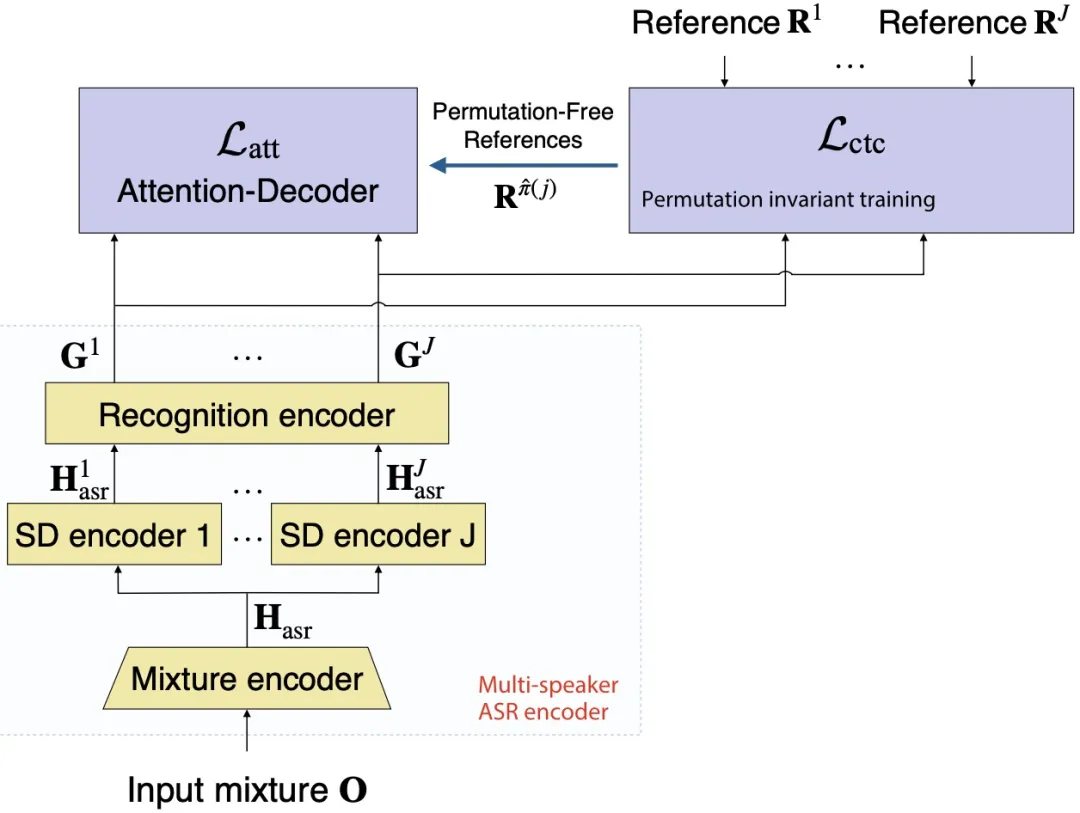
图5 多人语音识别基线系统的框架示意图
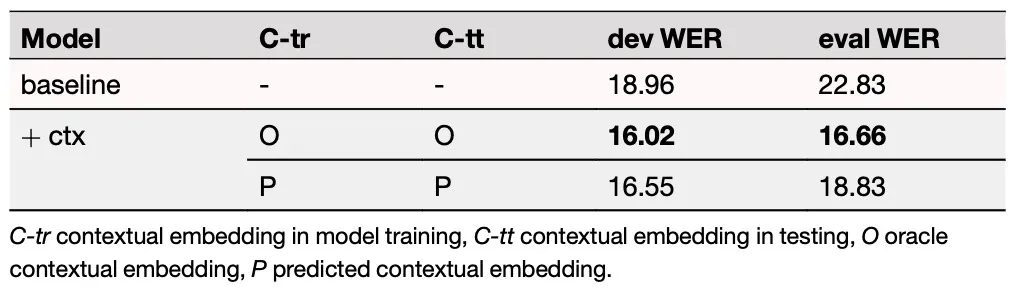
表3 所提出的基于上下文理解的多说话人语音识别在 WSJ0-2mix-L 数据集上的平均词错误率(WER)性能(%)
总结
本文针对“鸡尾酒会问题”中的多说话人语音分离与识别问题,提出了一种基于上下文嵌入的全新方法。受人类听觉系统能够借助语境信息进行说话人分离与追踪的启发,我们设计了一个新颖的“上下文嵌入学习框架”,通过预训练的单说话人教师模型进行知识蒸馏,从混合语音中直接预测对应每个说话人的上下文嵌入。这些上下文嵌入可以灵活引入语音分离与识别模型中,并结合嵌入采样与两阶段训练等优化策略显著提升模型性能。在WSJ0-2mix等基准数据集上的实验表明,所提出的方法相较于传统方法在语音分离(SDR、STOI、PESQ)和语音识别(WER)指标上均有明显提升,尤其在同性别、低信噪比等困难条件下表现更优。可视化分析进一步表明,该方法能够有效提取并分离不同说话人的语境信息,从而改善模型在复杂语音场景中的信号处理与识别能力。
参考文献
[1] E. C. Cherry, “Some experiments on the recognition of speech, with one and with two ears,” The Journal of the Acoustical Society of America, vol. 25, no. 5, pp. 975–979, 1953.
[2] M. A. Bee, and C. Micheyl, “The cocktail party problem: what is it? How can it be solved? And why should animal behaviorists study it?,” Journal of comparative psychology, vol. 122, no. 3, pp. 235, 2008.
[3] Y. Qian, C. Weng, X. Chang, S. Wang, and D. Yu, “Past review, current progress, and challenges ahead on the cocktail party problem,” Frontiers of Information Technology & Electronic Engineering, vol. 19, no. 1, pp. 40–63, 2018.
[4] N. Mesgarani, and E. F. Chang, “Selective cortical representation of attended speaker in multi-talker speech perception,” Nature, vol. 485, no. 7397, pp. 233–236, 2012.
[5] J. R. Hershey, Z. Chen, J. Le Roux, and S. Watanabe, “Deep clustering: Discriminative embeddings for segmentation and separation,” in Proc. IEEE ICASSP, 2016, pp. 31–35.
