
 语音小管家
为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期分享七篇发表在ICASSP2025上的文章。本导读论文栏目持续征稿中,欢迎踊跃投稿,投稿方式请参见文末指南。
★ 第2期分享论文列表
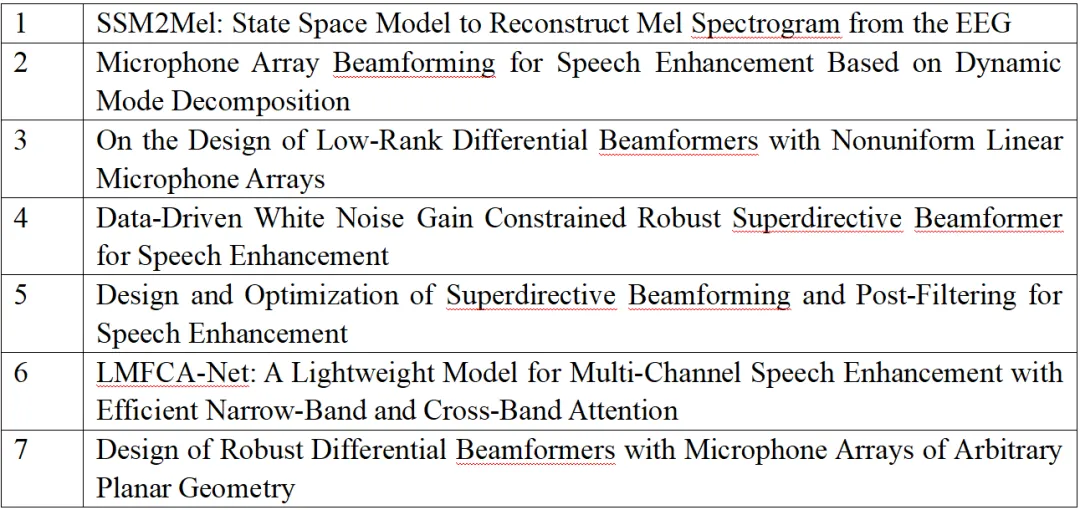
1. SSM2Mel: State Space Model to Reconstruct Mel Spectrogram from the EEG
【论文作者】Cunhang Fan, Sheng Zhang, Jingjing Zhang, Zexu Pan, Zhao Lv
【论文单位】1School of Computer Science and Technology, Anhui University, Hefei, China, 2 Alibaba group, Singapore
【作者邮箱】cunhang.fan@ahu.edu.cn,e23301156@stu.ahu.edu.cn,e22201067@stu.ahu.edu.cn,xu325504@hotmail.com,kjlz@ahu.edu.cn
【论文亮点】
这项工作的贡献有三个方面:我们创新性地使用Mamba模型来有效地对长序列的EEG信号进行建模,探索与之相关的最佳实践。并创新性地将基于S4的U-Net网络结构应用于EEG信号处理,以捕获局部特征和这些特征的短期依赖性。最后在ICASSP 2024听觉EEG挑战数据集上的实验表明,我们的模型的性能显着优于当前最先进的模型。
【论文简介】
从脑信号中解码语音是一个具有挑战性但意义重大的研究课题,它对于理解大脑如何处理语音至关重要。尽管在使用非侵入性脑电图(EEG)重建被试感知的音频刺激的梅尔频谱图(mel spectrogram)方面已经取得了一些突破,但这些研究大多集中在单词或字母级别的语音解码。在连续语音特征的精确重建方面,尤其是在分钟级别的时间尺度上,仍然存在显著的差距。为了解决这一问题,本文提出了一种基于状态空间模型(State Space Model, SSM)的模型——SSM2Mel,用于从EEG信号中重建连续语音的梅尔频谱图。为了解决长时间长序列建模的问题,我们利用了选择性状态空间模型(Mamba)模块,该模块擅长高效处理长序列数据,并将其与多头自注意(MHSA)相结合。此外,为了捕获局部特征和短期依赖性,使模型能够更准确地定位和重建与语音产生相关的大脑活动模式,我们首次提出了一种基于结构化状态空间序列(S4)层的U-Net结构,用于处理EEG信号。为了捕获不同样本之间的相关性并增强模型对个体差异的敏感性,我们还引入了外部注意力机制和ESM模块。最后,与基线模型相比,本模型的性能提升了38%,Pearson相关系数达到0.069。
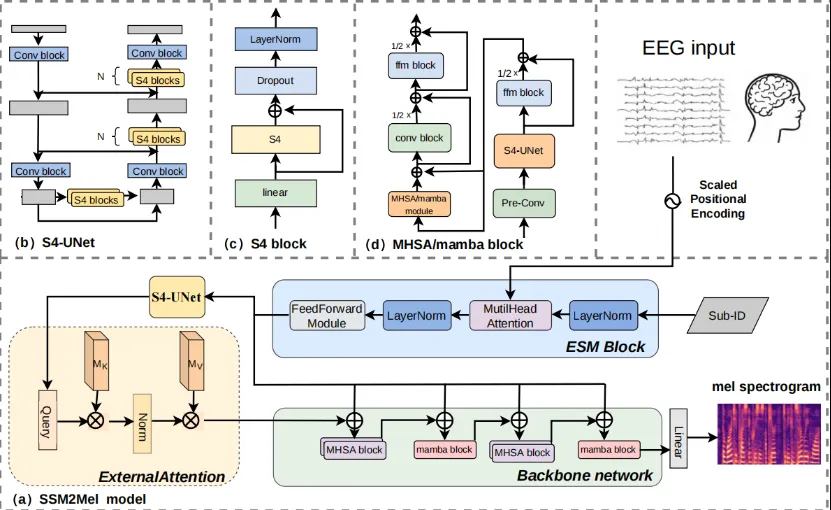
图1 所提出的SSM2Mel网络
2. Microphone Array Beamforming for Speech Enhancement Based on Dynamic Mode Decomposition
【论文作者】刘威, 黄公平,刘鑫, 靳姬鲁, 陈景东, Jacob Benesty
【论文单位】1武汉大学,2OPPO,3西北工业大学,4加拿大魁北克国立科学研究院
【作者邮箱】wei_liu@whu.edu.cn
【论文亮点】
本论文将动态模式分解技术引入麦克风阵列语音增强领域,探究了阵列信号在空间上的动态机制。本文贡献有两部分:一是提出了一种基于DMD的麦克风阵列信号模型,以捕获相邻麦克风的观测信号之间的关系;二是提出了一种基于DMD的预处理方法和相应的波束形成方法。实验结果表明,与传统的波束形成技术相比,该方法显著提高了语音增强性能。
【论文简介】
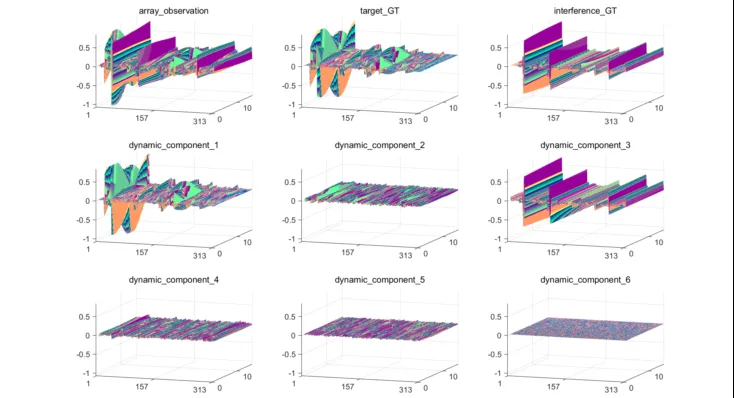
图2 阵列观测信号和基本动态成分的可视化
动态模式分解(DMD)原是流体力学中的数据分析工具,用于从高维数据中提取动态模式(如图2所示)。本论文首次将DMD引入麦克风阵列语音增强,提出了一种多输入多输出(MIMO)的空间滤波方法框架,核心思路如下:
1.建模阵列动态:将多麦克风观测序列视为动态系统,通过DMD分解为基本动态模式,如图3所示;
2.模式选择与重构:基于目标方向筛选期望语音信号模式,分离噪声和干扰模式,重构阵列信号并保留空间信息,如图3所示;
3.(可选)结合波束形成:结合RSD或MVDR波束形成,进一步提升语音质量。
提出方法的优势如下:
1.空间信息保留:区别于传统的多输入单输出的波束形成方法,提出的DMD-PSD 算法在增强目标信号的同时,可以保留目标信号在原多通道上的空间信息;
2.通用性强:提出的DMD-PSF方法的多通道输出保留了对波束形成等方法至关重要的相位信息,并且该方法可以用来估计噪声的空间协方差矩阵,因此DMD-PSF方法可作为一种预处理模块适配多种语音增强算法;
3.空间滤波性能显著:提出的DMD-PSF方法在所有的指标(fwSNRseg、SDR和STOI)下显著均显著优于传统方法。提出的DMD-PSF的信噪比增益比传统波束形成方法高4-9 dB。并且在将DMD-PSF算法与传统波束形成方法相结合时,信噪比增益可以进一步提升3-5 dB。
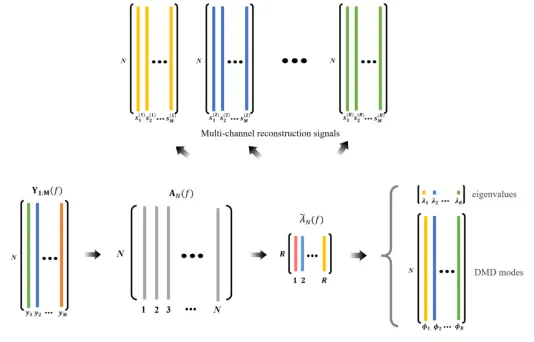
图3 频域阵列信号的DMD分解
【论文链接】https://ieeexplore.ieee.org/abstract/document/10888043
3. On the Design of Low-Rank Differential Beamformers with Nonuniform Linear Microphone Arrays
【论文作者】裴汉晨,陈康,黄公平,靳姬鲁,Jacob Benesty,陈景东
【论文单位】1武汉大学,2西北工业大学,3加拿大魁北克国立科学研究院
【作者邮箱】phc_whu@whu.edu.cn
【论文亮点】
现有的Kronecker积波束形成方法在非均匀线性阵列上的应用通常受到结构限制,难以扩展至任意数量和排列方式的传感器配置,导致其在实际应用中的灵活性和性能受限。为了解决这一问题,本文提出了一种适用于任意非均匀线性阵列的低秩差分波束形成方法。该方法将阵列划分为多个可重叠子阵列,并通过矩阵化建模与Kronecker积滤波器设计,实现了对任意阵列结构的灵活支持。相比传统方法,该方案在提升方向性和鲁棒性的同时,显著增强了波束形成设计的适用性与效率。
【论文简介】
Kronecker积波束形成因其设计灵活和计算高效,在麦克风阵列信号处理领域受到广泛关注。然而,现有方法主要适用于结构规则的阵列,尤其是均匀线性阵列,对非均匀线性阵列则依赖特定的阵列结构,限制了其在实际中的应用。为解决这一限制,本文提出了一种非均匀线性阵列的低秩Kronecker积差分波束形成方法。该方法将非均匀线性阵列划分为多个可重叠子阵列,并构建观测信号矩阵,在其两侧施加滤波器,从而转化为低秩Kronecker积滤波器优化问题。这一方法突破了结构限制,可适用于任意阵列配置,极大提升了波束器设计的灵活性和稳健性。
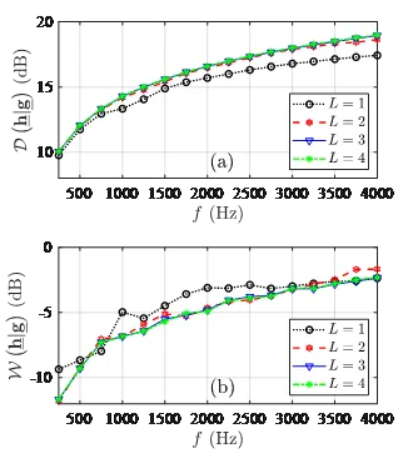
图4 低秩差分波束形成器的方向因子(b)和白噪声增益(b)随频率变化的关系图。
在模拟实验中,图4展示了所提方法在不同低秩配置下方向性因子(DF)和白噪声增益(WNG)随频率变化的趋势,结果表明该方法在降低秩数的同时仍能保持良好性能。这一方法适用于任意麦克风数量的非均匀线性阵列,并涵盖现有Kronecker波束器作为特例。未来研究可进一步探索该框架在实时语音增强和智能硬件中的应用潜力。
4. Data-Driven White Noise Gain Constrained Robust Superdirective Beamformer for Speech Enhancement
【论文作者】裴汉晨,黄公平,靳姬鲁,马建波,武执政,陈景东,Jacob Benesty
【论文单位】1武汉大学,2西北工业大学,3Dolby,4香港中文大学(深圳)5加拿大魁北克国立科学研究院
【作者邮箱】phc_whu@whu.edu.cn
【论文亮点】
(1)本文提出一种数据驱动的白噪声增益(WNG)阈值自适应估计方法,提高稳健超指向性波束形成器(RSD)在实际应用中的环境适应能力,显著优于传统依赖经验设定的WNG约束方法。
(2)在无失真约束下,将残留噪声能量最小化作为网络优化目标,在有效抑制各类噪声的同时,始终保留目标语音的直达声成分,实现对目标声源的高保真增强。
【论文简介】
超指向波束形成器在抑制方向性和扩散噪声方面表现出色,但在实际应用中,其性能严重依赖于传感器精度和阵列一致性,极易受到白噪声放大的影响。现有的稳健超指向性波束形成方法多依赖于预设的WNG阈值,但这在实际系统中,将不同场景的音频和音频的不同频率统一约束为相同的WNG阈值,显然难以达到最优性能,这也限制了RSD的普适性和性能上限。
本文针对上述挑战,提出一种数据驱动的WNG阈值估计方法,在综合考虑阵列误差、噪声场景及频率变化特性的基础上,自适应优化波束形成策略,具体框图如下所示:
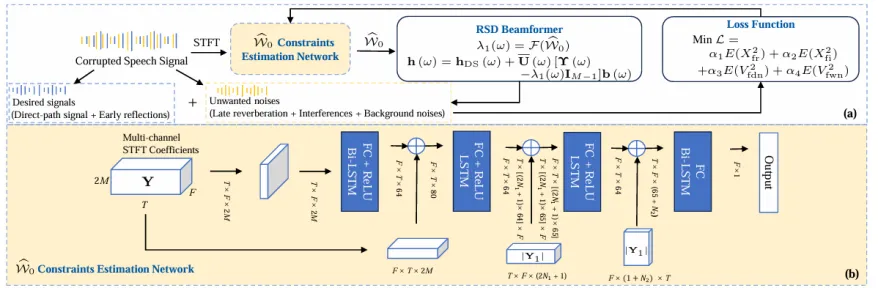
首先将优化问题转为二次特征值问题(QEP)进行求解,在无失真约束下,通过引入残留噪声最小化目标函数,设计出更加稳健的RSD。实验结果表明,所提方法显著优于传统采用固定WNG阈值的RSD;同时在抑制方向性干扰上,不同频率呈现出较为一致的零点分布趋势,验证了为不同频率分别预测WNG阈值的合理性与有效性;在考虑阵列误差情况下,该方法体现出良好的泛化能力。
【论文链接】https://ieeexplore.ieee.org/abstract/document/10889723
5. Design and Optimization of Superdirective Beamforming and Post-Filtering for Speech Enhancement
【论文作者】杨晓冉, 黄公平, 靳姬鲁, 陈景东, Jacob Benesty
【论文单位】1武汉大学,2西北工业大学,3University of Quebec
【作者邮箱】yxr888@whu.edu.cn;
【论文亮点】
针对稳健超指向波束形成器(roboust superdirective beamformer, RSD)在声源方向偏离波束指向时引入的失真问题,本文提出了一种稳健超指向波束形成与后置滤波联合优化的新方法。通过将超指向性波束形成器的输出作为后置滤波网络的训练数据,能够有效抑制残余噪声并恢复波束形成阶段引入的语音失真。与传统方法相比,该方法在不同入射角度偏差和阵列失配情况下均表现出显著的性能提升,为复杂环境下的语音增强提供了一种有效解决方案。
【论文简介】
超指向波束形成(superdirective beamformer, SD)因其高指向性与频不变波束特性,在小规模麦克风阵列中应用广泛。然而,这类波束形成器对阵列自噪声等极为敏感。为提升稳健性,稳健超指向波束形成(robust superdirective beamformer, RSD)应运而生,但引入了波束变宽和频不变特性丢失的问题。在实际场景中,当声源入射方向偏离波束指向时,RSD波束形成器会引入显著的语音失真。而传统的后置滤波方法虽然能够在一定程度上抑制残余噪声,但往往无法解决波束形成阶段引入的失真问题,导致语音质量下降。因此,如何在复杂环境下实现稳健的语音增强,同时减少失真,成为当前研究的一个重要方向。
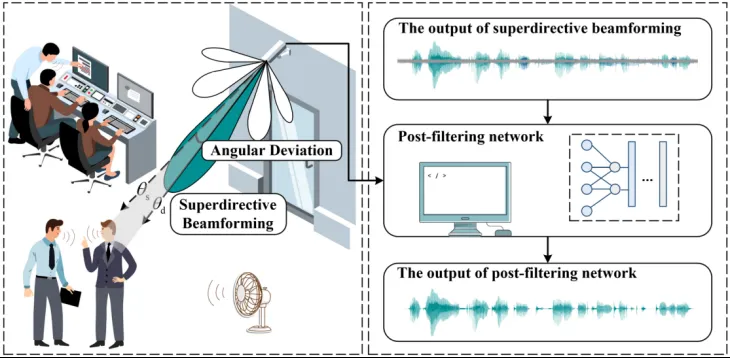
图5 超指向波束形成与后置滤波网络的联合优化框架
针对上述问题,本文提出了一种稳健超指向性波束形成与后置滤波联合优化的新方法。如图5所示,该方法的核心思想是将RSD波束形成器的输出信号作为后置滤波网络的训练数据,以数据驱动的方式使得后置滤波网络学习并补偿RSD波束形成器引入的特定失真。与传统方法相比,该方法不仅能够有效抑制残余噪声,还能恢复波束形成阶段引入的语音失真,显著提升语音增强效果。实验结果表明,该方法在不同入射角度偏差和阵列失配情况下均表现出优异的性能,为复杂环境下的语音增强提供了一种稳健的解决方案。
6. LMFCA-Net: A Lightweight Model for Multi-Channel Speech Enhancement with Efficient Narrow-Band and Cross-Band Attention
【论文作者】张耀恺,裴汉晨,王琬琪,黄公平
【论文单位】武汉大学
【作者邮箱】morriszhang@whu,edu.cn
【论文亮点】
文章针对现有深度学习多通道语音增强方法计算量大的问题,提出了一种轻量级网络 LMFCA-Net。网络引入了时间轴解耦全连接注意力(T-FCA)和频率轴解耦全连接注意力(F-FCA)机制,用于有效捕获长距离的窄带和跨带信息,且无需使用循环单元。实验结果表明,LMFCA-Net 在显著降低计算复杂度和延迟的同时保持了较好的增强性能。
【论文简介】
随着配备麦克风阵列的设备日益普及,多通道语音增强因其能够利用空间信息而备受关注。现有的端到端深度学习多通道语音增强方法,通过结合子带、跨带和空间信息,取得了令人瞩目的性能 。这些方法通常包含显式捕获窄带和跨带信息的模块,例如使用 LSTM 单元或自注意力机制来建模时间和频率维度的依赖关系,以充分利用空间线索 。然而,这些先进的方法往往计算量巨大,高效地建模对利用空间线索至关重要的窄带和跨带信息仍是一个挑战。
为了应对这些挑战,论文提出了轻量级多通道语音增强网络LMFCA-Net。LMFCA-Net采用了新颖的时间轴解耦全连接注意力(T-FCA)和频率轴解耦全连接注意力(F-FCA)机制 。这些机制能够在不使用循环单元的情况下,有效捕捉语音信号中的长距离窄带和跨带依赖关系,从而更好地利用麦克风阵列提供的空间信息。实验证明,该模型在计算复杂度和延迟方面远低于现有先进模型,同时保持了具有竞争力的语音增强性能,为在实际应用中部署高效的多通道语音增强技术提供了一个有前景的解决方案。
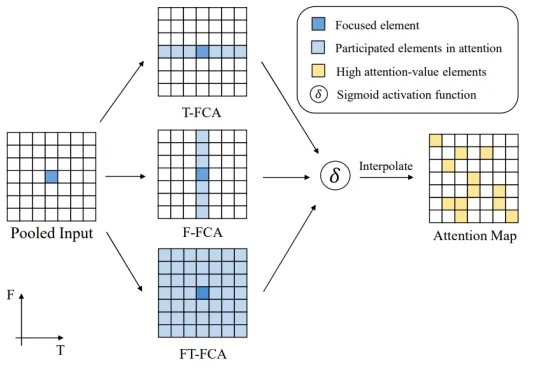
图6 FCA 机制图示:T-FCA和F-FCA用于建模长距离的窄带和跨带依赖关系,而FT-FCA 则用于整合局部特征。
7. Design of Robust Differential Beamformers with Microphone Arrays of Arbitrary Planar Geometry
【论文作者】赵坤龙, 罗雪琴, 靳姬鲁, 黄公平, 陈景东, Jacob Benesty
【论文单位】1武汉大学,2西北工业大学,3加拿大魁北克国立科学研究院
【作者邮箱】kunlongzhao@whu.edu.cn
【论文亮点】
差分麦克风阵列由于具有高指向性和频率不变的波束模式,在近年来的研究和发展中受到了广泛的关注。然而,差分麦克风阵列对阵列适配和自噪声异常敏感,容易产生严重的白噪声放大现象,这限制了它的实际应用。本文提出一种适用于任意平面拓扑结构的差分麦克风阵列的稳健波束形成的一般方法来解决这一问题。该方法利用Jacobi-Anger级数展开近似波束方向图,并将白噪声增益约束在理想等级。这最大限度地减少了波束方向图和理想指向性方向图之间的误差,同时确保了合理的稳健性。
【论文简介】
差分麦克风阵列结合波束形成技术可以获得高指向性和宽带频不变的波束模式,因此受到研究者的广泛关注。然而现有差分波束形成方法多受限于特定阵列结构(如线性阵列、环形阵列和球形阵列等),难以适应实际应用中广泛存在的不规则平面阵列(如智能手机、平板电脑等)的应用场景。此外,差分波束形成器的稳健性差,尤其是在低频段易受白噪声放大的影响,导致可懂度严重下降。因此,如何在扩展算法对任意阵列结构的适应性的同时,有效提升波束形成器的稳健性,是亟待解决的关键问题。
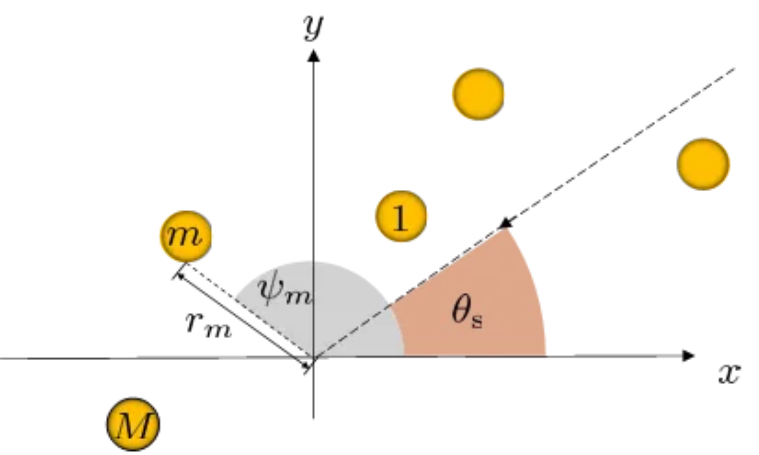
图7 平面麦克风阵列示意图
本文提出一种适用于任意平面拓扑结构的差分麦克风阵列的稳健波束形成的一般方法来解决上述问题。根据图1所示的任意平面几何结构的麦克风阵列,建立信号模型,目标最小化理想波束图与实际波束图之间的均方误差,同时引入期望方向无失真和稳健性约束,构造二次约束二次规划问题(QCQP)。通过数学变换,将带约束的优化问题转化为二次特征值问题(QEP),并推导出闭式解,从而实现任意平面阵列结构下的稳健波束形成。该方法突破了现有方法对阵列几何结构的限制,显著提升了算法的适用性和稳健性。与现有的稳健差分波束形成器相比,本章方法显著简化了设计过程。最后,实验结果证明了所提方法设计的波束形成器具有转向灵活性、宽带范围内的波束图频不变性以及缓解白噪声放大的有效性。
【论文链接】https://ieeexplore.ieee.org/abstract/document/10888941
