
 语音小管家
为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期分享七篇发表在ICASSP2025上的文章。本导读论文栏目持续征稿中,欢迎踊跃投稿,投稿方式请参见文末指南。
★ 第3期分享论文列表
1. Geometry-Constrained EEG Channel Selection for Brain-Assisted Speech Enhancement
【论文作者】左可盈,徐擎天,张结,凌震华
【论文单位】中国科学技术大学
【作者邮箱】keyingzuo@mail.ustc.edu.cn;qingtianxu@mail.ustc.edu.cn;
jzhang6@ustc.edu.cn; zhling@ustc.edu.cn
【论文亮点】
本文提出了一种基于几何约束的脑电(EEG)通道选择方法GC-ConvRS,解决了面向听力器具的脑辅助语音增强(BASE)中脑电极的实际部署问题。引入了新的WD-TCN网络,替代已有BASEN模型中的Conv-TasNet架构,提升了语音增强性能。实验表明,在保留少量关键通道的情况下,模型仍能保持较高的语音增强质量,为脑电极与可穿戴设备集成提供了重要思路。
【论文简介】
本文围绕脑辅助语音增强(Brain-Assisted Speech Enhancement, BASE)问题展开研究。BASE任务旨在通过脑电(EEG)信号作为辅助信息,从多说话人混合语音中提取目标说话人语音。BASE的核心理念是利用人类听觉系统对目标声音的选择性注意能力,这种“听觉注意”可通过EEG信号解码,从而提升语音增强的性能。当前主流方法通常盲目使用全部脑电通道,虽然能够提升性能,但在实际设备部署中存在硬件成本高、电极分布不合理等问题。本文为此提出了一种基于几何约束的EEG通道选择方法(GC-ConvRS)。该方法在保留性能的同时显著减少所需EEG通道数量,使得电极排布符合耳机形状的几何结构,更便于与听力辅助设备集成。如下图所示,本文使用WD-TCN(Weighted Multi-dilation Temporal Convolutional Network)结构作为BASE模型的主干网络,通过引入多尺度膨胀卷积和注意力机制,更好地捕捉语音与EEG之间的时序关系。同时,GC-ConvRS方法包含两步选择机制:首先,通过定义符合耳机形状的区域进行硬选择,限制候选通道集合;然后在该集合基础上使用ConvRS方法进行软优化,以进一步筛选最具代表性的通道。实验部分使用公开数据集进行评估,结果显示提出的WD-TCN在全通道下相较于BASEN在SI-SDR、PESQ、STOI等指标上均有提升。在使用GC-ConvRS方法筛选出的部分通道(如18或15个)时,系统仍然维持较好的性能表现,且所选通道多集中于颞叶区域,符合听觉认知神经机制。
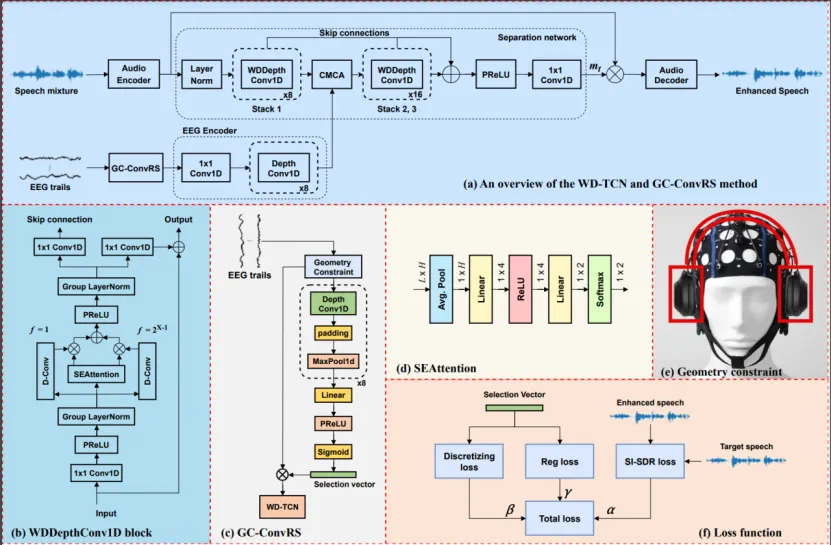
图1.1 几何拓扑约束的脑辅助语音增强模型图
2. LiSenNet: Lightweight Sub-band and Dual-Path Modeling for Real-Time Speech Enhancement
【论文作者】严浩尹,张结,范存航,周叶萍,刘沛奇
【论文单位】中国科学技术大学,安徽大学,中国招商银行
【作者邮箱】hyyan@mail.ustc.edu.cn;jzhang6@ustc.edu.cn
【论文亮点】
这项工作的贡献有两个方面:一是提出了一种新的轻量级语音增强模型,采用基于频带感知的特征压缩方式、建模时间和频率依赖关系的双路径递归模块以及Griffin-Lim相位重构算法,以极低的资源消耗取得了有竞争力的语音增强效果;二是提出了噪声检测模块,通过动态检测语音中的噪声片段,进一步降低了计算资源的消耗。
【论文简介】
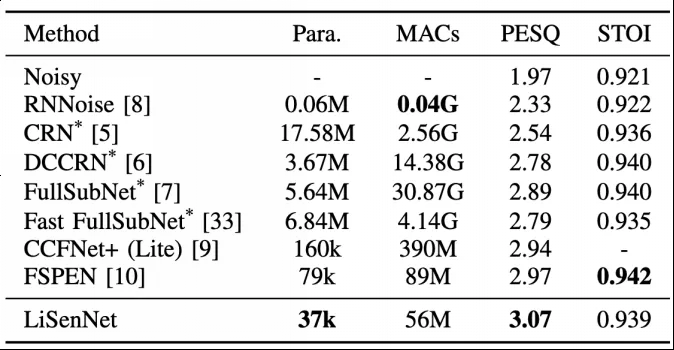
现有的基于神经网络的语音增强模型尽管在性能上显著优于传统算法,但庞大的计算复杂度和模型参数量很大程度上限制了在延迟敏感和低资源边缘设备上的部署。针对这一限制,本论文提出了一种名为LiSenNet的轻量级语音增强网络,为低资源设备上的实时语音增强提供高效的解决方案。该模型采用基于频带感知的特征压缩方式,即子带下采样和上采样模块。其优先保留低频分辨率以确保人耳感知的关键特征,同时压缩高频特征以降低计算负担。此外,双路径递归模块(DPR)被用于建模时间和频率之间的依赖关系,显著提升了语音信号建模能力。为了优化相位重构效果,LiSenNet结合了Griffin-Lim算法,根据增强后的幅度谱来细化带噪语音相位以提高感知音质。模型还创新性地引入了噪声检测器模块,该模块能够动态检测语音中的噪声片段,仅对含噪部分进行增强处理,从而进一步降低了计算资源的消耗。实验结果表明,LiSenNet在多个数据集上均表现优异,以极低的资源消耗取得了有竞争力的语音增强效果。在引入噪声检测器后,LiSenNet在低噪声比例场景下的计算复杂度可进一步降低,为实时语音增强的低资源设备部署提供了新的可能性。
表 2.1 LiSenNet在VoiceBand+DEMAND数据集上的对比结果
3. Leveraging Boolean Directivity Embedding for Binaural Target Speaker Extraction
【论文作者】汪意迟,张结,蒋承乾,张为泰,叶忠义
【论文单位】中国科学技术大学,科大讯飞研究院
【作者邮箱】wangyichi@mail.ustc.edu.cn;jzhang6@ustc.edu.cn;jiangchengqian@mail.ustc.edu.cn;wtzhang3@iflytek.com;zyye7@iflytek.com;lrdai@ustc.edu.cn
【论文亮点】
本文提出布尔方向编码特征,在无需已知阵列配置的条件下实现目标说话人精准定位;配套设计高效编码器,解决DOA与音频粒度不匹配问题;融合多通道时空特征提升系统鲁棒性;引入逐帧动态调整机制,使系统适应说话人位置切换与移动。方法在静态与动态场景中均展现出优越性能。
【论文简介】
本文针对双耳场景中基于到达方向(Direction of Arrival, DOA)的目标说话人提取(Target Speaker Extraction, TSE)问题展开研究,重点解决双耳麦克风阵列数量有限且间距未知条件下的方向线索利用问题,以及DOA特征与混合音频信号之间的粒度不匹配问题。为此,我们提出了一种新的双耳目标说话人提取方法,其核心在于设计了一种称为布尔方向编码(Boolean Directivity Embedding,BDE)的时频域特征,该特征能够在无需特定麦克风阵列配置的情况下精确锁定目标说话人。同时,我们开发了一种简单高效的编码器,用于实现BDE与混合音频信号的精准对齐与融合。考虑到布尔表示在时空信息上的局限性,该方法进一步将BDE与多通道时空特征相结合,以增强系统的兼容性和目标说话人提取能力。此外,通过引入逐帧动态调整机制,使系统能够灵活适应目标说话人的切换和移动场景。实验结果表明,该方法在静态和动态环境下均能取得良好的性能表现。
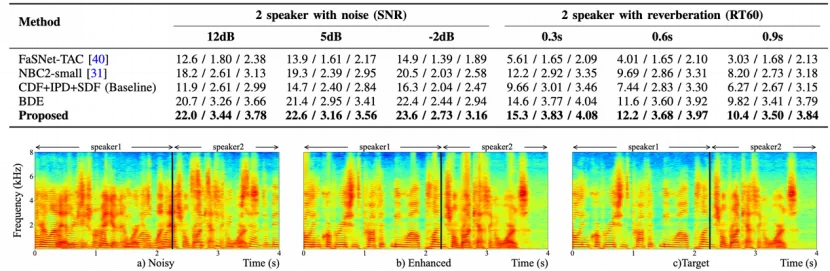
图 3.1 对比实验结果及目标说话人切换条件下提取效果
【论文链接】https://ieeexplore.ieee.org/abstract/document/10888158
4. Learning-Based Utility Estimation with Application to Speech Enhancement of a Moving Speaker
【论文作者】张结,蒋承乾,汪意迟,严浩尹,孙淼
【论文单位】中国科学技术大学,广州航海学院
【作者邮箱】jzhang6@ustc.edu.cn;cqjiang@mail.ustc.edu.cn; wangyichi@mail.ustc.edu.cn; hyyan@mail.ustc.edu.cn;m.sun.1@hotmail.com
【论文亮点】
本研究提出了一种面向动态语音场景、基于深度学习的麦克风效用估计方法,突破了传统仅适用于静态语音源的模型局限。文中用预训练的wav2vec 2.0模型自动提取鲁棒的语音特征,并结合离散傅里叶变换构建出更全面的时频表示。通过构建编码器-解码器架构的神经网络模型,系统能够准确地在多麦克风环境中预测各麦克风随时间变化的贡献度(效用),并应用于麦克风子集选择,从而显著提升了移动说话人语音增强任务中的整体性能。在多个语音质量评价指标(如PESQ、STOI、SDR)上,该方法均优于已有方法,展示出强大的实用价值与研究前景。
【论文简介】
随着无线声学传感器网络(Wireless Acoustic Sensor Networks, WASNs)的广泛应用,在嘈杂或大范围场景中对多麦克风信号进行高效处理已成为语音增强领域的重要课题。传统的麦克风效用估计(Microphone Utility Estimation, MUE)方法主要针对静态语音源而设计,难以应对说话人位置不断变化的实际应用需求。为解决这一问题,本文提出了一种基于深度学习的动态麦克风效用估计方法,能够对移动说话人场景下的麦克风贡献度进行精准建模。
该方法综合利用了预训练的wav2vec 2.0模型和离散傅里叶变换(DFT),前者可通过自监督学习提取丰富的时间域语音特征,后者则提供频域能量信息,两者结合构建出更加全面的时频特征表示。在建模结构上,作者设计了一种端到端的编码器-解码器神经网络模型,采用均方误差(MSE)作为损失函数,实现了麦克风效用随时间变化的连续估计。实验设置中,研究者在模拟房间环境中放置了80个麦克风,使用LibriSpeech语料库中的24000组训练样本进行训练,并在4800组验证样本和4000组测试样本上进行评估。
结果表明,该方法在平均皮尔逊相关系数(PCC)指标上相较现有模型如model_kf和model_sim表现更佳,能够更准确地追踪麦克风效用的动态变化。在语音增强任务中,本方法所选取的子集麦克风不仅提升了感知语音质量(PESQ),也在客观可懂度(STOI)、语音失真比(SDR)等多个评价维度上优于现有技术。该研究不仅丰富了多麦克风语音处理的理论体系,也为面向复杂真实环境的智能语音系统提供了高效可靠的解决方案。
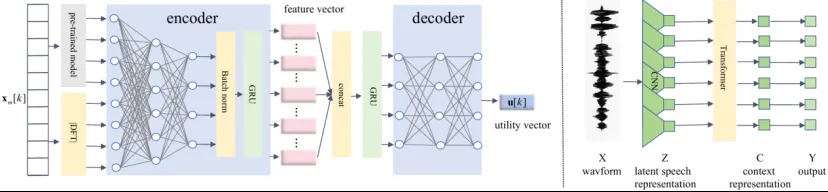
图4.1 端到端分布式麦克风效用估计模型图
【论文链接】https://ieeexplore.ieee.org/abstract/document/10889220
5. A Lightweight and Real-Time Binaural Speech Enhancement Model with Spatial Cues Preservation
【论文作者】王景渊,陈世豪,张结,孙淼
【论文单位】中国科学技术大学,广州航海学院
【作者邮箱】jywg@mail.ustc.edu.cn
【论文亮点】
本文提出了一种新的固定方向的双耳语音增强方法,用于联合双耳语音增强和空间信息保留,称为LBCCN,这是一种轻量级、低复杂度和实时模型。通过选择性地操作与噪声中的语音理解更相关的低频带,并应用轻量级卷积块来替换正常卷积,降低了模型的复杂性。由于包含了目标RATF的显式估计,双耳线索可以更好地保留。结果表明,所提出的LBCCN可以在大多数信噪比水平下实现最佳性能,但在复杂性方面具有更大的优势。
【论文简介】
双耳语音增强旨在在嘈杂环境下同时提升语音信号的质量和可懂度,并保留目标声源的空间线索,从而带来更自然的听觉体验。这项技术主要应用于助听设备或其他双耳聆听系统中。然而,目前已有的方法在实际应用中常常面临两个难以兼顾的问题:一方面是噪声抑制的能力不足,另一方面则是在强噪声环境下难以准确保留空间线索,同时还伴随着较高的计算复杂度,尤其在复杂的声学场景中表现不佳。
针对这一挑战,本文提出了一种基于学习的轻量级双耳复数卷积神经网络(Learning-Based Lightweight Binaural Complex Convolutional Network,简称 LBCCN)。该方法在处理噪声时表现优异,具体做法是在频域中重点滤除低频噪声部分,同时保留其余频带信息,从而兼顾语音信号的清晰度与自然性。此外,为了进一步提升空间感知能力,我们的方法显式地引入了声道间相对声学传递函数的估计过程,以保持双耳间的空间差异信息。这种设计有助于在降噪的同时,更真实地还原声源方向和听觉空间感。
实验结果表明,所提出的 LBCCN 在固定说话人方向场景下,能够以显著更低的计算开销,达到与当前先进方法相当的噪声抑制效果,同时在一定程度上保留了空间线索的还原能力。该方法在确保效率的前提下,实现了语音增强、空间保真与计算资源三者之间的良好平衡,具有较强的实际应用潜力。
【论文链接】https://ieeexplore.ieee.org/abstract/document/10888392
6. Aligning Noisy-Clean Speech Pairs at Feature and Embedding Levels for Learning Noise-Invariant Speaker Representations
【论文作者】李作亮,艾杨,张结,彭圣宇,管煜,古斌,郭武
【论文单位】中国科学技术大学
【作者邮箱】lzl2001@mail.ustc.edu.cn
【论文亮点】
本文提出一种通过在特征和嵌入级别同时对齐噪声-干净语音对来学习具有噪声不变性说话人表征的方法,创新地融合语音增强模块与多损失函数以端到端训练网络,解决了过往方法只在单一级别处理噪声时存在的对齐不足问题,使模型在不同噪声条件下均能聚焦说话人身份特征,显著提升了复杂噪声环境下的说话人识别性能,为噪声鲁棒性说话人表征学习提供了新思路。
【论文简介】
自动说话人确认(ASV)在噪声环境下的性能退化是一项挑战,现有方法主要依赖语音增强预处理,或专注于在嵌入空间对齐,但单一级别的处理难以有效去除噪声冗余。为此,本文提出一种双级别对齐框架,构建噪声-干净的语音对,通过在特征级与嵌入级协同优化以学习噪声不变性的说话人表征。首先,利用基于 Conformer 的语音增强(SE)模块处理噪声特征,通过最小化增强特征与干净特征的均方误差实现特征级对齐。在嵌入级别上,引入带噪声自适应间隔(NAM)的监督对比学习损失(SCL),根据噪声强度动态调整样本之间的间隔约束,增强同一说话人嵌入的紧凑性和不同说话人嵌入的可分离性,同时结合Barlow Twins自监督损失减少嵌入维度间的噪声冗余,确保噪声-干净语音对的嵌入在保留身份信息的同时抑制噪声变化。最终,将特征级损失、嵌入级损失与传统分类损失联合优化,构建端到端网络。实验在 VoxCeleb1 数据集上进行,在不同噪声类型和信噪比合成的测试集上的结果表明,本文方法在域内及域外噪声条件下均表现优异,平均等错误率(EER)显著低于主流方法。消融实验显示,各组件对噪声鲁棒性说话人表征的学习均有贡献。研究表明,双级别对齐框架有效整合了语音增强与表征学习的优势,为噪声鲁棒的ASV提供了有效解决方案。
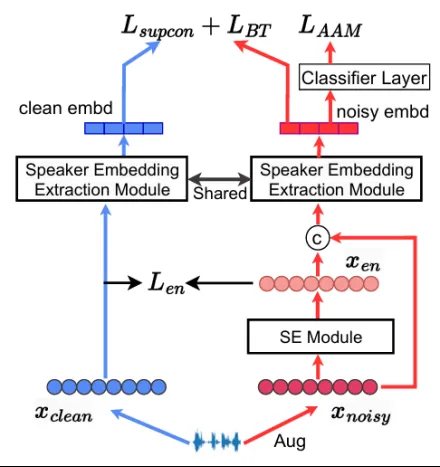
图6.1 噪声不变性说话人表征学习框架示意图
【论文链接】https://ieeexplore.ieee.org/abstract/document/10889792
7. A Study of Multi-Scale Feature Learning From Pre-Trained Models on Speaker Verification
【论文作者】彭圣宇,郭武,张结,李作亮,管煜,古斌,艾杨
【论文单位】中国科学技术大学
【作者邮箱】shengyupeng@mail.ustc.edu.cn; guowu@ustc.edu.cn;
jzhang6@ustc.edu.cn; lzl2001@mail.ustc.edu.cn; gypursue@mail.ustc.edu.cn;
bin2801@mail.ustc.edu.cn; yangai@ustc.edu.cn;
【论文亮点】
本文提出了一种多尺度特征融合范式,旨在充分发挥预训练模型在文本无关说话人验证任务上的潜力。模型框架由多尺度特征提取器和级联的增强型ECAPA-TDNN后端组成。特征提取器结合预训练模型CNN层的局部表征以及Transformer层的全局线索,从而构建多尺度的判别表征。特征提取器的输出送入到增强型ECAPA-TDNN后端以获取最终的说话人embedding。实验结果表明,该框架在VoxCeleb数据集上的性能优越,基于base和large的预训练模型在Vox1-O测试集上的EER分别达到了0.633%和0.457%。
【论文简介】
通常,语音的预训练模型(例如WavLM、HuBERT)包含两个主要组件:位于底层的 CNN 编码器和由一系列 Transformer 层组成的 Transformer 编码器。然而,现有的方法仅对 Transformer 层的表征进行简单的加权送入后端分类器。之前研究表明这种方式会更加侧重于某些特定层的表征,这就导致CNN 编码器层的细节表征被忽略,同时在大规模数据集上训练的 Transformer 层的分层表征也未能得到充分利用。
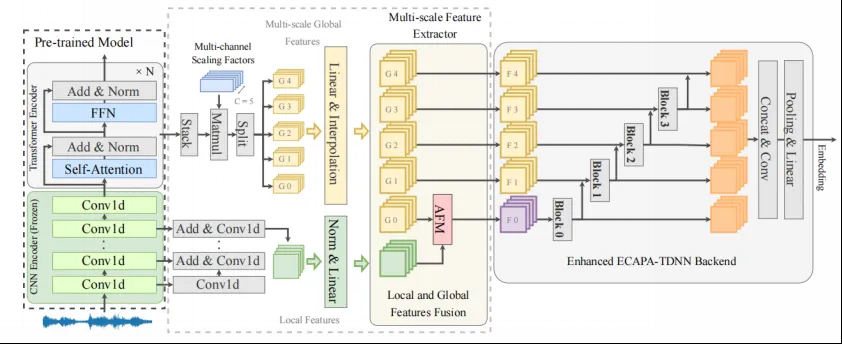
图7.1 基于预训练模型多尺度特征学习的说话人确认方法
在本论文中,我们提出了一种多尺度特征融合范式,以充分利用预训练模型分层表征以及层级之间的互补性。具体而言,我们设计了一个多尺度特征提取器和一个增强型 ECAPA-TDNN 后端来处理多尺度输入。本论文的贡献体现在三个方面:1)特征提取器有效地将预训练模型中的全部层表征转换为一组用于声纹识别的多尺度特征。我们首先利用多通道缩放和拆分操作将 Transformer 编码器的表征分为五个通道,每个通道捕捉不同尺度的全局说话人线索。同时,我们通过逐层求和的方式从 CNN 编码器层中提取一组局部特征。2)增强型 ECAPA TDNN 后端:我们对常用的ECAPA-TDNN 进行了优化,使其能够适应多尺度特征输入,能够分批次处理来自预训练模型的多尺度表征。通过精心优化每个块的输入并构建分层残差连接,此后端模块能利用局部和全局特征从而形成说话人Embedding。3) VoxCeleb 数据集上的结果表明,所提出的多尺度特征融合框架适用于多个常用的预训练模型,其性能优于最先进的 (SOTA) 的声纹识别模型模型。
【论文链接】https://ieeexplore.ieee.org/stamp/stamp.jsp?tp=&arnumber=10887949
