语音小管家
分享清华大学人机语音交互实验室(THUHCSI)中稿的8篇论文,内容涉及智能语音交互领域的诸多研究方向,包括语音大模型泛化能力、自回归语音合成加速、文本驱动的可控语音转换、歌声转换、构音障碍语音重建、音频水印及其对抗防御等。论文工作将学术科研与产业应用紧密结合,
01、Enhancing Generalization of Speech Large Language Models with Multi-Task Behavior Imitation and Speech-Text Interleaving
作者:Jingran Xie, Xiang Li, Hui Wang, Yue Yu, Yang Xiang, Xixin Wu, Zhiyong Wu
合作单位:香港中文大学
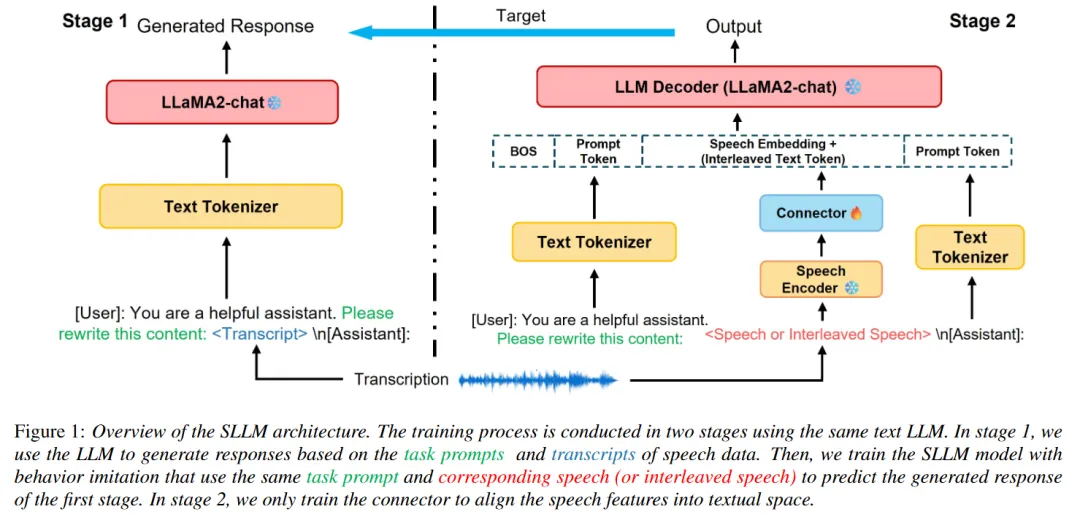
主要创新点:当前主流的语音大语言模型(Speech Large Language Models, SLLMs)普遍依赖大规模带标签的语音数据进行监督微调;然而语音标注成本高昂、任务覆盖范围有限,导致模型在面对未见过的指令(Instruction)和任务时泛化能力不足。为此,本文提出了一种结合多任务行为模仿(Multi-Task Behavior Imitation, MTBI)与语音文本交错输入(Speech-Text Interleaving)的训练方法,旨在通过提升语音与文本大语言模型(LLM)在语义层面的对齐程度,使得SLLM能够更充分地继承和发挥文本LLM的泛化能力。本文设计了一种训练策略,使模型仅需要依赖语音以及对应转录文本的配对数据(而无需其他数据),通过让SLLM模仿文本LLM在相同语义文本输入时的响应行为,实现语音模态向文本LLM语义空间的有效对齐。此外,本文还引入语音与文本的交错输入机制,在训练过程中引导模型更有效地学习跨模态融合与统一表示,从而进一步提升语音与文本内容之间的对齐效果。实验结果表明,本文所提方法在不依赖额外监督标注的前提下,显著提升了SLLM模型在提示泛化和任务泛化方面的表现。在多个评测任务中,所提方法均优于现有主流SLLM基线模型,并展现出接近文本LLM的能力,验证了所提方法在提升SLLM泛化能力方面的有效性。
02、Accelerating Autoregressive Speech Synthesis Inference With Speech Speculative Decoding
作者:Zijian Lin, Yang Zhang, Yougen Yuan, Yuming Yan, Jinjiang Liu, Zhiyong Wu, Pengfei Hu, Qun Yu
合作单位:腾讯科技有限公司
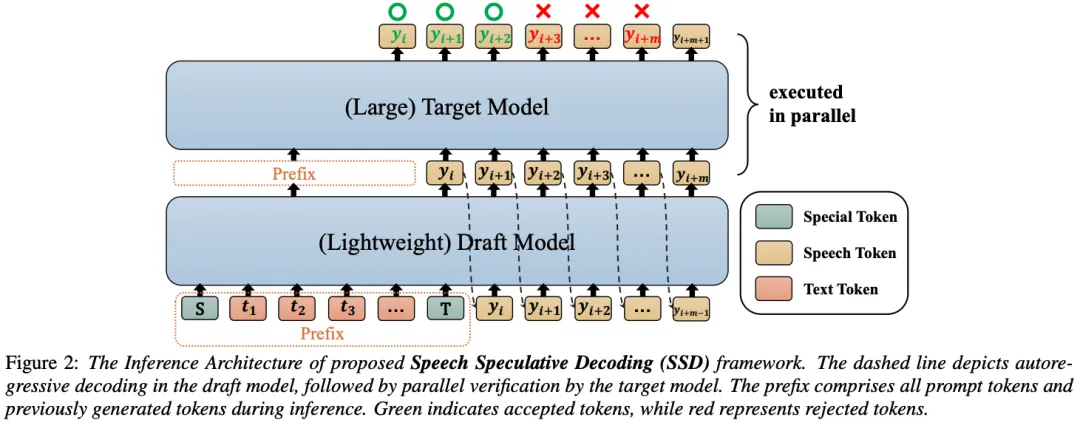
主要创新点:当前基于语言模型的自回归(AR)语音合成系统虽能生成高质量语音,但其固有的自回归预测机制会导致严重的推理延迟。针对这一关键问题,本文创新性地提出了语音投机解码(Speech Speculative Decoding, SSD)框架,通过引入轻量级草稿模型生成候选序列,进而采用目标模型的并行验证机制,在保持语音自然度的同时实现了推理加速。本文分析了语音Token和波形信号之间的特性,设计了语音容忍机制(Tolerance factor),有效解决了传统投机解码方法会错误拒绝合理声学变化的问题。实验结果表明,本文提出的SSD方法在CosyVoice 2模型上实现了1.4倍的合成推理加速,同时保持了高质量的语音合成效果。主观评测表明,SSD生成的语音在相似度和自然度方面均达到了与原始CosyVoice 2相当的水平。
03、In This Environment, As That Speaker: A Text-Driven Framework for Multi-Attribute Speech Conversion
作者:Jiawei Jin, Zhihan Yang, Yixuan Zhou, Zhiyong Wu
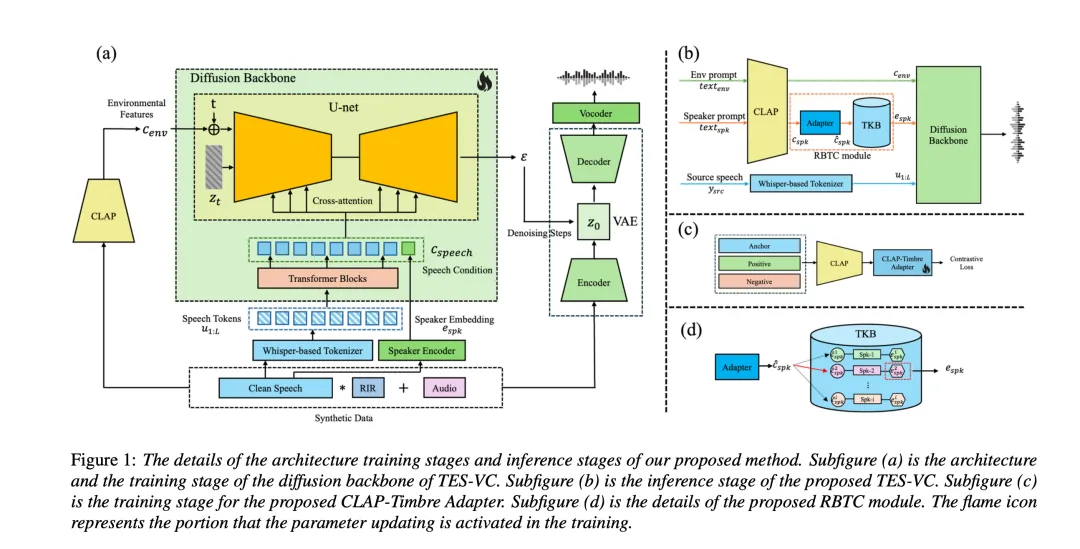
主要创新点:文本驱动的语音转换(Text-driven Voice Conversion)由于其控制的灵活性和用户友好性而受到广泛的应用和关注。现有的方法往往关注改变语音的内部特征(情感、音色、音调等),而忽略了语音的外部特征(声学环境)。本文提出了一种文本驱动的环境与说话人可控语音转换框架TES-VC,该框架能够分别独立控制说话人的音色和环境声学。TES-VC通过处理目标语音和环境的同步文本输入,能够准确地生成与描述的音色和环境相匹配的语音,同时保留原始语音的内容。该方法通过潜在扩散建模,在自动合成的数据上进行训练,这些数据具有分离的语音和环境特征,从而消除了属性之间的干扰。此外,本文还提出了一个基于检索的音色控制(RBTC)模块,可以在无需文本-语音数据对的情况下,利用抽象描述对说话人的音色进行精确操控。实验结果表明,TES-VC能够有效地通过输入文本控制语音的音色和说话环境,具有高内容保真度和优越的可控性,展示了其在广泛应用中的巨大潜力。
04、StarVC: A Unified Auto-Regressive Framework for Joint Text and Speech Generation in Voice Conversion
作者:Fengjin Li, Jie Wang, Yadong Niu, Yongqing Wang, Meng Meng, Jian Luan, Zhiyong Wu
合作单位:小米大模型团队
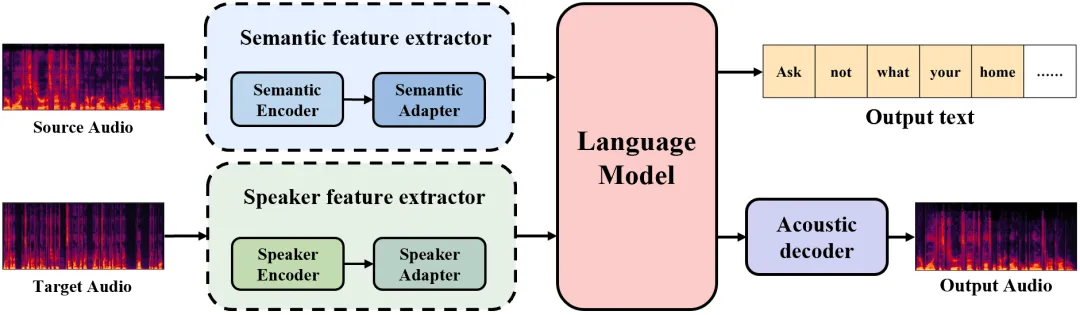
主要创新点:语音转换(Voice Conversion, VC)旨在转换一段语音的音色,使其听起来像是另一个人说出来的一样,同时要保持原始语音的文本内容不变。语音转换的核心在于将说话人信息与语言内容解耦。传统的语音转换方法通常直接从语音中提取说话人信息,并未充分利用文本内容的显式表征;而目前已有的利用语义特征来提高语音转换的工作,在保证语义完整度和提高说话人音色相似度上收效甚微。为此,本文提出StarVC:一种基于自回归架构的语音转换框架。其创新性地采用先预测文本语义信息、再合成声学特征的两阶段建模策略,通过引入结构化的语义特征,以此来提升语义与说话人间的解耦程度。实验表明,本文所提方法在说话人相似度(SSIM)上与CosyVoice等强大的基线模型持平,而在词错误率(WER)、字符错误率(CER)以及主观意见得分(MOS)上更优。
05、DAFMSVC:One-Shot Singing Voice Conversion with Dual Attention Mechanism and Flow Matching
作者:Wei Chen, Binzhu Sha, Dan Luo, Jing Yang, Zhuo Wang, Fan Fan, Zhiyong Wu
合作单位:华为2012实验室
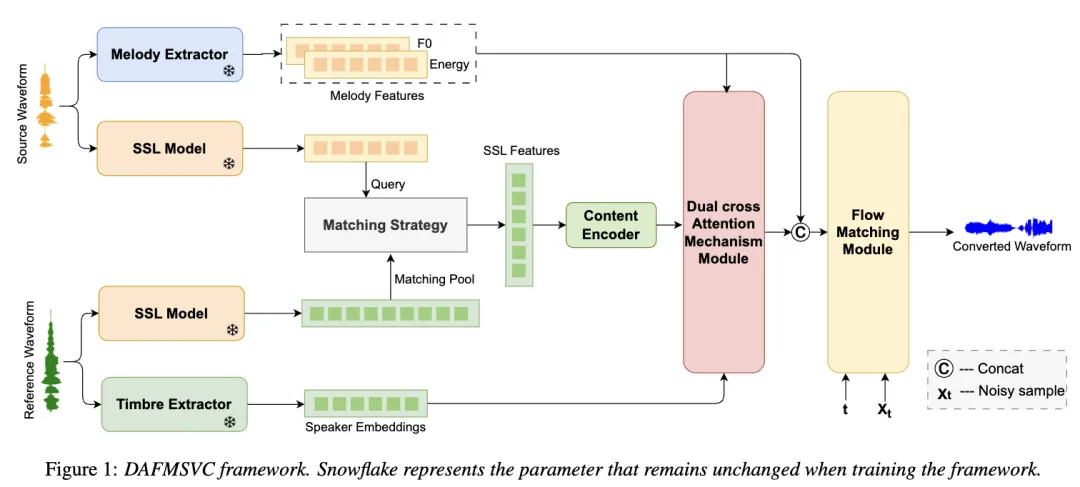
主要创新点:歌声转换(Sing Voice Conversion, SVC)旨在将源歌声中的源歌手音色转换为目标歌手的音色,同时保留原始的旋律和内容。零样本歌声转换的核心挑战在于如何将未知的目标歌手音色转移到源音频中,并且保证音频的质量。现有方法主要依赖说话人嵌入向量来建模音色,但仅依赖说话人嵌入向量难以包含所有必要的人声信息;也有方法采用自监督特征的替换策略来实现音色转换,虽然解决了音色泄露问题,但其基于内容的匹配机制使得音色信息的转移受到限制,降低了音色相似度和音频质量。为了解决这些问题,本文提出了DAFMSVC,其首先将源音频的自监督学习(SSL)特征替换为目标音频中最相似的SSL特征,以防止音色泄漏;其次,提出了一种双重交叉注意力机制(Dual Attention),用于说话者嵌入、旋律和语言内容的自适应融合;此外,还引入了流匹配模块(Flow Matching),用于从融合特征中生成高质量的音频。实验结果表明,DAFMSVC显著提高了音色相似性和自然度,在主观和客观评价方面都优于最先进的方法。
06、DiffDSR: Dysarthric Speech Reconstruction Using Latent Diffusion Model
作者:Xueyuan Chen, Dongchao Yang, Wenxuan Wu, Minglin Wu, Jing Xu, Xixin Wu, Zhiyong Wu, Helen Meng
合作单位:香港中文大学、健声科技有限公司
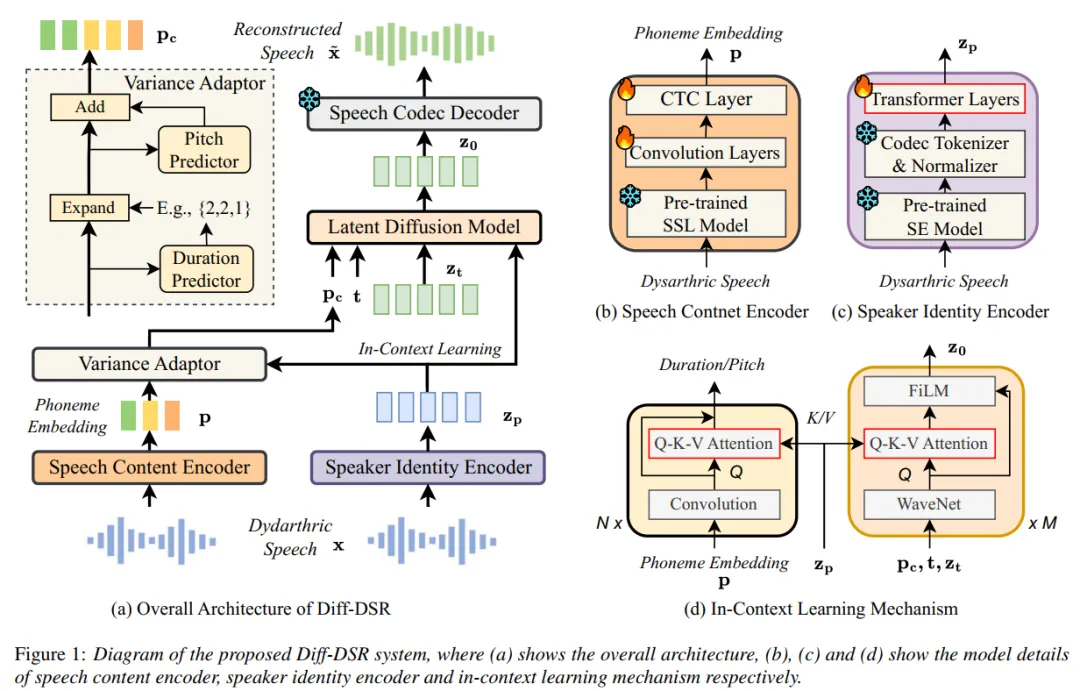
主要创新点:构音障碍语音重建(Dysarthric Speech Reconstruction, DSR)旨在将构音障碍语音转换为可理解的语音,同时保持说话人的身份(音色)。尽管已有方法取得了显著进展,但仍存在语音内容可懂度低和音色相似度低的问题。本文提出了一种基于扩散模型的DSR系统,该系统利用潜在扩散模型来提升语音重建的质量。所提模型包括:(i)语音内容编码器,用于通过预训练的自监督学习(Self-Supervised Learning, SSL)语音基础模型提取和恢复音素表征;(ii)说话人身份编码器,用于通过上下文学习(In-Context Learning)机制保留说话人的身份(音色);(iii)基于扩散模型的语音生成器,用于基于恢复的音素表征和保留的说话者身份重建语音。通过在广泛使用的UASpeech语料库上的测试,实验结果表明,本文提出的模型在语音内容可懂度和说话人相似度方面均有显著提升。
07、WAKE: Watermarking Audio with Key Enrichment
作者:Yaoxun Xu, Jianwei Yu,Hangting Chen, Zhiyong Wu, Xixin Wu,Dong Yu, Rongzhi Gu, Yi Luo
合作单位:腾讯AI Lab
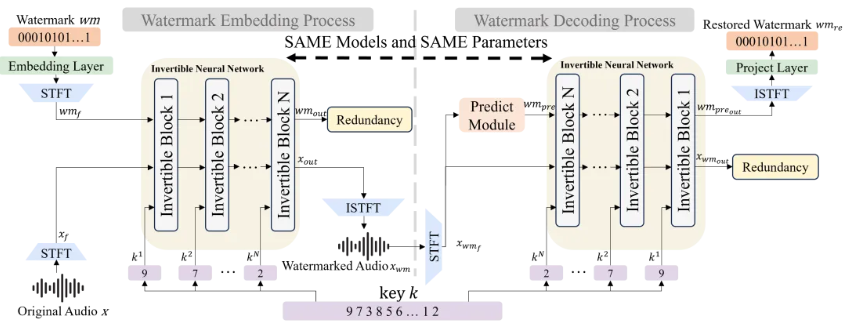
主要创新点:随着深度学习在音频生成领域的快速应用,音频安全和版权保护方面的挑战凸显了对稳健的音频水印技术的迫切需求。最近,基于神经网络的音频水印方法取得了显著进展,但仍面临三个主要问题:无法有效防止未经授权的访问、多次嵌入后难以解码初始水印、以及难以嵌入不同长度的水印。为了解决这些问题,本文提出了首个基于密钥的可控音频水印框架WAKE。该框架使用特定的密钥来嵌入水印,并且必须使用相应的密钥才能恢复水印,能有效避免使用错误的密钥来解码水印,从而提高了安全性。此外,该框架还能有效解决多次嵌入水印的覆盖问题,可以在多次嵌入后仍能有效解码出相应的水印。进一步的,由于使用密钥来嵌入水印,该框架天然支持插入可变长度的水印。实验结果表明,WAKE在水印音频质量和水印检测准确性方面都显著优于现有模型。该工作已经开源,相关代码和效果展示可扫描二维码关注。
08、VoiceMark: Zero-Shot Voice Cloning-Resistant Watermarking Approach Leveraging Speaker-Specific Latents
作者:Haiyun Li, Zhiyong Wu, Xiaofeng Xie, Jingran Xie, Yaoxun Xu, Hanyang Peng
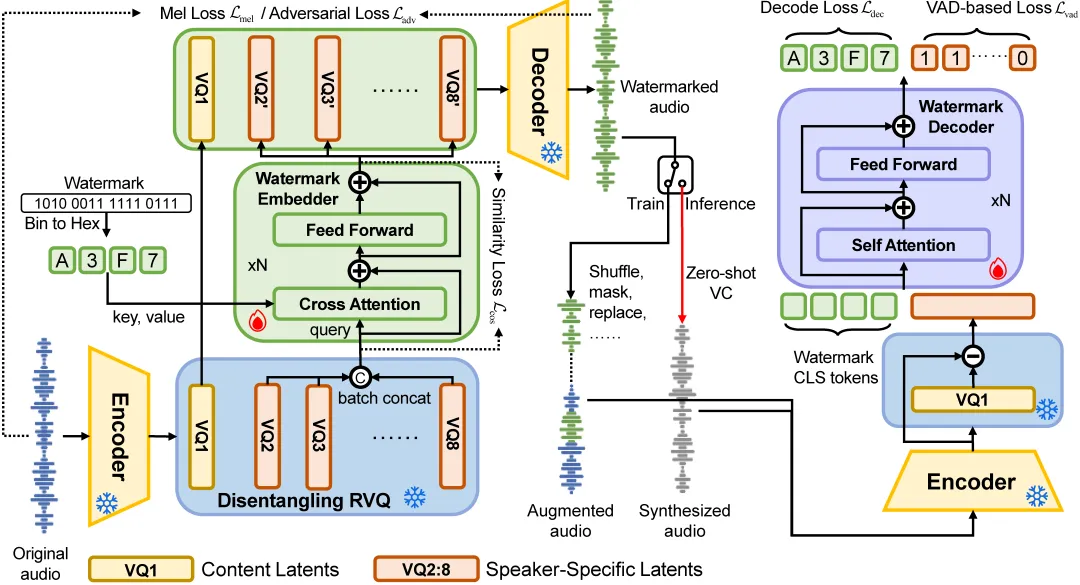
主要创新点:本文提出了首个对抗零样本语音克隆(zero-shot Voice Cloning)场景的语音水印方法VoiceMark。当前已有的语音水印方法主要通过在模型训练阶段嵌入水印来应对传统语音克隆模型。但在零样本语音克隆场景中,由于克隆模型仅依赖音频提示进行语音合成,现有方法无法通过训练实现水印嵌入。本文提出将说话人潜在表征作为水印载体,使水印能够在零样本语音克隆过程中被保留并传递到合成语音中。此外,VoiceMark还引入了语音克隆模拟增强策略和基于语音活动检测的损失函数,以增强水印在各种语音失真条件下的鲁棒性。在多个零样本语音克隆模型上的实验结果表明,VoiceMark显著优于现有方法,其在语音克隆合成后的水印检测准确率超过95%,而现有方法的准确率约为50%。