
 语音小管家
大规模训练语料库极大地提高了语音识别(ASR)模型的性能。然而由于数据相对匮乏,口音和方言仍然是大多数ASR模型面临的挑战。自监督学习的最新进展表明,其与大型语言模型(LLM)相结合,可以有效提高低资源场景下的 ASR 性能。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)和中国电信人工智能研究院合作论文“Leveraging LLM and Self-Supervised Training Models for Speech Recognition in Chinese Dialects: A Comparative Analysis”被语音研究顶级会议INTERSPEECH2025接收。该论文旨在研究这种范式对汉语方言的有效性。论文在 30 万小时的无标注方言和重口音语音数据上对 Data2vec2 模型进行预训练,并在 4 万小时的有标注数据集上进行对齐训练。系统地检验了在此范式下各种Projector和 LLM 对普通话、方言和重口音语音识别性能的影响。
本文方法在包括 Kespeech 在内的多个方言/口音数据集上取得了 SOTA 结果。现对该论文进行简要的解读和分享。
论文题目:Leveraging LLM and Self-Supervised Training Models for Speech Recognition in Chinese Dialects: A Comparative Analysis
作者列表:徐天翼 陈虹洁 王晴 吕航 康健 李杰 林振楠 李永翔 谢磊
合作单位:中国电信TeleAI
论文原文:https://arxiv.org/abs/2505.21138
发表论文截图
背景动机
大规模训练语料库显著提升了语音识别(ASR)模型的性能[1,2,3,4]。然而方言标注数据仍然成本高昂,难以大量获取。当前中文语音处理社区的主流预训练模型(如WeNet[5]、K2[6]和FunASR[7])在方言识别方面表现有限。近来,自监督学习(Self-supervised learning, SSL)的进展揭示了大模型训练的潜力:大语言模型(LLM)[8,9,10,11]展现出卓越的语言理解与生成能力,而Wav2Vec2[12]、HuBERT[13]和Data2Vec2[14]等语音SSL模型则表现出强大的语音建模能力。鉴于ASR传统上依赖声学与语言建模,自监督预训练声学模型与大语言模型的优势——尤其是其训练数据与模型规模的可扩展性——为低资源ASR系统提供了新的可能性。
当前LLM与ASR系统的融合研究主要遵循两种路径:第一种是级联方法[15,16,17],通过LLM优化ASR系统产生的N-best候选结果。其中MMGER[18]在中文口音数据集Kespeech[19]上取得了先前最优性能,但该方法存在缺陷——当N-best列表信息不足时,LLM难以从错误预测中推断正确结果,甚至可能导致语义失真。第二种是音频-文本跨模态LLM方法[20,21,22],通过语音编码器生成嵌入向量供LLM解码。例如SALMONN[20]联合使用Whisper[1]和BEATs[23]实现语音/音乐/声效的多维感知;Qwen-Audio系列[22,24]以Whisper为编码器,通过结构化任务指令优化多领域性能;SLAM-ASR[21]仅训练投影层即在LibriSpeech上达到SOTA;而Geng等[25]采用HuBERT编码器和Transformer投影层,在AISHELL等中文数据集上取得最优表现。
基于大规模中文方言数据集,本文系统探索了语音基础编码器与LLM解码器范式的潜力。我们使用包含30万小时无标注方言语音和4万小时标注语音数据,全面考察了不同语音编码器、Projector和LLM对中文方言ASR性能的影响。实验发现:
语音编码器中,Data2Vec2降采样至25Hz时表现优异,结合Projector的4倍降采样可使LLM帧率低至6.25Hz,显著降低计算开销;
全连接层作为Projector效果最优,尤其在训练初期差异显著,但随着预训练参数逐步解冻,差异逐渐缩小;
四阶段训练策略相比传统三阶段方案能持续提升性能。
相比前人工作[21,25],我们采用Data2Vec2作为语音编码器、卷积层作为Projector,配合四阶段训练策略,在Kespeech(CER 6.48% vs 7.52%)等多个中文方言/口音测试集上达到SOTA性能,即便使用小规模LLM(0.5B)和低帧率(6.25Hz)也表现优异。
实验方案
如图1所示,模型架构由音频编码器与大语言模型(LLM)构成。训练过程中每个样本包含三个要素:文本提示(如"转写以下语音")、语音片段及对应文本转录,分别记为P、S、T。文本提示与转录通过LLM的分词器处理并嵌入为特征向量:
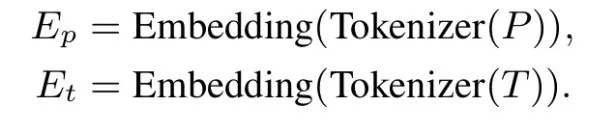
对于输入语音S,首先通过语音编码器提取特征,生成编码器输出:
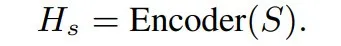
该输出依次经过Projector和线性层,生成与LLM输入维度一致的特征序列:
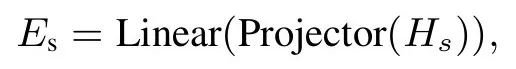
其中Projector保持语音编码器的输出维度,而线性层将特征映射至LLM的嵌入空间。最终将Es、Ep、Et拼接为统一特征序列输入LLM,模型输出转录结果:
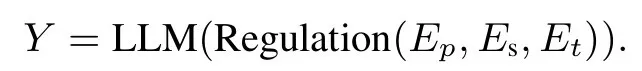
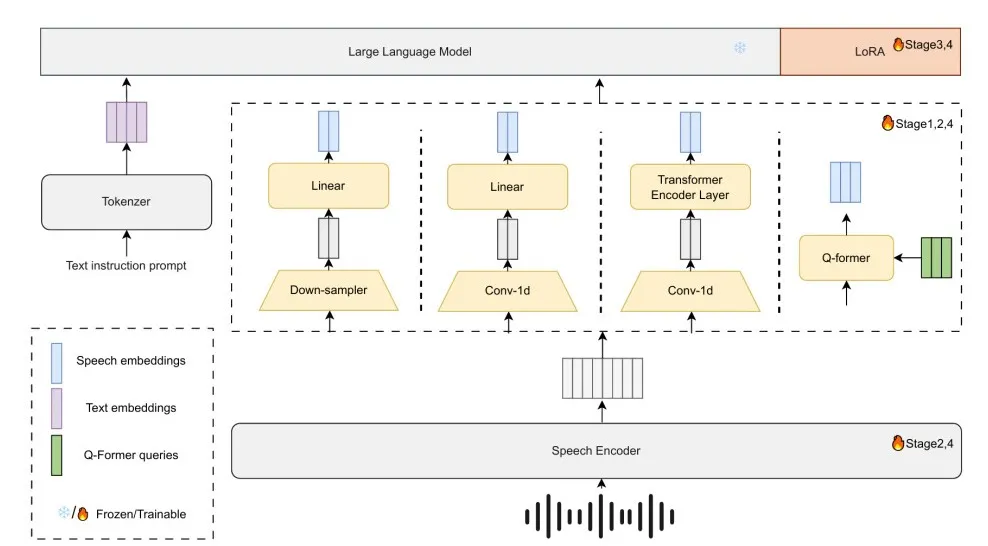
图1 模型架构
实验配置
数据集
训练集训练数据包含多样化的内部方言与口音数据,涵盖安徽、甘肃、河北、山东、山西、天津、粤语(广东)、河南、四川、重庆、东北、陕西、湖北、福建、贵州、杭州、湖南、江西、上海、苏州、云南、重庆及客家话样本。同时纳入公开普通话数据集,如Wenetspeech[26]、Aishell[27]及AliMeeting。无监督模型训练总数据量约30万小时,有监督数据集为4万小时。
测试集鉴于多数方言缺乏开源测试集,且现有数据集存在局限(如语音片段过短难以体现方言特征),我们采用内部标注测试集进行评估。具体针对四种方言:上海话、湖南话、河南话及粤语,各包含约2000个音频样本。另使用开源Kespeech数据集[19]评估口音语音表现,该数据集包含普通话及北京、江淮、胶辽、冀鲁、兰银、东北、西南、中原等区域方言。但需指出的是,该数据集口音特征不够显著,许多说话者实际口音特征微弱。最后,采用Wenetspeech的Test-net与Test-meeting子集评估普通话识别性能。
核心组件
大语言模型(LLM)为保障跨方言/口音的鲁棒识别性能,需选用中文任务能力优异的LLM。鉴于LLM评估体系尚未标准化,我们参考中文大模型评测榜单CLiB(综合多任务能力评估)。在70亿参数以下的开源模型中,Qwen 2系列[28]综合得分最高,故本研究选用Qwen 2的0.5B/1.5B/7B版本及Qwen 2.5的3B版本(Qwen 2.5于研究后期发布)。测试发现该系列能有效处理方言及口语化中文对话。
语音基础编码器前期研究[29]对比了多种自监督语音编码器(Wav2vec2[12]、HuBERT[13]、BEST-RQ[30]、DinoSR[31]、Data2vec2[14]),在Wenetspeech预训练中Data2vec2表现最优。本研究进一步使用30万小时无标注多语言/口音语音训练Data2vec2的TeleSpeechPT变体:24层结构,3.01亿参数,采样率25Hz(低于Whisper编码器常用的50Hz)。
Projector语音模态表征稀疏性高于文本模态,易导致计算复杂度上升。为提升推理效率,现有研究常采用投影层对齐跨模态特征。鉴于学界对语音LLM的最佳投影层尚未达成共识,我们在中文方言场景下对比四类投影层:全连接层(Linear),一维卷积层(Conv1d),Transformer层,Q-Former[32]。全连接与卷积层实验配置延续SLAM方案,下采样率设1/2/4/8倍;Q-Former沿用SLAM的64查询向量配置;Transformer层参照文献[25]方案。
训练策略基于大语言模型的参数量通常极为庞大,同时训练整个模型容易导致性能欠佳。现有研究[20,22,25]采用的三阶段微调策略虽能协调模块收敛,但该方式可能使模型陷入各模块内部的局部最优解而非全局最优。为此,我们在三阶段框架基础上引入第四阶段——解冻全部模型参数进行端到端微调。实验表明该改进能有效提升语音识别性能。具体流程如图1所示:第一阶段仅训练投影器并冻结其余组件;第二阶段专训语音编码器;第三阶段冻结编码器与投影器,采用LoRA技术微调大语言模型;第四阶段解冻编码器与投影器进行联合优化。
实现细节模型训练使用8张40GB显存的A100显卡,7B版本完成四阶段微调约需30天。实验基于SLAM框架[21],采用AdamW优化器[33](学习率1.0e-05、动量参数(0.9, 0.99)、数值稳定项1.0e-06、权重衰减0.01)。为抑制梯度爆炸风险,设置阈值为5的梯度裁剪[34](超过±5的梯度值将被截断至±5),并采用20步梯度累积使有效批大小增至100。大语言模型微调时冻结主干网络,通过LoRA技术[35]进行参数更新(alpha控制矩阵权重设为32,rank决定低秩矩阵维度设为12)。除特殊说明外,所有实验均遵循此配置。
实验结果
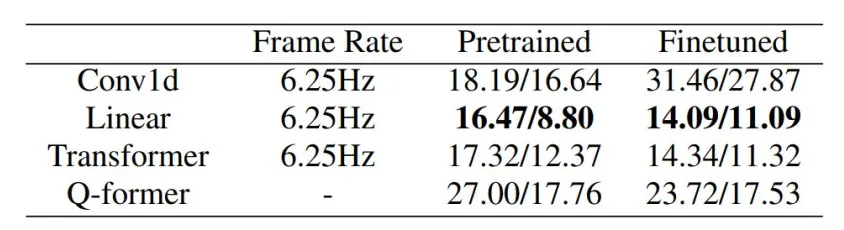
Projector架构对比通过小规模实验评估了四种投影层(全连接层、一维卷积层、Transformer层及Q-Former)的有效性。实验采用经30万小时数据预训练的Data2Vec2模型,在Test-meeting与Test-net数据集测试。固定使用Qwen2 0.5B作为大语言模型,且仅进行第一阶段100万步训练。Data2vec2编码器原始采样率为25Hz,经4倍降采样后输入LLM的嵌入采样率降至6.25Hz;Q-Former投影层则采用固定64维嵌入长度而非预设采样率。如表2所示,全连接层在四种投影架构中取得最佳综合性能。
表1 微调与否的编码器和不同种类的连接层Test-net/Test-meeting上测试的CER%的对比
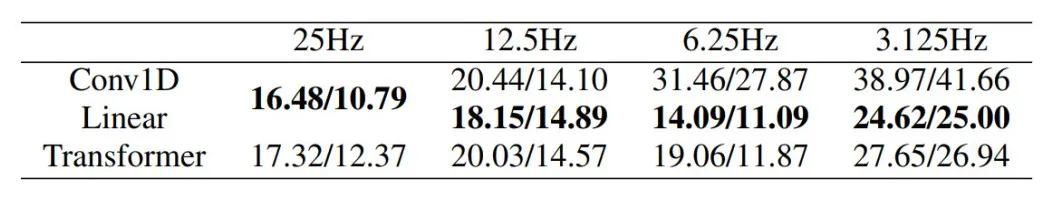
投影层采样率我们探究了不同降采样率对投影层的影响。实验在全连接层、卷积层及Transformer层上测试了1/2/4/8倍降采样率,分别对应语音编码器输出的25Hz/12.5Hz/6.25Hz/3.125Hz帧率。由于Q-Former将语音表征压缩为固定长度嵌入,无法进行特定采样率比较。结果表明:较低降采样率保留更多语音信息,可获得更低字符错误率(CER),但会显著增加LLM计算负载。后续实验采用4倍降采样率以平衡识别精度与计算效率——结合编码器固有4倍降采样,LLM输入帧率最终为6.25Hz,在性能与资源消耗间实现较优权衡。
表2 不同连接层的不同采样率在Test-net/Test-meeting上测试的CER%的对比
ASR微调与否编码器对比我们探究了基于CTC目标函数的ASR专项编码器微调是否有利于其与LLM的语义对齐,或是否与LLM微调所需知识产生冲突。为此,我们首先预训练Data2Vec2编码器,随后采用4万小时有监督数据集通过CTC进行10轮微调以获取语音识别能力。将此ASR微调后的编码器替换原始预训练编码器,在相同百万步微调流程下进行实验。表1结果显示:相较于未微调版本,ASR微调编码器在四类投影层中均表现劣化,其中一维卷积投影层的性能差距最为显著。这表明CTC微调所获得的知识可能与LLM微调所需的语义信息存在冲突,最终损害整体识别性能。
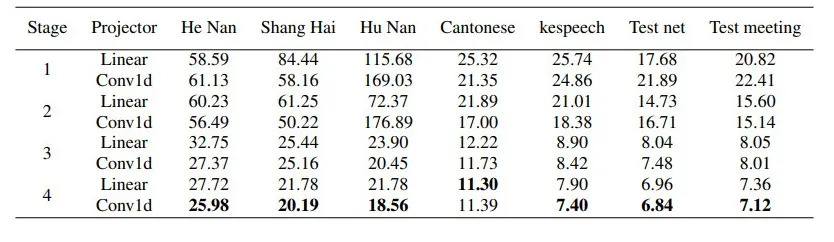
多阶段微调对比分析我们将研究扩展至多阶段训练的大规模实验。选取表1所示第一阶段训练后性能最优(全连接层)与最差(一维卷积层)的投影架构,采用包含4万小时多方言语音数据的有监督数据集进行四阶段微调。表4结果显示:尽管第一阶段结束时两类架构在Test-net/Test-meeting数据集上性能差异显著(CER分别为31.46/27.87 vs 16.47/8.80),但随着后续训练阶段推进,这种差距逐步缩小——直至最终阶段性能关系发生逆转。基于此现象,我们推测当多阶段微调过程中逐步解冻更多模型组件时,投影器参数与结构差异的影响将趋于弱化。
表3 40,000 小时多方言的多阶段训练模型在不同方言测试集的的CER%结果
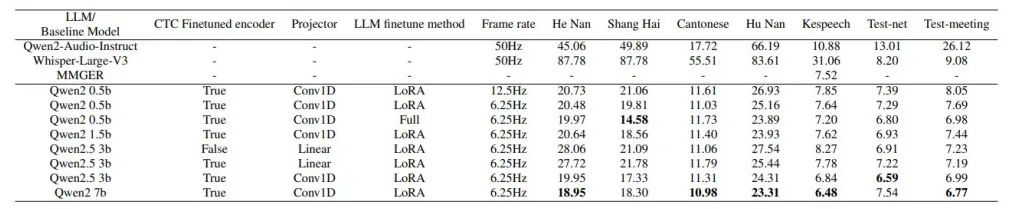
不同规模LLM对比分析我们在4万小时数据集上评估了Qwen系列0.5B/1.5B/3B/7B模型经四阶段微调的性能(表3)。针对0.5B模型,对比LoRA微调与全参数微调发现后者显著提升性能,表明LoRA参数不足以充分学习声学表征。需特别说明:3B模型属研究后期发布的Qwen2.5系列,其训练文本标记量虽达18T(Qwen2 7B为7T)且MMLU分数接近7B模型(65.6 vs 70.3),但实验显示此优势未转化为显著性能增益。所有实验中,更大规模LLM始终展现更优性能,印证模型扩缩容的价值。值得注意的是:最小型的0.5B模型仍取得具有竞争力的结果——在Kespeech数据集超越当前SOTA方法MMGER[18],并在内部测试集与公开测试集上均优于Qwen2-Audio及Whisper-Large-V3。
表4 4阶段微调过程中不同阶段微调的CER 变化
结论
本文基于4万小时中文方言与口音语音数据集,系统探索了自监督训练编码器与LLM解码器组合范式中各类结构的性能。编码器采用经30万小时无标注方言语音预训练的Data2Vec2;Projector方面,全连接层展现出优于其他类型的性能优势;训练策略上,多阶段训练显著提升模型性能,传统三阶段框架扩展为四阶段后获得进一步增益。Projector的效能差异在训练初期最为显著,但随着预训练参数在多阶段过程中逐步解冻,这些差异逐渐弱化。我们在Kespeech等中文方言测试集上实现了SOTA性能,并将开源全部技术方案与预训练模型。
参考文献
[1] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, "Robust Speech Recognition via Large-Scale Weak Supervision," inProc. ICML, 2023.
[2] Y. Zhang et al., "Google USM: Scaling Automatic Speech Recognition Beyond 100 Languages,"arXiv:2303.01037, 2023.
[3] V. Pratap et al., "Scaling Speech Technology to 1,000+ Languages,"J. Mach. Learn. Res., vol. 25, no. 97, pp. 1–52, 2024.
[4] S. Chen et al., "WavLM: Large-Scale Self-Supervised Pre-training for Full Stack Speech Processing,"IEEE J. Sel. Top. Signal Process., vol. 16, no. 6, pp. 1505–1518, 2022.
[5] B. Zhang et al., "WeNet 2.0: More Productive End-to-End Speech Recognition Toolkit," inProc. Interspeech, pp. 1–5, 2022.
[6] Z. Yao et al., "Zipformer: A Faster and Better Encoder for Automatic Speech Recognition," inProc. ICLR, 2023.
[7] Z. Gao et al., "FunASR: A Fundamental End-to-End Speech Recognition Toolkit," inProc. Interspeech, pp. 1593–1597, 2023.
[8] L. Floridi and M. Chiriatti, "GPT-3: Its Nature, Scope, Limits, and Consequences,"Minds Mach., vol. 30, pp. 681–694, 2020.
[9] H. Touvron et al., "LLaMA: Open and Efficient Foundation Language Models,"arXiv:2302.13971, 2023.
[10] OpenAI, "GPT-4 Technical Report,"arXiv:2303.08774, 2023.
[11] Gemini Team et al., "Gemini 1.5: Unlocking Multimodal Understanding Across Millions of Tokens of Context,"arXiv:2403.05530, 2024.
[12] A. Baevski, Y. Zhou, A. Mohamed, and M. Auli, "wav2vec 2.0: A Framework for Self-Supervised Learning of Speech Representations,"Adv. Neural Inf. Process. Syst., vol. 33, pp. 12449–12460, 2020.
[13] W. Hsu et al., "HuBERT: Self-Supervised Speech Representation Learning by Masked Prediction of Hidden Units," inProc. ICASSP, 2021.
[14] A. Baevski et al., "Data2vec: A General Framework for Self-Supervised Learning in Speech, Vision and Language," inProc. ICML, pp. 1298–1312, 2022.
[15] R. Huang et al., "AudioGPT: Understanding and Generating Speech, Music, Sound, and Talking Head," inProc. AAAI Conf. Artif. Intell., vol. 38, no. 21, pp. 23802–23804, 2024.
[16] P. Dighe et al., "Leveraging Large Language Models for Exploiting ASR Uncertainty," inProc. ICASSP, pp. 12231–12235, 2024.
[17] R. Ma et al., "Can Generative Large Language Models Perform ASR Error Correction?"arXiv:2307.04172, 2023.
[18] B. Mu et al., "MMGER: Multi-Modal and Multi-Granularity Generative Error Correction with LLM,"arXiv:2405.03152, 2024.
[19] Z. Tang et al., "KeSpeech: An Open Source Speech Dataset of Mandarin and Its Eight Subdialects," inProc. NeurIPS Datasets Benchmarks Track, 2021.
[20] C. Tang et al., "SALMONN: Towards Generic Hearing Abilities for Large Language Models,"arXiv:2310.13289, 2023.
[21] Z. Ma et al., "An Embarrassingly Simple Approach for LLM with Strong ASR Capacity,"arXiv:2405.11014, 2024.
[22] Y. Chu et al., "Qwen-Audio: Advancing Universal Audio Understanding via Unified Audio-Language Models,"arXiv:2311.07919, 2023.
[23] S. Chen et al., "BEATs: Audio Pre-training with Acoustic Tokenizers," inProc. ICML, pp. 5178–5193, 2023.
[24] Y. Chu et al., "Qwen2-Audio Technical Report,"arXiv:2407.10759, 2024.
[25] X. Geng et al., "Unveiling the Potential of LLM-based ASR on Chinese Open-Source Datasets," inProc. ISCSLP, pp. 26–30, 2024.
[26] B. Zhang et al., "WenetSpeech: A 10000+ Hours Multi-Domain Mandarin Corpus for Speech Recognition," inProc. ICASSP, 2022.
[27] H. Bu et al., "AISHELL-1: An Open-Source Mandarin Speech Corpus," inProc. O-COCOSDA, 2017.
[28] A. Yang et al., "Qwen2.5 Technical Report,"arXiv:2412.15115, 2024.
[29] H. Chen et al., "TeleSpeechPT: Large-Scale Chinese Multi-Dialect Speech Pre-training," inProc. NCMMSC, pp. 183–190, 2024.
[30] C.-C. Chiu et al., "Self-Supervised Learning with Random-Projection Quantizer for Speech Recognition," inProc. ICML, pp. 3915–3924, 2022.
[31] A. H. Liu et al., "Dinosr: Self-Distillation and Online Clustering for Self-Supervised Speech Representation Learning,"Adv. Neural Inf. Process. Syst., vol. 36, pp. 58346–58362, 2023.
[32] W. Yu et al., "Connecting Speech Encoder and Large Language Model for ASR," inProc. ICASSP, pp. 12637–12641, 2024.
[33] I. Loshchilov and F. Hutter, "Decoupled Weight Decay Regularization," inProc. ICLR, 2019.
[34] J. Zhang et al., "Why Gradient Clipping Accelerates Training: A Theoretical Justification for Adaptivity," inProc. ICLR, 2020.
[35] E. J. Hu et al., "LoRA: Low-Rank Adaptation of Large Language Models," inProc. ICLR, 2022.
