
 语音小管家
当前全球现存超 7000 种语言,学术界和工业界对多语种语音识别(Multilingual Automatic Speech Recognition)的研究热度持续攀升,核心目标在于扩大语种覆盖范围并提升跨语言识别性能[1][2]。然而,基于统一架构的单一Multilingual ASR模型难以平衡多语言间的语音差异与数据资源不平衡问题,而基于前置语种识别(LID)的传统级联方案又面临高成本与分类误差的双重挑战。近年来,语音大语言模型(Speech Large Language Model, SLLM)的兴起为多语言 ASR 带来了新思路 —— 通过评估语音内容的复杂度,实现识别策略的智能决策成为可能。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)与字节跳动合作的论文 “Selective Invocation for Multilingual ASR: A Cost-effective Approach Adapting to Speech Recognition Difficulty” 被语音领域顶级会议 Interspeech 2025 接收。该研究提出了一种名为Selective Invocation for Multilingual ASR (SIMA) 的多语言 ASR 选择性调用方法,创新性地构建了基于 Speech LLM 动态判断语音难度的机制,实现简单语音直接转录、复杂语音调用专业模型的高效机制。现对该论文进行简要的解读和分享。
论文题目:Selective Invocation for Multilingual ASR: A Cost-effective Approach Adapting to Speech Recognition Difficulty
作者列表:薛鸿飞,唐玉峰,张骏,耿雪龙,谢磊
合作单位:字节跳动
论文原文:https://arxiv.org/abs/2505.16168
背景动机
如图1(a),尽管多语种自动语音识别(Multilingual ASR)系统已取得显著进展,使单一模型能够处理多种语言,但语言间的固有差异(如语音、语法、词汇)和数据不平衡问题,导致模型难以在所有语言上均实现SOTA性能。如图1(b),传统基于语种识别(LID-based)的两阶段方案虽能通过调用专用模型提升效果,但面临两大核心挑战:
成本高昂:商用 SOTA 模型需按处理量付费,全量调用会显著增加开销;
鲁棒性不足:LID 分类错误可能导致错误调用,进一步恶化用户体验。
近年来,语音大语言模型(SLLM)的发展为解决上述问题提供了新思路。SLLM 不仅具备语音理解能力[3][4],还可能具备评估自身转录准确性的能力。研究表明,语音识别难度与声学环境、词汇复杂度密切相关:简单语音(如干净环境下的基础词汇)即使非 SOTA 模型也能实现低错误率,而复杂语音(如噪声干扰或专业术语)则依赖 SOTA 模型的强鲁棒性。然而,现有方案尚未充分利用 SLLM 对语音复杂度的动态评估能力,无法在 “直接转录” 与 “调用模型” 之间实现智能决策。
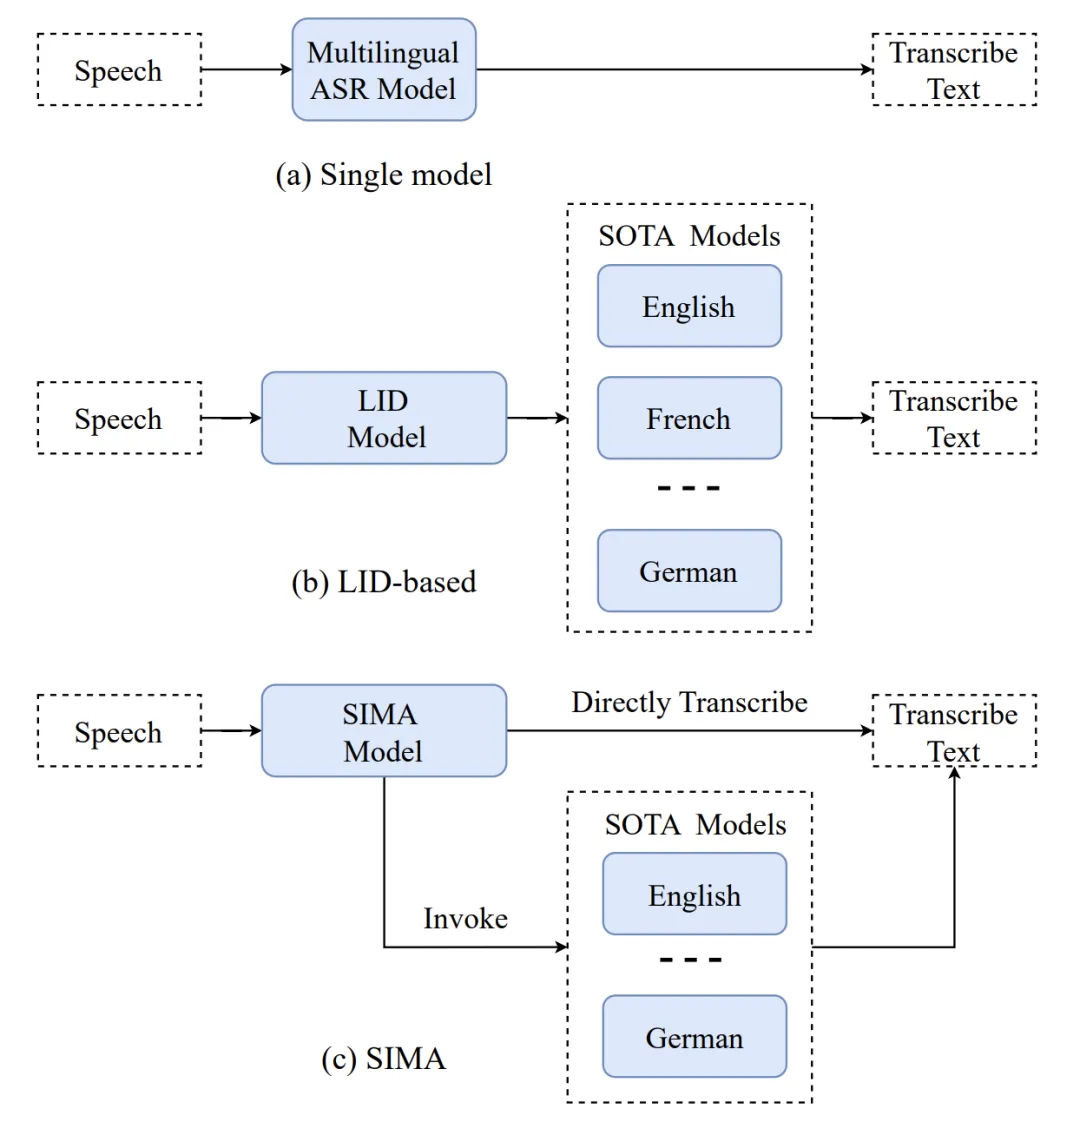
图1 三种 Multilingual ASR 系统对比
本文针对上述痛点,提出选择性调用模型 SIMA(Selective Invocation for Multilingual ASR),如图1(c)所示,其核心动机在于:
动态适配难度:通过 SIMA 决策模型判断输入语音的复杂度,简单场景直接转录以避免调用成本,复杂场景触发 SOTA 模型以保证精度;
优化决策边界:引入 “uncertain” 类别和融合置信度策略(后验概率、熵、转录流畅度),解决中间难度语音的模糊决策问题,减少误判;
平衡效率与性能:通过数据流水线动态分配调用标签(基于 WER 区间),在降低商用模型调用频率的同时,确保整体识别错误率显著下降。
实验表明,SIMA 在三个基准数据集上实现了18.7% 的相对 WER 降低和51% 的调用成本削减,为多语种 ASR 提供了可扩展的经济高效方案。
提出的方案
SIMA 的核心在于基于多语种语音大语言模型(SLLM)[5] 构建动态决策框架,通过评估语音复杂度实现 “直接转录 (Directly Transcribe)” 与 “调用 SOTA 模型 (Invoke)” 的智能选择。其架构包含两大模块:SIMA 决策模型与SOTA 模型库,具体实现如下:
SIMA 决策模型设计
模型基于多语言 SLLM 构建,通过多任务学习输出三种类型结果(如图 2 所示),并引入语言置信度辅助决策:
Invocation No(直接转录):当语音被判定为简单时,模型直接生成文本,并添加 “Invocation No” 特殊 token。训练时基于真实转录计算交叉熵损失,确保简单语音的转录精度。
Invocation Yes(调用模型):若语音复杂度高,模型输出 “Invocation Yes” token,触发 SOTA 模型调用。此场景仅对特殊 token 计算损失,聚焦于复杂度判断的准确性。
Invocation Uncertain(不确定状态):针对中间难度语音,引入第三类别 “Uncertain”,通过融合置信度策略进一步评估。该状态下的转录 token 为伪标签,仅特殊 token 参与损失计算,避免错误引导模型学习。
此外,当 Language Confidence 得分较低时(如模型对语种判断存疑),输出 Invocation No 直接转录,以规避因错误调用单语种模型导致的风险。
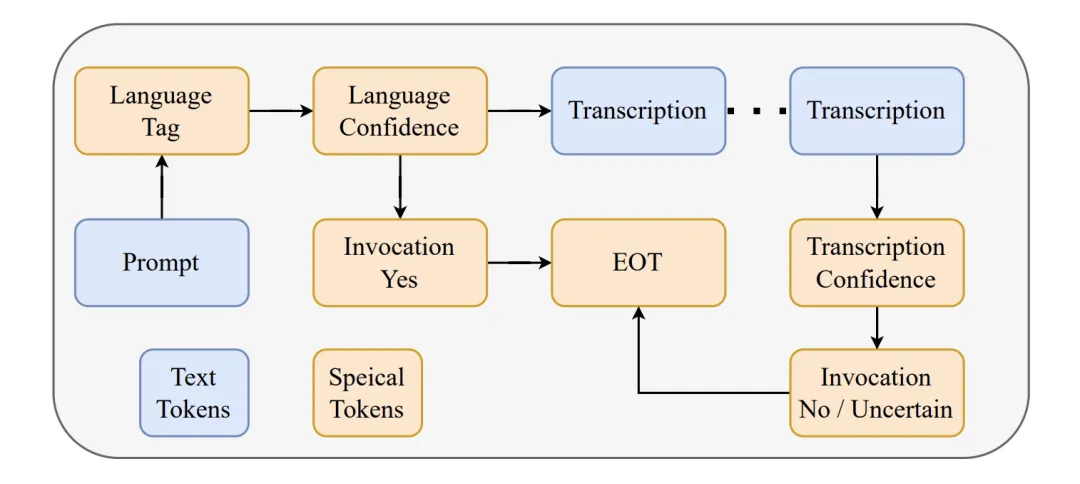
图 2 SIMA 决策模型的输出类型
融合置信度策略
针对 “Invocation Uncertain” 样本,通过三种互补指标综合判断是否需调用 SOTA 模型:
后验概率(Posterior Probability):提取模型最后一层 softmax 输出的平均最大概率值,反映预测确定性。公式为:
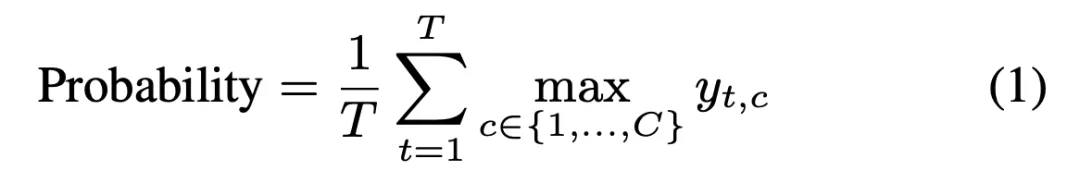
实验中设置若该值低于阈值P=0.96,表明模型对转录结果缺乏信心。
熵(Entropy):利用信息熵衡量不确定性,公式为:
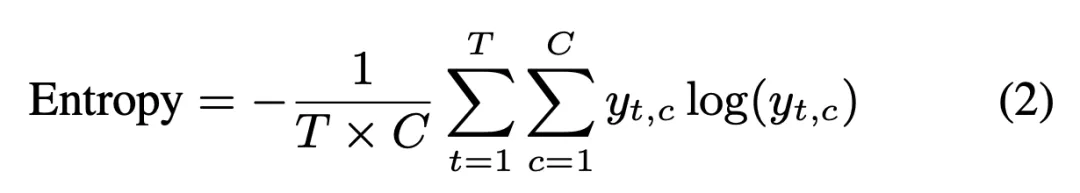
实验中设置若熵值高于阈值E=0.0015,说明预测分布分散,不确定性高。
转录置信度(Transcription Confidence):模型生成文本后,通过 SLLM 评估句子流畅度,分为 A(最高)至 D(最低)四级。实验中设置若置信度低于阈值T=B,表明转录质量可能较差。
当后验概率低于P、熵高于E且转录置信度低于T时,判定为复杂语音,触发 SOTA 模型调用。
数据生成
为训练 SIMA 模型,设计专用数据生成流程(如图 3 所示),基于Multilingual SLLM 生成伪标签并标注调用类别:
调用标签划分:根据伪转录的词错误率(WER)动态分配标签:
Invocation No:WER ∈ [0, 2](简单语音);
Invocation Yes:WER > 10(复杂语音);
Invocation Uncertain:WER ∈ (2, 10](中间难度)。
置信度生成:利用 LLM 对比伪转录与真实文本,生成转录置信度;同时通过 SLLM 推断伪 LID 及后验概率,若语种识别错误则直接标记为最低置信度(D 级),确保调用决策的鲁棒性。
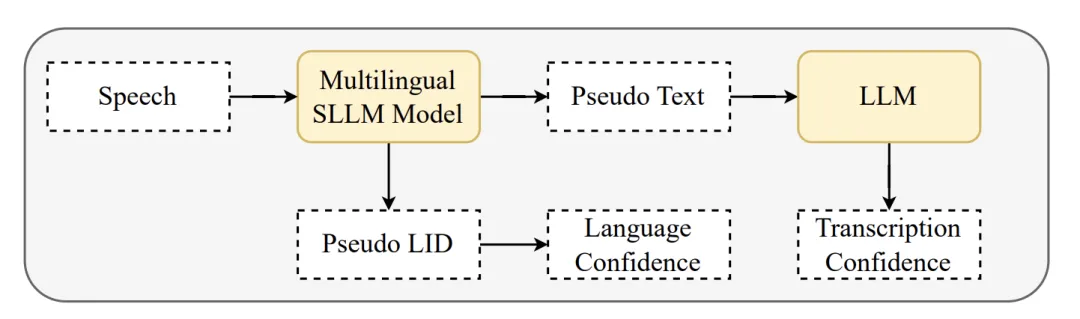
图3 SIMA 模型的数据生成流程
模型训练与优化
初始化与微调:基于 IdealLLM 架构的 SLLM 初始化 SIMA 模型,在生成的多语言数据集上进行微调,采用多任务学习平衡三类输出(比例约 1:1.5:1.5)。
效率优化:引入调用效率指标(WER 降低量 / 调用率),对比随机调用基线验证策略有效性。实验表明,SIMA 的调用决策可显著提升效率,避免 “盲目调用” 导致的成本浪费。
通过上述设计,SIMA 实现了对语音复杂度的细粒度感知,在保证识别性能的同时大幅降低 SOTA 模型调用成本,为多语言 ASR 提供了兼具灵活性与经济性的新范式。
实验设置
实验数据:采用三个多语言基准数据集验证 SIMA 的泛化性:
Multilingual LibriSpeech (MLS)[6]:涵盖英、德、法等 7 种语言,用于训练和域内测试。
VoxPopuli[7]:包含多语言议会演讲数据,侧重半监督学习场景。
FLEURS[8]:低资源语种的少样本测试集,作为域外数据评估鲁棒性。
数据划分:训练集每语言生成 10 万样本(25k 来自 VoxPopuli,75k 来自 MLS),验证 / 测试集基于原始数据集生成。
基线模型:
Base 模型:基于 IdealLLM 的 SLLM [5],同时执行 ASR 和 LID 任务,作为 SIMA 的初始化模型。
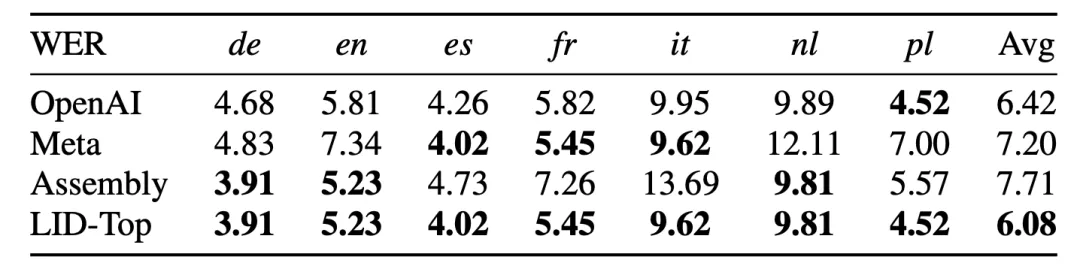
LID-based 模型:包括 OpenAI API、Meta、AssemblyAI等商用模型,选取各数据集上 WER 最低者作为基准(如表 1 所示,MLS 测试集的 LID-Top 模型平均 WER 为 6.08%)。
Random Invocation:随机调用 SOTA 模型,保持与 SIMA 相同的整体调用率,用于验证选择性策略的有效性。
表1 LID-based 模型在MLS 测试集的 WER 结果
识别性能对比
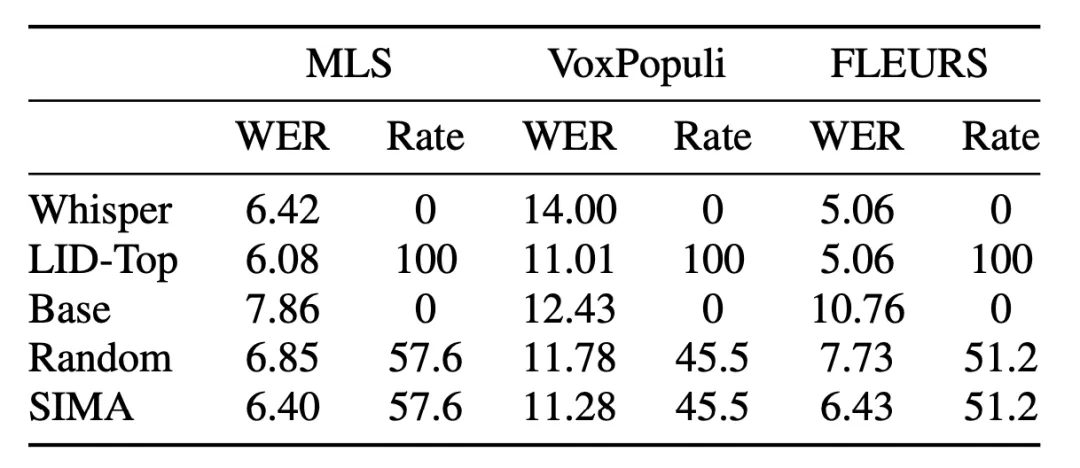
表2 列出了本文 SIMA 方法在三个数据集上的结果。SIMA 相比 Base 模型,在 MLS、VoxPopuli、FLEURS 上分别相对降低 WER 18.6%、9.3%、28.2%,证明选择性调用SOTA模型显著提升复杂语音识别精度。与 Random Invocation 相比,SIMA 在测试集上 WER 相对降低 16.8%,表明其能有效识别需调用的复杂样本,而非随机选择。
表2 三个数据集上 WER 和 Invocation Rate 的结果
成本与鲁棒性指标
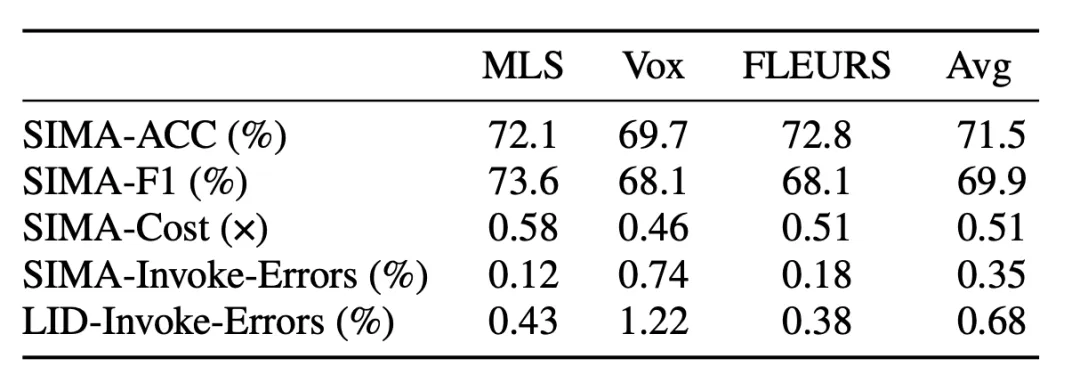
表 3 展示了 SIMA 的其他性能指标。调用决策准确率(ACC)和 F1 分数约为 70%,支持了我们的假设,即 SLLM 可以有效地根据复杂度区分语音输入。尽管 SIMA 与 LID-Top 相比存在轻微的 WER 差距,但它在三个数据集上的调用成本 SIMA-Cost 降低了约一半,显著降低了相关开销。此外,结合语言置信度预测,SIMA 的语种调用错误率(SIMA-Invoke-Errors)相比基于 LID 的方法有一定的降低。
表3 SIMA 模型在其它指标上的结果
消融实验
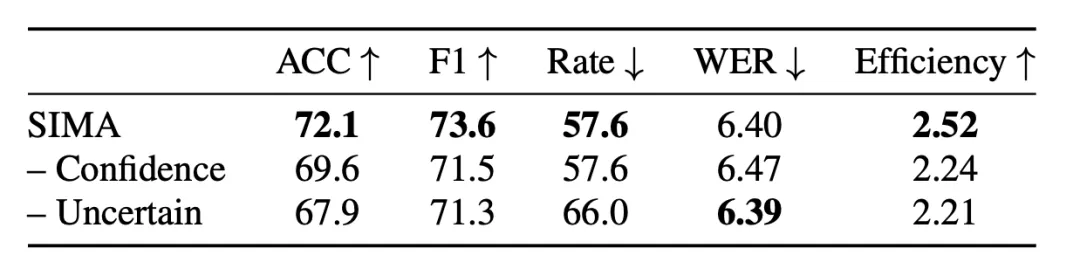
表 4 展示了在 MLS 数据集上进行的消融实验结果,聚焦于两个组件:融合置信度策略和“Invocation Uncertain” 类别的使用。我们定义了一个指标 invocation efficiency(调用效率),用于衡量 SIMA 模型调用 SOTA ASR 模型的资源利用有效性,由WER降低量/调用率计算得到。移除融合置信度策略后,WER 上升,调用效率下降,表明置信度指标对精准决策至关重要。取消 “Uncertain” 类别导致调用率增加 8.4%,效率下降 12.3%,说明中间类别可有效减少简单语音的冗余调用。
表4 置信度策略和不确定分类的消融实验结果
参考文献
[1] Alec Radford, Jong Wook Kim, Tao Xu, Greg Brockman, Christine McLeavey, and Ilya Sutskever, “Robust Speech Recognition via Large-Scale Weak Supervision,” in ICML. 2023, pp. 28492–28518, PMLR.
[2] Vineel Pratap, Andros Tjandra, Bowen Shi, Paden Tomasello, Arun Babu, Sayani Kundu, Ali Elkahky, Zhaoheng Ni, Apoorv Vyas, Maryam Fazel-Zarandi, et al., “Scaling speech technology to 1,000+ languages,” arXiv preprint arXiv:2305.13516, 2023.
[3] S. Hu, L. Zhou, S. Liu, S. Chen, L. Meng, H. Hao, J. Pan, X. Liu, J. Li, S. Sivasankaran, L. Liu, and F. Wei, “Wavllm: Towards robust and adaptive speech large language model,” in EMNLP. Association for Computational Linguistics, 2024, pp. 4552–4572.
[4] Y. Chu, J. Xu, Q. Yang, H. Wei, X. Wei, Z. Guo, Y. Leng, Y. Lv, J. He, J. Lin, C. Zhou, and J. Zhou, “Qwen2-audio technical report,” arXiv preprint arXiv:2407.10759, 2024.
[5] Hongfei Xue, Wei Ren, Xuelong Geng, Kun Wei, Longhao Li, Qijie Shao, Linju Yang, Kai Diao, Lei Xie,“Ideal-LLM: Integrating Dual Encoders and Language-Adapted LLM for Multilingual Speech-to-Text”, arXiv preprint: 2409.11214
[6] V. Pratap, Q. Xu, A. Sriram, G. Synnaeve, and R. Collobert, “MLS: A large-scale multilingual dataset for speech research,” in Conference of the International Speech Communication Association (Interspeech). ISCA, 2020, pp. 2757–2761.
[7] C. Wang, M. Riviere, A. Lee, A. Wu, C. Talnikar, D. Haz- ` iza, M. Williamson, J. M. Pino, and E. Dupoux, “Voxpopuli: A large-scale multilingual speech corpus for representation learning, semi-supervised learning and interpretation,” in ACL/IJCNLP. Association for Computational Linguistics, 2021, pp. 993–1003.
[8] A. Conneau, M. Ma, S. Khanuja, Y. Zhang, V. Axelrod, S. Dalmia, J. Riesa, C. Rivera, and A. Bapna, “FLEURS: few-shot learning evaluation of universal representations of speech,” in Spoken Language Technology Workshop (SLT). IEEE, 2022, pp. 798–805.
