
 语音小管家
低资源语音识别(ASR)长期面临两大核心挑战:高质量标注数据稀缺与高昂的计算需求,这在泰语等特定语言中尤为突出。现有解决方案往往受限于大规模、精确标注语料的获取难度,以及大模型(LLM)固有的计算负担。近期,西北工业大学音频语音与语言处理研究组(ASLP@NPU)与爱奇艺联合发表的论文“Weakly Supervised Data Refinement and Flexible Sequence Compression for Efficient Thai LLM-based ASR”,提出首个应用于泰语ASR的大模型系统EThai-ASR。该框架通过自演化数据精炼(Self-evolving Data Refinement) 策略有效精炼弱标注语音资源,显著提升了语音编码器的训练质量;并设计了可插拔序列压缩模块(Pluggable Sequence Compression Module),在不改变模型架构的前提下实现计算效率倍增,为低资源场景下高效、精准的泰语语音识别提供了新的路线。
EThai-ASR系统整合了精炼后的语音编码器与大语言模型(Thai LLM),在泰语ASR任务中实现了当前最优(SOTA) 的识别准确率。其核心贡献体现为三点:首先,提出的自演化数据精炼方法通过迭代机制动态修正Gigaspeech2和MSR-86k等数据集中的噪声标签,构建了高质量语料库(开源16K小时精炼标签),为训练鲁棒的Zipformer语音编码器奠定基础;其次,引入两阶段训练策略,先对齐语音与语义空间,再通过LoRA高效微调,构建了融合声学与深层语义信息的泰语ASR模型;设计灵活可插拔的序列压缩模块,该组件基于帧间余弦相似度动态移除冗余信息,支持训练、微调及推理三种工作模式,在保持性能损失低于5%的前提下,实现了1.5–2.1倍计算加速。在多个公开数据集上的实验验证了方法的普适性——既显著超越现有基线模型精度,又大幅降低计算门槛。研究成果已开源精炼数据集,为低资源语言ASR研究提供了新范式。
论文题目:Weakly Supervised Data Refinement and Flexible Sequence Compression for Efficient Thai LLM-based ASR
作者列表:邵明辰,朱新发,王成有,穆秉甡,李海,闫影,刘俊晖,谢丹铭,谢磊
合作单位:爱奇艺
论文原文:http://arxiv.org/abs/2505.22063
开源精炼数据标签:https://huggingface.co/datasets/mcshao/EThai-ASR
背景动机
近年来,LLM(大型语言模型)在文本理解与生成方面展现出卓越能力,逐步被引入到语音识别任务中,形成了“语音编码器 + LLM 解码器”的新范式[1]。对于高资源语言,如英语,其庞大的语料和算力支持使得 LLM 驱动的 ASR 系统已取得显著进展。然而,泰语等低资源语言却面临着双重瓶颈[2]:一方面,当前仅有 500 小时左右的开源标注数据[3],远低于英语等高资源语言[4];另一方面,LLM 本身巨大的计算开销让研究者难以承担上万甚至数十万 GPU 小时的训练和部署成本。因此尽管 LLM-Based ASR 思路前景广阔,但在泰语场景下难以真正落地应用。
为了解决该问题,我们提出了 EThai-ASR:一套针对低资源泰语场景的高效 LLM-Based ASR 解决方案。首先,针对弱标注数据噪声问题,我们设计了“自我演化数据精炼”策略,以有限的高质量标注和模型反馈迭代修正弱标签,最终生成超过 1.6 万小时的精炼转录文本;其次,在模型结构上,我们将增强后的 Zipformer 语音编码器与泰语 LLM 结合,并引入可插拔的“序列压缩”模块,通过帧间余弦相似度动态剔除冗余语音帧,大幅缩短 LLM 输入序列而不改动原架构,有效降低计算负担。EThai-ASR 在泰语多数据集上均达到了业界领先的识别精度与 1.5–2.1倍的训练推理加速效果,为低资源语言的 LLM-ASR 应用开辟了全新路径。
提出的方法
为了实现LLM-Based ASR,我们设计了如图1 所示的模型架构。使用预训练好的zipformer作为语音编码器提取语音特征,使用transformer adapter和linear层实现语音模态和文本模态的对齐,并且使用预训练泰语LLM作为解码器。为了解决高质量标注数据缺少的问题,我们设计了自我迭代的数据精炼策略。并且使用基于余弦相似度的可拔插序列压缩模块实现了训练和推理的加速。
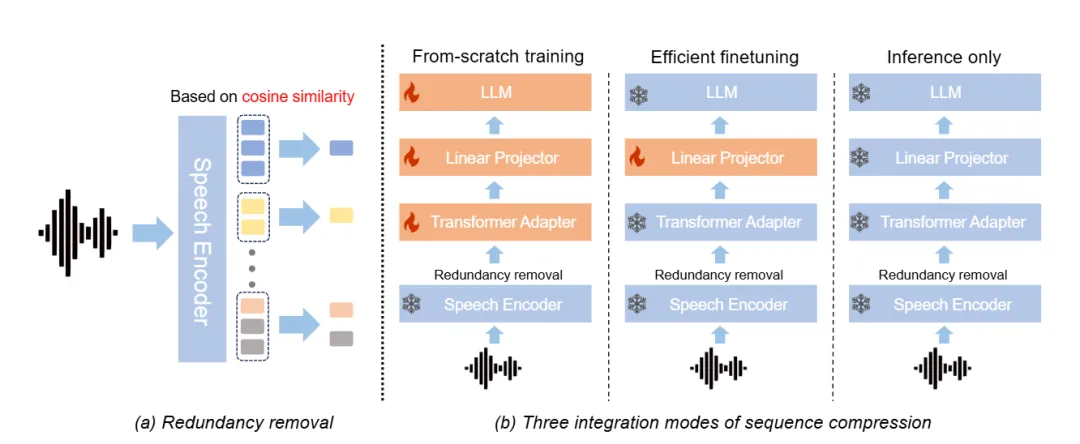
图1 我们提出的方法框架
自我迭代的数据精炼策略
我们提出了一种“自我演化数据精炼”策略(参见算法1),通过模型反馈迭代地提升弱标注质量。该流程首先构建混合数据集 D=Dp∪Dw,其中 Dp 是 500 小时的精标数据,Dw 是 16 000 小时的弱标注数据。第一步,用这个混合数据集对 Zipformer-gigaspeech2 [5, 6]模型进行微调;同时,我们以 Monsoon-whisper-medium-gigaspeech2(在 GigaSpeech2 上微调的 Whisper-medium 模型)作为锚点模型,用于后续的数据筛选。接着,用微调后的 Zipformer 对整个混合数据集重新打标,并将其输出与锚模型的标签计算编辑距离:若两者的距离低于预设阈值,则认为两模型对该样本标注一致,接受 Zipformer 的结果作为“精炼标签”;否则直接舍弃该样本。最后,将保留下来的样本及其更新后的标签继续用于训练 Zipformer,并循环上述过程直至完成三轮迭代。经过三轮自我演化精炼后,我们不仅获得了大规模高质量的泰语转录文本,还得到性能优于原始 Zipformer-gigaspeech2 的 Zipformer-iter3 模型。
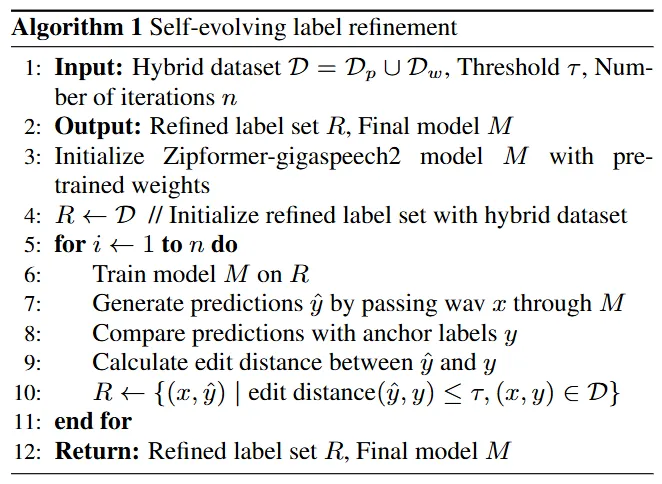
算法1 自迭代数据精炼策略
模型结构
为了提升泰语语音识别系统的性能,我们将 Zipformer-iter3 编码器与泰语大型语言模型(LLM)相结合。具体来说,通过一个四层 Transformer 适配器和一个线性投影器,将 Zipformer-iter3 提取的语音特征映射到 LLM 的语义空间 。这种融合既充分利用了 Zipformer-iter3 学到的先进语音表征,又借助泰语 LLM 所蕴含的上下文和语言知识。
此外,我们设计了两阶段训练策略:
阶段一:解冻 Transformer 适配器与线性投影器,仅训练这两部分,以对齐语音特征空间与 LLM 语义空间;
阶段二:在阶段一的基础上,进一步微调 LLM 的 LoRA 模块 ,以适配 ASR 任务并达到最佳识别效果。
可拔插序列压缩模块
在 LLM-Based ASR 系统中,编码器输出的帧序列中往往包含大量相似甚至重复的语音帧,这些冗余帧经由 LLM 处理时会带来巨大的计算开销。为了解决低资源场景下算力紧张的问题,我们设计了一款可插拔的序列压缩模块——它基于帧间余弦相似度动态剔除高度相似的帧[8],从而大幅缩短 LLM 的输入序列,显著降低内存占用与运算时间。该模块既可在训练阶段“从头训练”或“高效微调”时接入,也能在部署时“仅推理”时单独使用。
语音编码器输出的连续帧往往包含少量信息增量,许多帧对最终识别结果贡献甚微。我们的做法是:对每一对相邻帧计算余弦相似度。当相似度超过预设阈值 θ 时,判定后者为冗余帧并将其剔除,从而自适应地压缩序列长度。
作为一套可插拔的解决方案,该压缩模块支持三种灵活接入方式:
从头训练(From-Scratch Training)在训练初始模型时即启用压缩,剔除冗余帧后再送入 LLM,配合双阶段训练策略,可同时加速训练与推理并节省 GPU 显存。
高效微调(Efficient Finetuning)在已有预训练的LLM-Based ASR模型时,只需要在压缩后的输入序列上微调线性投影器(≈3M 可训练参数,以恢复因压缩导致的轻微对齐偏差),即可实现和从头训练模型相当的模型性能。此过程只需少量数据、30 分钟(8×3090 GPU),即可完成对接。
仅推理(Inference Only)部署阶段直接对编码器输出序列做压缩,再馈入已训练好的 LLM,无需任何参数更新,即可获得运行时加速。
通过上述设计,我们的可插拔序列压缩模块在保持>95% 识别精度的前提下,实现了1.5×–2.1×的训练与推理加速,为低资源 LLM-ASR 系统的高效落地提供了关键支撑。
实验结果
实验设置
我们的实验使用弱标签与精标签相结合的数据集。其中,弱标签数据包括 GigaSpeech2(13000小时)和 MSR-86K(3000小时),精标标签数据为 CommonVoice Thai(500 小时)。我们在三个测试集上评估模型性能:两个域内测试集(GigaSpeech2 Test、CommonVoice Thai Test)和一个域外测试集(FLEUR Test)。
对照方法包括四个基线模型:
Zipformer-gigaspeech2
Whisper-large-v2
Whisper-large-v3
Monsoon-whisper-medium-gigaspeech2
对于我们提出的 LLM 驱动的 ASR 系统,则将 Zipformer-iter3 编码器与泰语 LLM Typhoon2-Llama3.1-8B 和 Typhoon2-Llama3.2-3B[7] 相结合。
模型性能以字符错误率(CER, Character Error Rate)衡量识别准确度,以加速比(SR, Speedup Ratio)衡量推理加速效果,SR 值越大表示速度提升越显著。
数据迭代策略实验结果
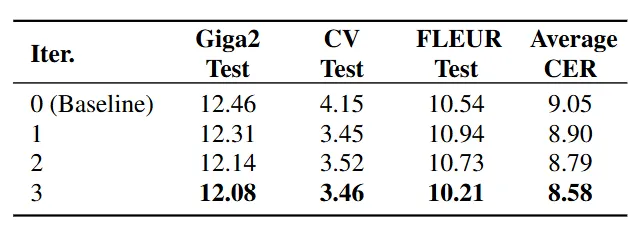
为了验证我们的数据精炼策略的有效性,我们测试了每一次迭代结束后zipformer模型的CER。在表1中可以发现,随着迭代的进行,模型效果取得了持续性的进步,证明我们的数据迭代策略可以在优化标签质量的同时提升模型性能。
表1 数据迭代策略下的模型性能
LLM-Based ASR实验结果
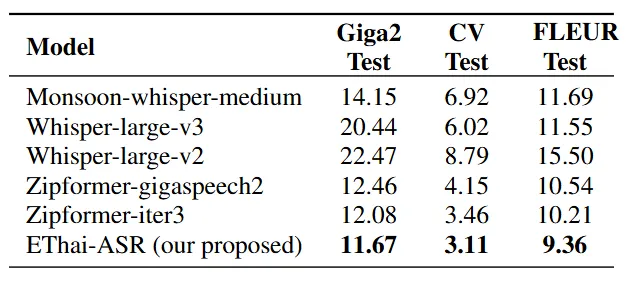
我们将数据精炼阶段得到的zipformer模型作为speech encoder,使用transformer adapter以及线性投影层将语音特征投影到LLM的语音空间。如表2所示,实验结果表明,我们的EThai-ASR系统在相关测试集上已经达到了泰语ASR当前的最佳效果。
表2 EThai-ASR系统性能评估
可拔插序列压缩实验结果
阈值-性能-加速比权衡我们考察余弦相似度阈值 θ\对加速比(SR)和 CER 保留率的影响。图 2 显示,当阈值降低时,剔除的冗余帧比例增大,加速比明显提升;但与此同时,CER 保留率也会下降。二者达到平衡的“最佳”阈值约为 0.887,在该点既能获得可观的加速效果,又能最大程度地保留识别精度。此结果表明,我们的方法可通过调节 θ 灵活控制压缩率,从而在加速和准确率之间找到理想折中。
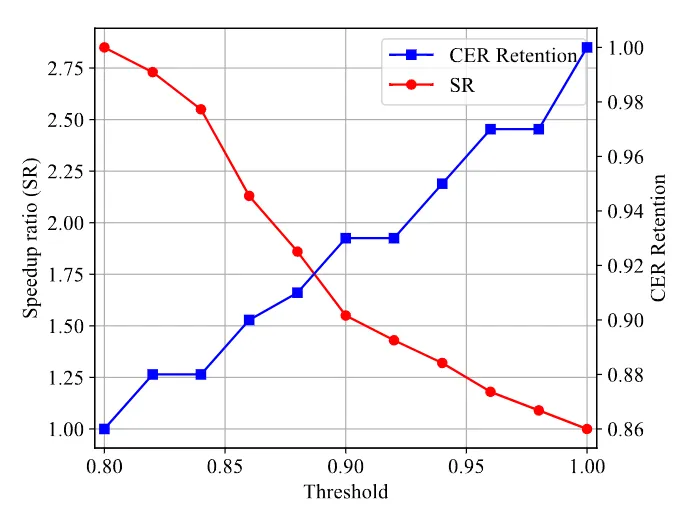
图2 阈值-性能-加速比
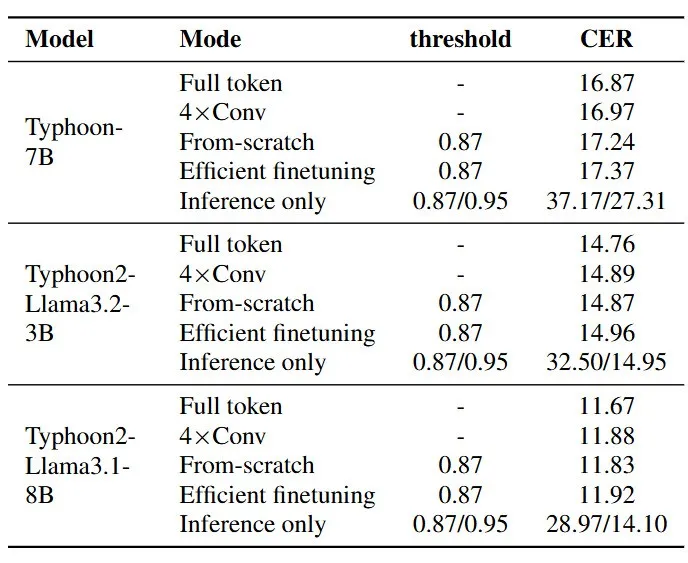
序列压缩方法的广泛有效性验证为了进一步验证压缩模块的通用性,我们在三种运行模式下,对三种不同 LLM backbone进行了测试。
在“从头训练”和“高效微调”中,我们将阈值设为 0.87,使压缩比约为 25%,以便与传统 4× 卷积下采样进行对比;
在“仅推理”模式中,将阈值提高到 0.95,使压缩比达到 50%。
如表 3 所示,无论是在 Typhoon2-Llama3.1-8B、Typhoon2-Llama3.2-3B 还是其他LLM backbone上,我们的方法在保留 ≥95% 性能的同时,与 4× 卷积下采样相比表现相当;且“高效微调”模式只需微调约 3M 参数,数据量和训练时间均明显少于从头训练,从而提供了一种轻量级、可插拔的解决方案。
表3 不同模型backbone下序列压缩效果
参考文献
[1] Chu, Yunfei and Xu, Jin and Yang, Qian and Wei, Haojie and Wei, Xipin and Guo, Zhifang and Leng, Yichong and Lv, Yuanjun and He, Jinzheng and Lin, Junyang and others, “Qwen2-audio technical report,” arXiv preprint arXiv:2407.10759, 2024.
[2] A. Seth, S. Ghosh, S. Umesh, and D. Manocha, “Stable Distilla-tion: Regularizing Continued Pre-Training for Low-Resource Automatic Speech Recognition,” in Proc. ICASSP, 2024, pp. 10 821–10 825.
[3] R. Ardila, M. Branson, K. Davis, M. Kohler, J. Meyer, M. Henretty, R. Morais, L. Saunders, F. M. Tyers, and G. Weber, “Common Voice: A Massively-Multilingual Speech Corpus,” in Proc.LREC, 2020, pp. 4218–4222.
[4] V. Panayotov, G. Chen, D. Povey, and S. Khudanpur, “Librispeech: An ASR corpus based on public domain audio books,”in Proc. ICASSP 2015, pp. 5206–5210.
[5] Y. Yang, Z. Song, J. Zhuo, M. Cui, J. Li, B. Yang, Y. Du, Z. Ma,X. Liu, Z. Wang et al., “GigaSpeech 2: An Evolving, Large-Scale and Multi-domain ASR Corpus for Low-Resource Languages with Automated Crawling, Transcription and Refinement,”arXiv preprint arXiv:2406.11546, 2024.
[6] S. Li, Y. You, X. Wang, Z. Tian, K. Ding, and G. Wan, “MSR-86K: An Evolving, Multilingual Corpus with 86,300 Hours of Transcribed Audio for Speech Recognition Research,” arXiv preprint arXiv:2406.18301, 2024.
[7] K. Pipatanakul, P. Manakul, N. Nitarach, W. Sirichotedumrong, S. Nonesung, T.Jaknamon, P. Pengpun, P. Taveekitworachai, A. Na-Thalang, S. Sripaisarnmongkol et al., “Typhoon 2: A Family of Open Text and Multimodal Thai Large Language Models,”arXiv preprint arXiv:2412.13702, 2024.
[8] S. Yang, Y. Chen, Z. Tian, C. Wang, J. Li, B. Yu, and J. Jia,“Visionzip: Longer is better but not necessary in vision language models,” arXiv preprint arXiv:2412.04467, 2024.
