
 语音小管家
分享上海交通大学 X-LANCE 跨媒体语言智能实验室6篇被interspeech2025录用论文。
01、LSCodec: Low-Bitrate and Speaker-Decoupled Discrete Speech Codec
论文作者:郭奕玮,李之涵,杜晨鹏,王翰坤,陈谐,俞凯
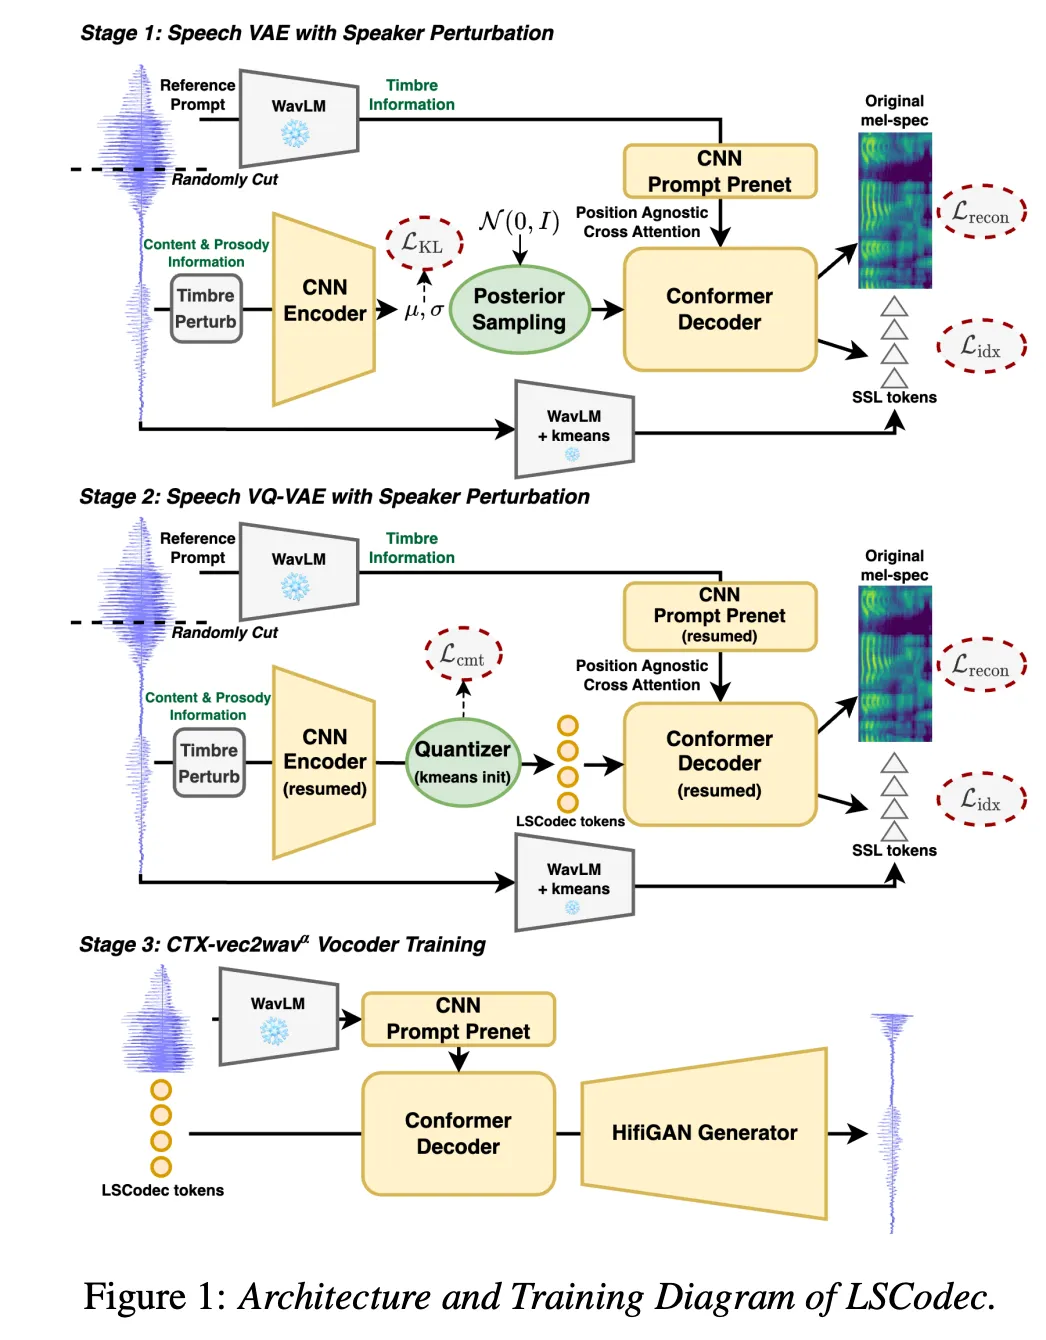
论文简介:尽管离散语音标记在基于语言模型的语音生成方面展现出强大潜力,但其高比特率和冗余的音色信息限制了此类模型的发展。在这项工作中,我们提出了LSCodec,一种兼具低比特率和说话人解耦能力的离散语音编解码器。LSCodec采用多阶段无监督训练框架并结合说话人扰动技术。首先建立一个连续信息瓶颈,然后通过向量量化生成一个离散的说话人解耦空间。最后,一个离散标记声码器从LSCodec中细化声学细节。通过重建评估,LSCodec在仅使用单个码本和比基线更小的词汇量的情况下,展现出卓越的可懂度和音频质量。语音转换和说话人探测实验证明了LSCodec出色的说话人解耦能力,消融研究验证了所提出训练框架的有效性。
完整论文:https://arxiv.org/abs/2410.15764
02、Accelerating Diffusion-based Text-to-Speech Model Training with Dual Modality Alignment
论文作者:Jeongsoo Choi∗, 牛志康∗, Ji-Hoon Kim, 王春惠, Joon Son Chung, 陈谐
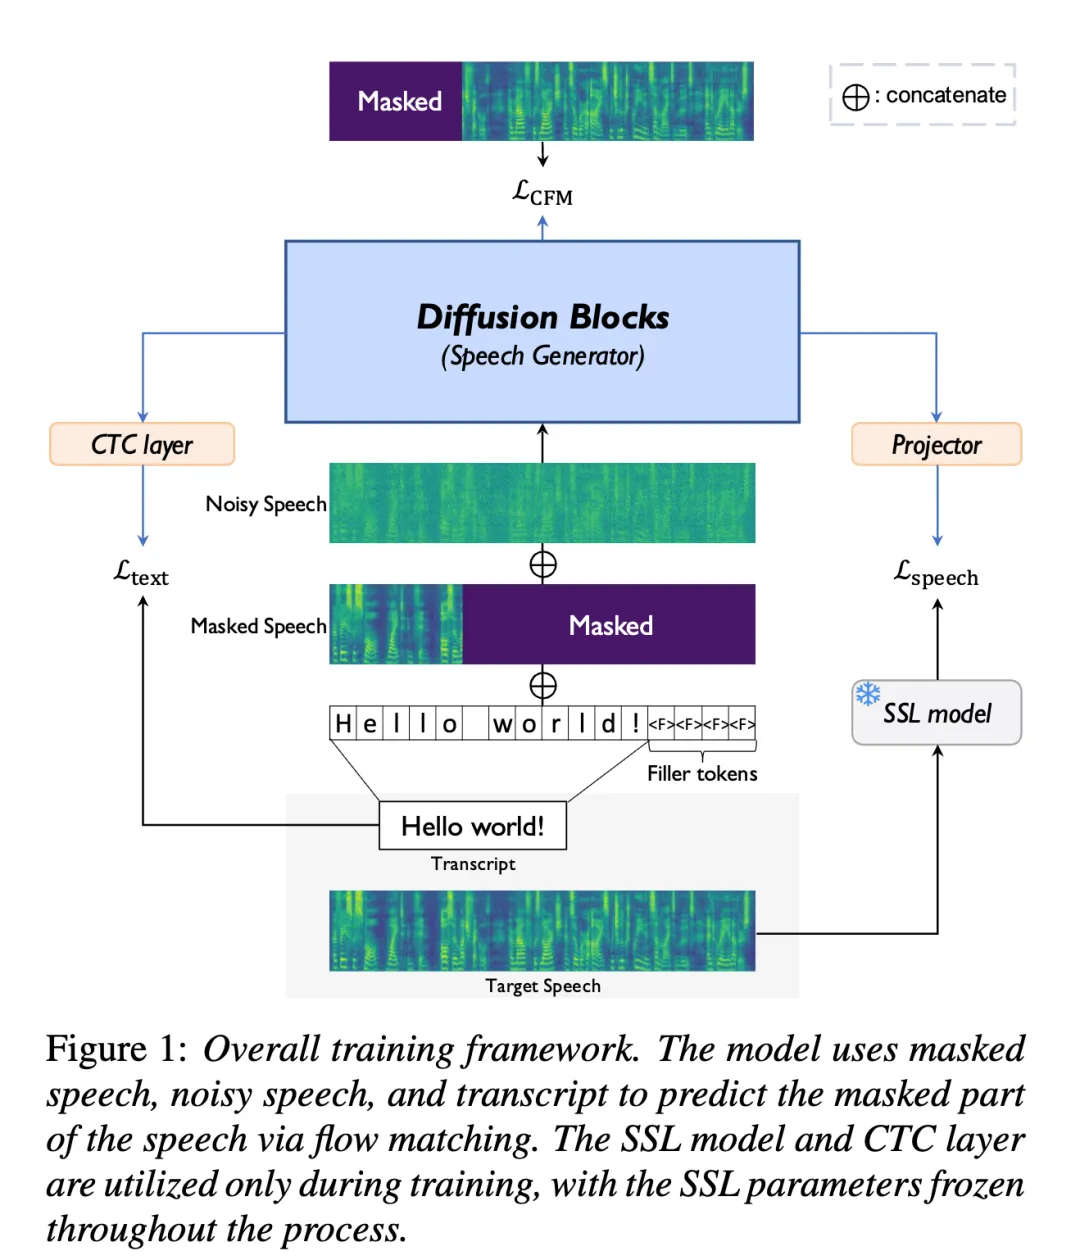
论文简介:本文的目标是优化基于扩散的语音合成模型(diffusion-based text-to-speech models)的训练过程。虽然近期研究取得了显著进展,但它们的训练需要大量时间和计算资源,这主要是由于扩散模型在学习复杂中间表示时的隐式引导所致。为了解决这一问题,我们提出了 A-DMA,一种通过 Accelerating training with Dual Modality Alignment 加速训练的有效策略。我们的方法引入了一个新颖的对齐流程,利用文本和语音双模态:text-guided alignment(结合上下文表示)和 speech-guided alignment(优化语义表示)。通过将隐藏状态与判别性特征进行对齐,我们的训练方案减少了对扩散模型学习复杂表示的依赖。大量实验表明,A-DMA 在收敛速度上提升了两倍,同时在性能上优于基线方法。
完整论文:https://arxiv.org/abs/2505.19595v1
项目仓库:https://github.com/ZhikangNiu/A-DMA
03、Dog2vec: Self-Supervised Pre-Training for Canine Vocal Representation
论文作者:李星源,朱其立,吴梦玥
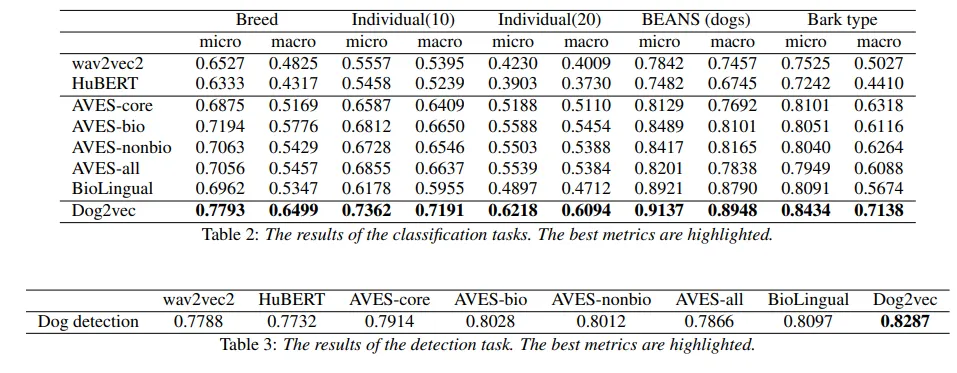
论文简介:先前的通用生物声学模型是在多个物种的大量数据上训练的。然而,平均而言,特定物种声音的训练数据非常少,而物种间发声的巨大差异甚至可能成为编码声音特征的障碍。这导致使用通用模型进行物种特异性发声研究时可能出现较大的错误。我们收集了超过6000小时的狗叫声视频,并提出了第一个动物特异性的生物声学嵌入模型,Dog2vec。结果表明,Dog2vec在一系列与狗相关的任务上优于不依赖于物种的预训练模型,实现了最先进的成果,包括狗叫声类型识别和狗声音事件检测,并获得了相对8.2%的性能提升。
04、VietASR: Achieving Industry-level Vietnamese ASR with 50-hour labeled data and Large-Scale Speech Pretraining
论文作者:卓建衡,杨亦凡,邵依文,徐勇,俞栋,俞凯,陈谐
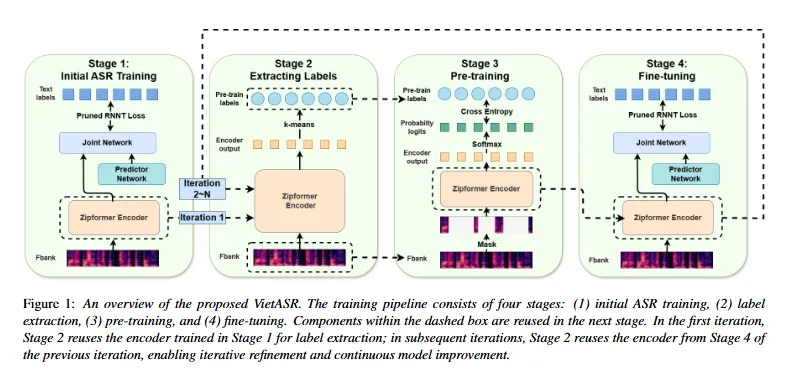
论文简介:自动语音识别(ASR)技术已取得显著进展,但仍高度依赖大规模标注数据,而这类数据在越南语等低资源语言中极为稀缺。尽管现有系统如 Whisper、USM 和 MMS 表现出一定潜力,但在训练成本、延迟与可用性方面仍存在不足。为应对上述挑战,本文提出了 VietASR —— 一种面向低资源语种的全新 ASR 训练流水线,结合大规模无标注语音数据与少量标注数据进行训练。该方法通过多轮带有语音识别偏置的自监督学习,有效提升模型性能并显著降低训练成本。实验表明,仅使用 70,000 小时无标注数据进行预训练,并在 50 小时标注数据上微调,即可获得轻量但高效的 ASR 模型,在真实语音数据上超越 Whisper Large-v3 及部分商用系统。为促进低资源语种的相关研究,本文所使用的代码与模型将公开发布。
05、Unlocking Temporal Flexibility: Neural Speech Codec with Variable Frame Rate
论文作者:张杭磊,郭奕玮,李之涵,郝翔,陈谐,俞凯
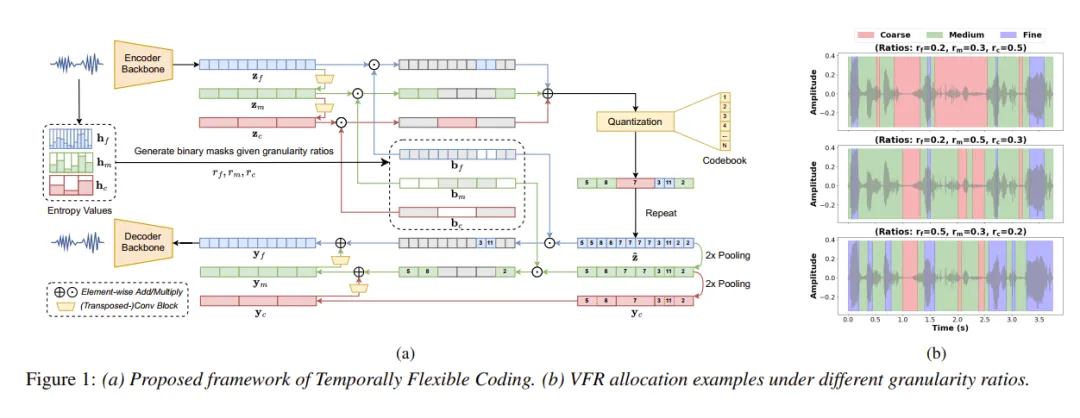
论文简介:大多数神经语音编解码器通过帧内机制(例如码本丢弃)在恒定帧率(CFR)下实现比特率调整。然而,语音段本身具有时变的信息密度(例如静音区间与有声段)。这一特性使得CFR在比特率和词元序列长度方面并非最优,影响了实时应用的效率。在本工作中,我们提出了一种时序灵活编码(Temporally Flexible Coding, TFC)技术,首次将可变帧率(VFR)引入神经语音编解码器。TFC支持无缝调整平均帧率,并基于时序熵动态分配帧率。实验结果表明,采用TFC的编解码器能以高度灵活性实现最优重建质量,并在较低帧率下保持竞争力。该方法有望与其他低帧率神经语音编解码技术结合,为下游任务提供更高效的解决方案。
完整论文:https://arxiv.org/abs/2505.16845
06、Accelerating Flow-Matching-Based Text-to-Speech via Empirically Pruned Step Sampling
论文作者:郑棋曦,陈禹伸,牛志康,马子阳,王晓飞,俞凯,陈谐
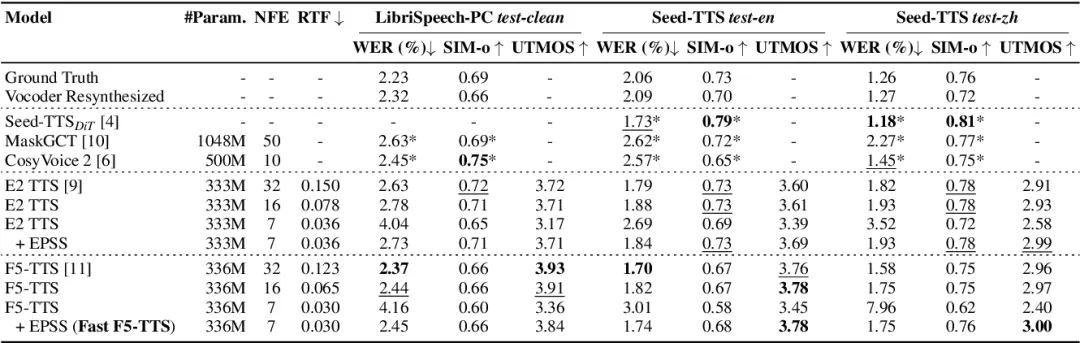
论文简介:近年来,如F5-TTS等基于流匹配的文本到语音模型引起了广泛关注。这类模型需要通过多步采样从噪声中重构语音,因此模型的推理速度成为一项关键挑战。减少采样步数可显著提升推理效率。为此,我们提出 Fast F5-TTS,这是一种无需训练的加速方法,用于优化基于流匹配的文本转语音模型推理。通过分析 F5-TTS 的采样轨迹,我们识别出冗余步骤,并提出经验性剪枝步骤采样(EPSS)。EPSS是一种非均匀的时间步采样策略,可以有效减少采样步数。我们的方法在推理时仅需7 步采样,推理实时因子低至0.030,相比原始 F5-TTS 提速4倍,同时保持了相当的生成质量。此外,EPSS 在 E2 TTS 模型上同样表现优异,证明了其强大的泛化能力。
