
 语音小管家
近期,浙江大学联合阿里巴巴通义实验室发表了一篇题为“WavReward: Spoken Dialogue Models With Generalist Reward Evaluators”的论文。该论文提出了一种基于音频理解大模型Qwen2.5-Omni-Think的奖励模型WavReward和一个用于训练WavReward的偏好数据集ChatReward-30K。
WavReward提出了这样的一条技术路线:音频理解大模型(speech-to-text)模型经过精标偏好数据集进行强化学习可以成为端到端对话模型(speech-to-speech)的评价器。与此同时, WavReward可以在文本和语音层面同时评估端到端语音对话模型的智商和情商,并且在多个真实和模拟的人机对话评估场景中表现优于先进的评估模型。在文本能力,多种副语言信息instruct能力,隐式对话能力的多个维度评估上, WavReward在评估准确率方面实现了明显的提升。
论文:WavReward: Spoken Dialogue Models With Generalist Reward Evaluators
论文地址:
Github:
背景动机:端到端对话模型数量激增,但是语音奖励评估模型仍然处于起步阶段
随着GPT-4o-audio、moshi、Qwen-Omni等端到端语音对话系统的兴起,机器已经能“听懂”并“说出”更真实、自然的语音内容。
但评估这些对话系统的能力,尤其是它们是否真的“听懂了”用户的情绪、语调和语境,并且“说出的”声音是否自然且符合语境,却仍主要依赖转写为文本后用文本语言模型(例如ChatGPT)或直接用不具有定向评价功能的多模态模型(例如GPT-4o)做评估。与此同时,适配端到端对话模型的强化学习算法需要一个能够在语音层面进行反馈的奖励信号,但是语音层面的奖励模型研究仍然处于早期阶段。
之前针对端到端对话模型的评估模型/奖励信号存在以下三个方面显著局限性:
1.缺乏端到端语音模态(统一理解和生成)的评估:目前多数语音对话模型评估仍然直接基于文本模态,关注在对话场景下文本回复质量的高低。虽然有一些Benchmark例如VoxDialogue、SD-Eval等尝试评测对话模型“听懂声音”(如理解语速、语调、情绪等副语言信息)的能力,但是依赖ASR转写后的文本评估,无法直接评估端到端模型在语音生成阶段的副语言行为是否匹配用户意图或上下文情绪。我们需要一个能够给对话中的语音信号给予奖励的模型。
2.缺乏隐式场景的多维评分机制:实际人机交互中,大量信息并不通过语言明确表达,而是通过语音语调、说话方式传达意图。评测这些回复的对话并没有一个固定的标准,日常闲聊的对话并不都是instruct类型的,比如模型用高兴的声音回复或者用温柔的声音回复都是正确的。我们需要将这种针对隐式(非instruct)对话的多维评分标准和人类的主观偏好标准进一步对齐。
3.缺乏语音领域的奖励模型:大部分的语音对话中的奖励信号直接由一些SOTA的多模态模型例如GPT-4o给出,但是这类通用模型并不是天然适配给出奖励,我们需要额外训练出在语音领域可以给出更精准奖励的模型。
WavReward正是在这一背景下诞生,它是首个专为语音对话模型设计的奖励评估器,能直接“听”用户与模型在各种场景下的对话音频,在语音层面评估其回复的文本质量和语音质量。同时我们引入了ChatReward-30K,一个用于训练WavReward的偏好数据集,包括语音对话模型的理解和生成两个方面。WavReward实现了在语音对话中直接针对输出语音的副语言特征进行细致的奖励和反馈,为端到端对话模型提供了精准反馈信号,使得后续模型训练能够有针对性地优化表达风格与人机交互的自然度。
实现细节:WavReward的核心设计和ChatReward-30K的涵盖内容
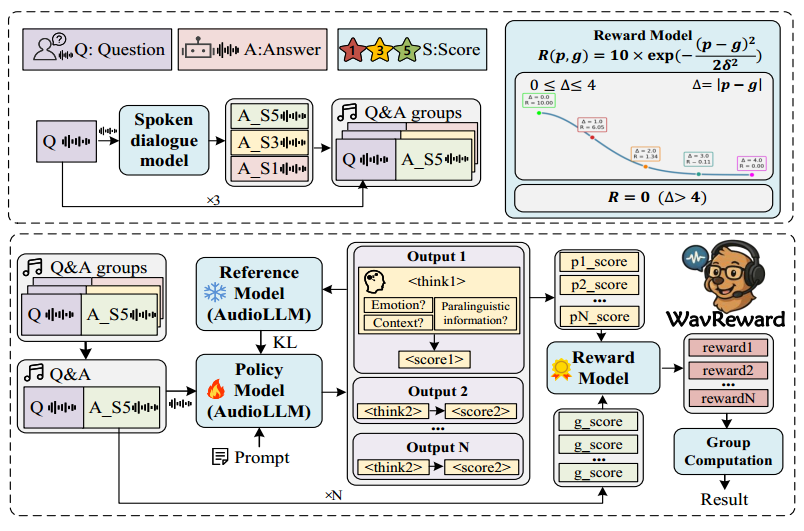
图1 WavReward的整体框架
WavRewar的核心设计是将音频理解大模型(Speech-To-Text models)通过强化学习改造成端到端对话模型的奖励模型。因为WavReward需要支持语音模态作为输入,但是输出端仅仅需要文本奖励即可,因此我们选用了开源的Qwen2.5-Omni-Think模型作为我们的backbone。除次之外,不同于文本领域的奖励模型,语音对话的奖励模型需要同时从文本和副语言多角度反馈复杂的奖励信号,因此我们额外设计了多样本采样机制,思维链推理和非线性奖励函数等多重机制进一步提升WavReward的性能。我们构造了一个用于训练WavReward的偏好数据集—ChatReward-30K。该数据集跨越多种任务,涵盖文本聊天,九种声学属性的指令聊天和隐式聊天等,相关具体细节如下所示。
1.多样本反馈机制,充分比较赋分差距
在传统基于GRPO的强化学习算法中,通常基于单个QA样本进行Group采样和提供反馈。但在真实的语音对话中,输入和输出都包含丰富的内容和复杂的声学信息,单样本QA反馈不足以使奖励模型有效地比较各个级别的差异。因此WavReward设计了多样本反馈机制:对于每个对话场景,我们为给定的问题q构建不同等级的多个答案-分数对{aj,sj}。第一个等级s1表示被认为不合理的答案内容并获得最低分数。第二个等级s2评估声学失配。只有当内容和声学信息都正确时,对话才会达到最高等级s3。
2.改进的奖励机制:深度思考和非线性准确度奖励
在传统奖励模型使用KL-散度约束参考策略模型和训练策略模型的基础上,WavReward进一步加入深度思考格式奖励计算(返回5或0),结合深度推理过程,隐含地使WavReward能够分析语音对话模型的回答是否从内容和声学角度有效地解决输入问题,进一步思考为什么这么打分并且标注最终得分。
然后,WavReward通过使用准确度奖励将N个候选分数与真实分数进行比较,计算N个候选输出的候选奖励。考虑语音对话中的声学信息与内容信息之间的差异,我们设计了非线性准确性奖励。当候选分数和基础分数之间的差增加时,奖励呈指数下降,鼓励WavReward向表现出认知智商和情商的语音对话模型提供更高准确度的奖励。
3. ChatReward-30K,一个包含分数的端到端对话数据集
ChatReward-30K数据集是用来训练语音对话奖励模型的数据集。ChatReward-30K由30000+份样本组成,每个对话样本以语音对的形式模拟用户-聊天机器人交互,并由人类专家在1到5的范围内评分,每段对话音频的持续时间从5秒到35秒不等。
ChatReward-30K数据集在以下领域展示了全面覆盖
内容和声学维度:除了文本信息外,ChatReward-30K涵盖广泛的副语言数据,包括性别、年龄、语言、口音、音高、速度、音量、能量、情感和音频事件。
理解端和生成端:之前的数据集如Voxdialogue和SD-Eval主要关注理解部分。相比之下,ChatReward-30K数据集进一步包含了生成部分的数据,提供评估对话模型如何遵循指令,生成特定音调语音的场景。
端到端隐式对话:ChatReward-30K包括各种场景中的隐式对话数据。例如,当用户由于老板的批评而哭泣时,模型能够自动以一种缓慢的语速和同情的语气表达安慰。
包含正面场景和负面场景对比:为了更好地训练WavReward模型,ChatReward-30K针对相同的用户场景提供了不同的对话响应,提供正面和负面的示例,以更有效地促进模型训练。
人工专家评分:ChatReward-30K中的每个对话场景都附有人工专家评分,确保奖励的GT评分能够和人类主观偏好相一致。
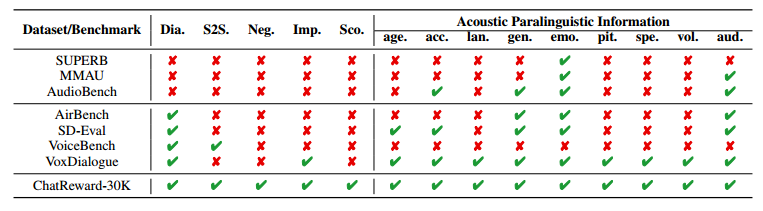
表1语音对话模型的不同评估数据集/基准的比较
实验验证:WavReward的卓越性能
为了验证WavReward在语音对话模型评估领域的实际效果,我们在ChatReward-30K-test(4000份样本)和RealDialogue数据集(一个out domain的真实人机对话数据)进行了广泛的实验,涵盖了评估分数准确率验证,A/B测试和消融研究。结果显示,WavReward在评估结果准确率指标上明显优于现有的最先进模型,展现了其卓越的上下文分析能力和杰出的评测能力。为了比较不同评估器在更真实的环境中的性能,我们记录了用户与LLaMA-Omni(总体有偏见的负样本)和Kimi-Audio(总体有偏见的正样本)之间的120次真实人机对话,构成RealDialogue数据集。其主要用于评估模型在真实世界场景中的性能。
ChatReward-30K-test的准确率验证实验具体分为以下两类:一种是使用与WavReward一致的文本提示模板让音频理解大模型直接进行推理,另一种是使用经过ChatReward-30K数据集监督微调后的评估器进行推理。相关实验结果如表二所示,我们得出下述结论:
WavReward在所有指标上都明显优于最好的音频语言模型GPT-4o-audio。它在内容评分、隐式对话评分和情感指令对话评分方面分别获得了21.4、20.7和39.0分的提升。此外,它比直接使用Qwen2.5-Omni模型推理的平均性能高出两倍。这表明,使用强化学习优化的音频理解大模型可以有效地充当语音对话模型的评估器。
基于RL的WavReward超过了LoRA微调的Qwen2.5-Omni,说明WavReward整体技术路线的准确性。另外,基于LoRA的方法优于全参数微调,这可能是因为全参数微调缺乏对初始模型的KL损失约束,导致模型偏离其固有能力,对训练参数会较为敏感。
我们观察到在直接推理设置下不同音频理解大模型之间存在着显著性能差距,这强调了未来开发和开源更强大的基础音频语言模型的必要性。
我们发现WavReward在口音指令和隐式对话方面的准确性低于其他场景,这在未来值得进一步优化。
在RealDialogue数据集上,WavReward的评分准确率达到了80%,显示出强大的鲁棒性,WavReward可以在真实世界的复杂场景中提供可靠的评估。
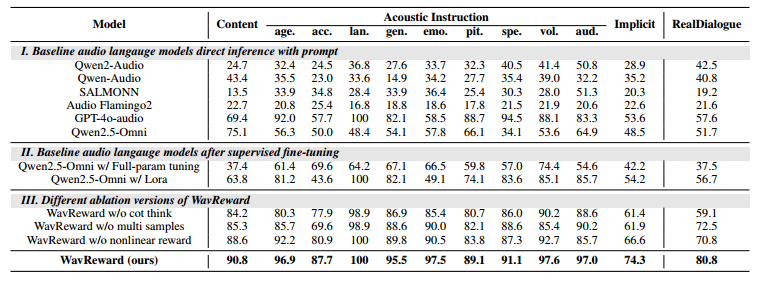
表2 WavReward和Baseline在ChatReward测试集和RealDialogue数据集上的评分准确性对比
在基于RealDialogue数据集的A/B测试中,五位人类专家被指派评估基于RealDialogue的数据,并确定两个不同的评估器中的哪一个提供了更合理的评估,专家们也被要求为他们的选择提供理由。结果显示,WavReward在主观A/B测试中的表现优于Qwen2.5-Omni w/direct inference,提高幅度为83%,并且与GPT-4o-audio w/direct inference相比时,也实现了77%的成功率。这些结果表明,WavReward的评分与人类的主观偏好更加一致,在广泛的现实场景的人机对话中可以给出精准的奖励反馈。
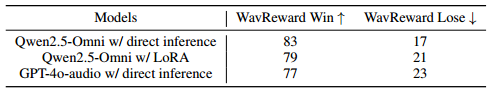
表3在A/B测试中WavReward性能优化详情
为了深入研究WavReward中创新模块的贡献,我们还进行了消融实验,分别验证了思想链(CoT)推理,非线性奖励机制和多样本反馈机制的作用。实验结果表明,CoT推理在所有评估类别中提高了大约10%的准确性。在真实场景中,提高高达21.7%;非线性奖励函数帮助WavReward学习语音中不同等级间的信息差异;多样本反馈机制提供了对同一问题模拟一系列合理和不合理回答的能力,有助于WavReward区分不同的评分标准及其变化。
通过这些实验,WavReward展现出在语音对话评估任务中的强大评测能力和稳定性,证明了其在上下文理解、情感识别和多维对话评分方面的全面优势。在多个真实和模拟场景下,WavReward显著优于现有的语音对话模型和微调评估器,具备更高的评分准确率和更强的一致性,与人类偏好高度契合。这些结果不仅为语音对话系统的自动化评估提供了更可靠的工具,也为未来多模态大模型在真实语音场景中的评估与优化开辟了高效、可行的新路径。
总 结
在本文中,我们提出了一个直接基于语音模态,在文本和声学场景下,可以对语音对话模型的结果直接进行奖励反馈的奖励模型WavReward。WavReward利用强化学习将音频理解大模型模型转化为奖励模型,并结合思维链推理,非线性奖励和正负样本反馈,来增强奖励信号的有效性。在各种模拟和真实的显式和隐式评估场景中,WavReward的性能显著优于以往最先进的评估器。
此外,在人类主观A/B测试中,它以83%的改进展示出与人类主观偏好的一致性。未来,我们的目标之一是进一步scaling奖励模型的参数量(例如,7B-70B),进一步增强WavReward的能力。
