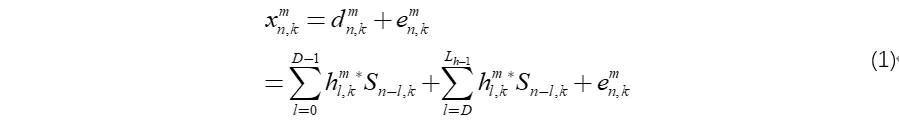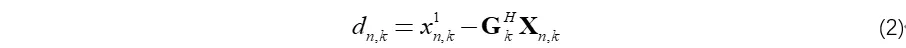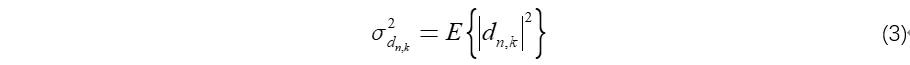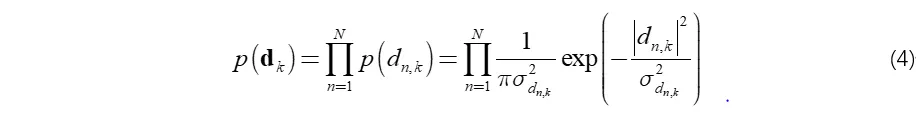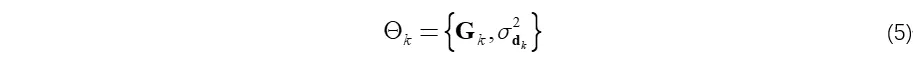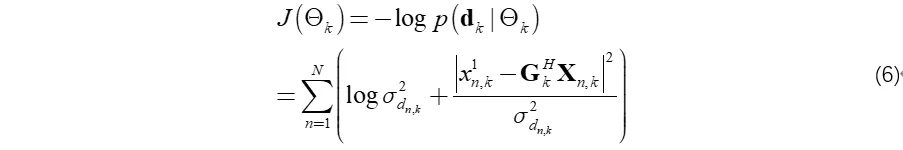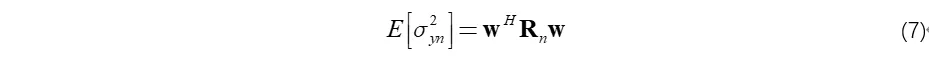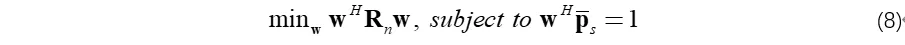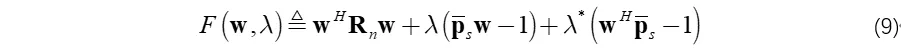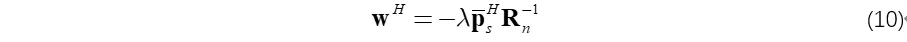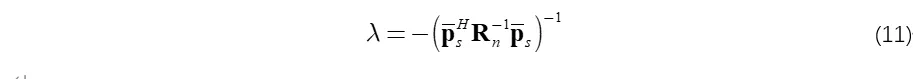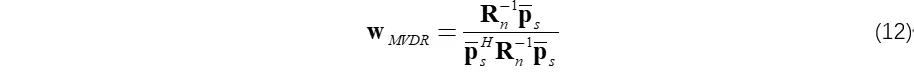嘈杂环境下的语音识别一直是该领域的一个较为困难的问题,虽然降噪算法可以提升语音质量,但是降噪后的语音对于语音识别的提升并不明显,甚至有可能起到相反的作用。因此在语音识别领域,更多的研究关注在如何让声学模型具有更好的噪声鲁棒性,比如在训练过程中加入噪声数据;或者将噪声标注为特殊的token,让模型学习音频数据中是否含有语音;再者将语音增强和语音识别联合优化,解决降噪和识别的数据差异。简单分析下语音前端算法对识别的影响,大多数语音前端算法都是基于时频域的操作,即对傅里叶变换后的频点级别进行处理,而在语音识别中的数据增强没有也不好去做这么细粒度的增强方案。再者,语音增强的评价指标更多的关注语音是否清晰可懂,比如SISNR,STOI等,这是以人为对象建立的指标,因此经过增加后的语音可能会发生以语音失真为代价进行噪声抑制的情况,这种失真导致与训练数据失配,从而噪声语音识别准确率下降。因此如果可以在保证语音不失真的情况下,提升信噪比,这样就可以提升语音识别的准确率了。下面,我们就介绍下满足上述条件的两种麦克风阵列算法。
🌒Weighted Prediction Error
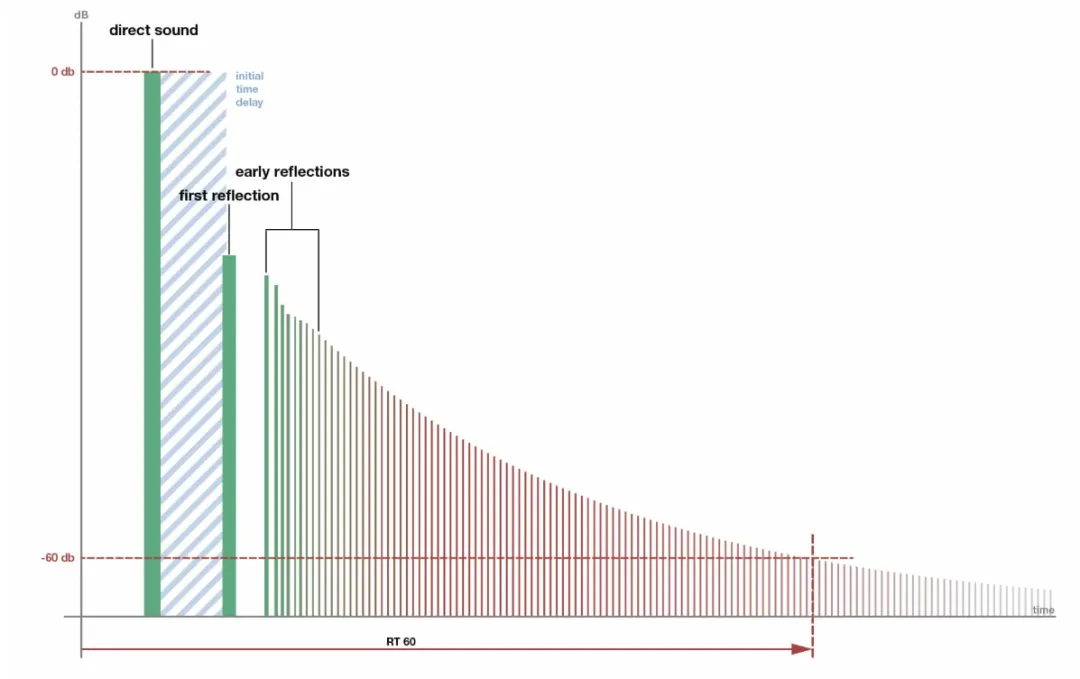
混响是声音在传播过程中,被房间墙壁、地板、天花板等反射形成的一种多路径效应。相对于清晰的直接声,混响会导致语音信号直达声与晚期混响叠加在一起,从而导致声学模型更难对齐帧与音素,引起识别率降低。加权预测误差算法(Weighted Prediction Error,WPE)是一种经典且有效的多通道去混响算法,广泛用于语音增强与远场语音识别中。一般认为信号靠近声源的部分为空间冲击响应(RIR room impulse response),是有益的信号,而尾部的信号干扰ASR,需要被消除。WPE的主要思路是首先估计信号的混响尾部,然后再从观测信号中减去混响尾部,得到对弱混响信号的极大似然意义下的最优估计。第m个麦克风,第n帧第k个频点的信号可以表示为其中h是声学传递函数,第一项是直达信号和早期反射信号,第二项是晚期混响,第三项是线性预测误差和加性噪声,为了方便公式推导,后续忽略这一项。将式(1)中的卷积模型替换为自回归(AR)模型,可以得到第一个麦克风观测信号的多通道线性预测(MCLP)形式,期望信号可以表示为其中G是混响预测权重,在WPE算法中,假设语音信号是时变高斯模型(time-varying Gaussian model,TVG),其均值为0,方差为并且假设dn,k在不同帧之间是相互独立的,那么频率k处所有帧的期望语音系数的联合分布为将每个频率点的这组未知参数表示为
在混响信号中,晚期混响是不含有用信息的,WPE将其从混响信号中减去,在提升信噪比的同时,一定程度上保证了语音信号本身的不失真,从而可以提升语音识别的准确率。🎴Minimum Variance Distortion-less Response如果说WPE可能会存在混响信号估计不准确导致语音失真,那么最小方差无失真响应(Minimum Variance Distortion-less Response, MVDR)则在理论层面保证了信号不失真。该方法的原理就是让其感兴趣方位的信号无失真的输出,而使波束输出噪声方差最小。假设波束输出噪声方差为在实际应用中,协方差矩阵的求逆是一个计算复杂度较高的操作,尤其当传感器数量较大时。此外,样本协方差矩阵的估计精度受到快拍数的影响,有限的快拍数会导致估计误差,从而影响MVDR的性能。
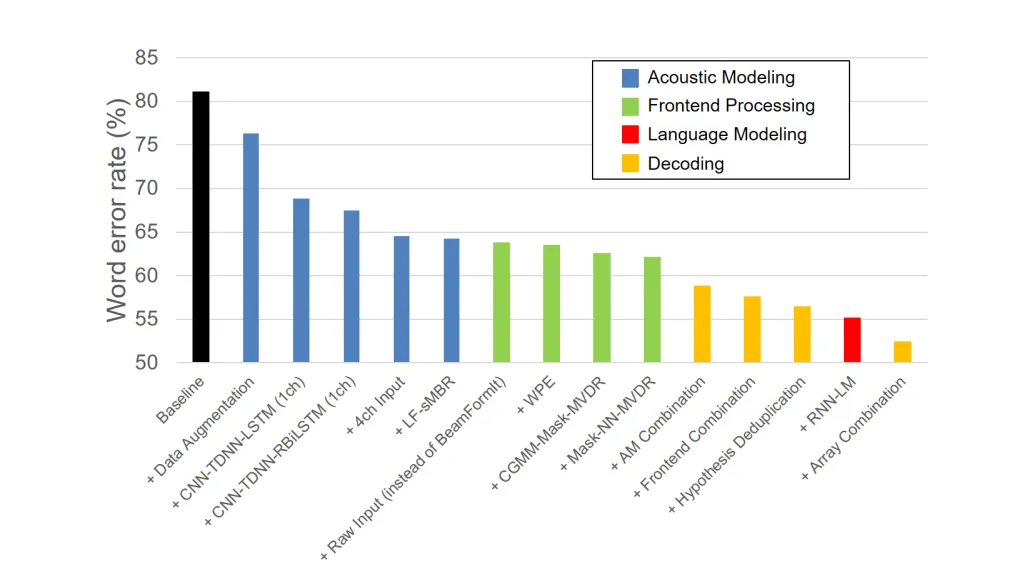
最后,看下上述两种算法在实际数据上的应用。在CHiME-5比赛中,WPE和MVDR的加入均可以降低语音识别的WER。进一步比较两种前端算法,WPE略微降低了一些WER,MVDR则是降低了大概1.5%,其中使用神经网络估计Mask的方法要优于使用复高斯混合模型的方法。
参考文献:
[1].https://zhuanlan.zhihu.com/p/1899445506083631765
[2].https://www.chimechallenge.org/workshops/chime2018/papers/CHiME_2018_paper_kanda.pdf
[3].https://blog.csdn.net/veritasalice/article/details/107417996
[4].https://groups.uni-paderborn.de/nt/pubs/2018/ITG_2018_Drude_Paper.pdf
[5].https://www.dreams-itn.eu/uploads/files/c03_jukic_2014_icassp.pdf

 语音小管家