
 语音小管家
流式语音识别(streaming ASR)因其低延迟、高效率的特点,适用在诸多“快速出字”的应用中。当前主流的端到端模型包括 CTC、RNN-T 和基于注意力的编码器-解码器(AED)。其中 CTC 凭借结构简单,在流式场景中被广泛采用。为实现流式识别,通常使用基于 chunk 的方法对编码器进行掩码。然而,CTC 在流式识别中仍面临两大挑战:一是小 chunk 条件下由于上下文不足导致识别准确率下降,二是非 blank 字符存在发射延迟,CTC 的尖峰往往比非流式模型滞后,影响实时体验。
西工大音频语音与语言处理研究组(ASLP@NPU)近期与华为云合作论文 “Delayed-KD: Delayed Knowledge Distillation based CTC for Low-Latency Streaming ASR” 被语音研究顶级会议 Interspeech2025 接收。针对上述问题,该论文提出了一种基于 CTC 的延迟蒸馏方案,引入时序对齐缓冲区(TAB),有效对齐了流式模型和非流式模型的发射延迟。现对该论文进行简要的解读和分享。
论文题目:Delayed-KD: Delayed Knowledge Distillation based CTC for Low-Latency Streaming ASR
作者列表:李龙豪、李泱泽、薛鸿飞、刘杰、方帅、王凯、谢磊
合作单位:华为云
论文原文:https://arxiv.org/abs/2505.22069
背景动机
基于 CTC 的流式 ASR 模型在“快速出字”的业务场景下被广泛使用,但面临两大核心挑战:一是小分块(chunk)场景下因上下文受限导致的准确率下降 [1],二是非空白令牌(token)的发射延迟问题 [2]。针对前者,现有方案如 Fast-U2++ [3] 采用分层分块策略,USIDE-T [4] 通过历史帧模拟网络补偿信息损失,但在极小 chunk 条件下识别性能仍受限;针对后者,FastEmit [5]、Peak-first CTC [6] 等技术虽能有效减少 CTC 峰值滞后,但它们仍然存在显著的模型延迟。知识蒸馏技术虽被证明能缩小流式与非流式模型差距,但传统逐帧蒸馏受限于 CTC 的发射延迟特性,而现有基于强制对齐的蒸馏方法又忽视了流式与非流式模型间的信息差异。
针对以上问题,我们提出了一种延迟知识蒸馏方法(Delayed-KD),该方法在非流式教师模型与流式学生模型之间进行 CTC 后验概率的延迟蒸馏。具体而言,在极小的 chunk 条件下,我们引入时序对齐缓冲区(TAB)——通过设定相对于非流式教师模型的相对延迟范围,有效对齐了 CTC 输出,并缓解了非空白令牌的误匹配问题。此外,TAB 还能实现对令牌发射延迟的细粒度控制。在 178 小时的 AISHELL-1 [7] 和 1 万小时的WenetSpeech [8] 普通话数据集上的实验表明,Delayed-KD 始终具有优越性。令人印象深刻的是,在仅 40 毫秒延迟的设定下,Delayed-KD 在 AISHELL-1 数据集上实现了 5.42% 的字符错误率(CER),与在 320 毫秒延迟下运行的强基线模型 U2++ 性能相当。
提出方法
如图 1 所示,我们提出的模型架构包含三大核心组件:(1)非流式教师模型的CTC分支;(2)流式学生模型的CTC分支;(3)流式学生模型的注意力分支。值得注意的是,教师模型与学生模型的CTC分支采用完全相同的结构设计,均包含:用于声学特征上下文建模的共享编码器(Shared Encoder)以及实现帧与标记对齐的CTC解码器(CTC Decoder)。而学生模型特有的注意力分支则额外配置了注意力解码器(Attention Decoder),专门用于建模标记间的依赖关系。
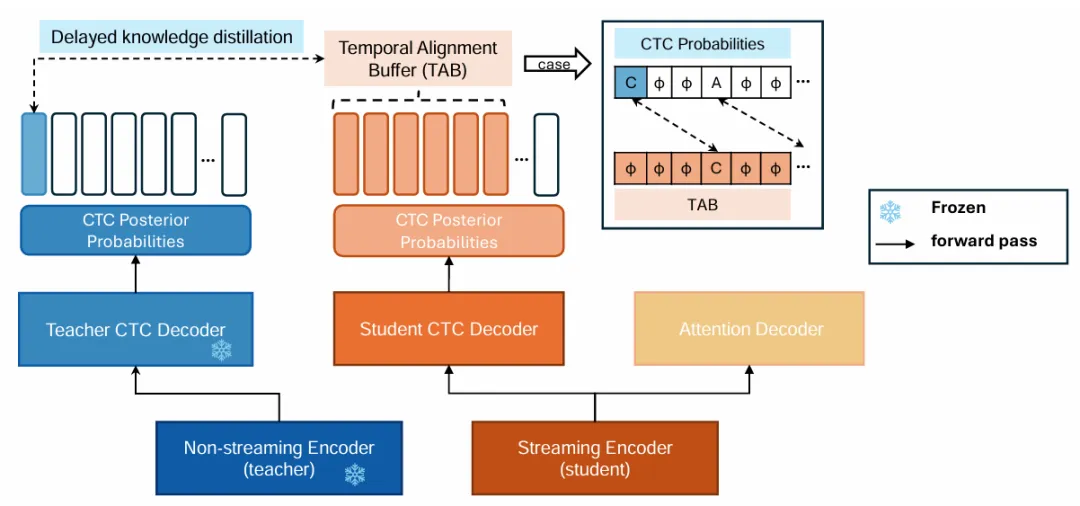
图 1 Delayed-KD 模型结构
延迟知识蒸馏
我们提出的方法首先将语音的 FBank 特征分别输入非流式教师模型和流式学生模型的编码器,生成两种不同的帧级 CTC 后验概率分布:前者具有全局上下文信息,后者仅包含左侧上下文信息。在蒸馏过程中采用 KL 散度作为度量指标,并创新性地引入时序对齐缓冲器(TAB)来缓解流式模型的 CTC 峰值延迟问题。具体实现中,训练时采用极小的分块尺寸,TAB 通过预设的延迟范围动态调整对齐位置,在该范围内选择 KL 散度损失最小的分块进行蒸馏。这种机制通过将教师模型的 CTC 输出与学生模型右移若干分块后的延迟输出对齐,有效解决了非空白符标记在蒸馏过程中的错位问题,从而显著提升了蒸馏效果。
基于上述过程,我们将延迟知识蒸馏损失定义如下:
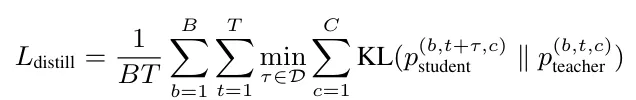
式中,B 为批大小,T 为时间步数,C 为词汇表大小,D 为延迟知识蒸馏的窗口范围(对应 TAB 机制)。具体而言,D = {0, 1, 2, ..., d} 定义了师生模型输出对齐的允许延迟范围,其中 d 由 TAB 缓冲区大小决定的最大延迟量。
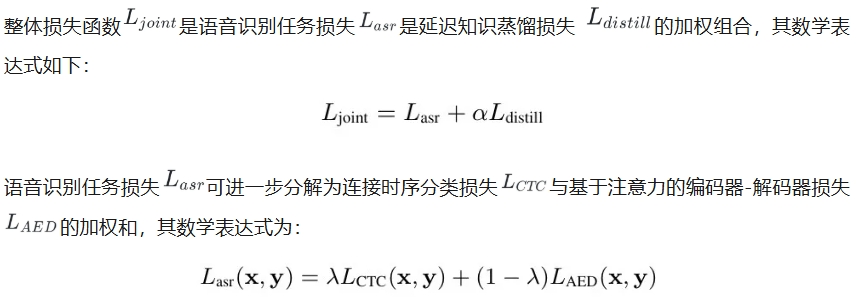
联合训练
实验结果
实验数据
我们在两个中文普通话数据集上进行了实验验证:
AISHELL-1(178小时语料)[7]:测试集包含7,176条语音样本
多领域大规模WenetSpeech(10,000小时语料)[8]:提供两个测试集,合计约33,100条测试样本
会议场景测试集(Test_Meeting)
网络语音测试集(Test_Net)
评估指标
CER(字错误率):计算字符级别的识别错误率,包括替换(Substitution)、删除(Deletion)和插入(Insertion)错误
Latency:衡量模型的延迟
核心延迟指标:
首字符延迟(FTD):单条语音中首个标记的发射延迟
尾字符延迟(LTD):单条语音中末个标记的发射延迟
AISHELL-1 结果
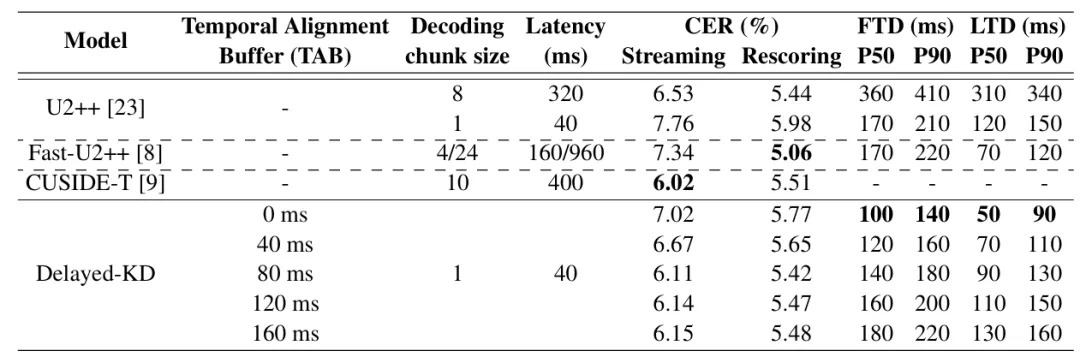
从表 1 可以看出,我们提出的 Delayed-KD 方法相较于 U2++ [9] 实现了 8 倍的延迟降低,从 320 ms 到 80 ms;相较于 Fast-U2++ 和 CUSIDE-T 等先进的流式方法,在低延迟条件下的优势明显;同时 TAB 的大小能够有效的对延迟和识别准确率之间进行平衡。
表 1 AISHELL-1 结果
WenetSpeech 结果
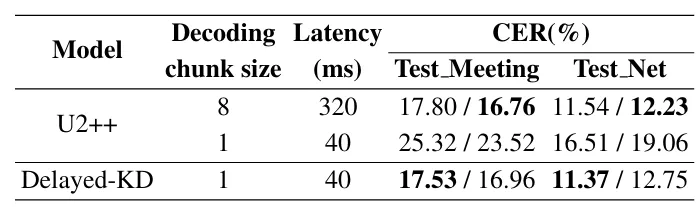
我们进一步在大规模 WenetSpeech 数据集上对 Delayed-KD 与 U2++ 进行了对比评估,在 WenetSpeech 的Test_Meeting 和 Test_Net 测试集上进行了实验验证。如表 2 所示,实验结果与 AISHELL-1 的结论一致:Delayed-KD 在 40 ms 延迟条件下的性能表现接近 U2++ 在 320ms 延迟时的结果,且在相同延迟条件下显著优于U2++。
表 2 WenetSpeech 结果
参考文献
[1] H. Tang et al., “Reducing the gap between streaming and non-streaming transducer-based ASR by adaptive two-stage knowledge distillation,”Proc. ICASSP, IEEE, 2023, pp. 1–5.
[2] S. Kumar et al., “XLSR transducer: Streaming ASR for self-supervised pretrained models,”arXiv preprint arXiv:2407.04439, 2024.
[3] C. Liang et al., “Fast-U2++: Fast and accurate end-to-end speech recognition in joint CTC/attention frames,”Proc. ICASSP, IEEE, 2023, pp. 1–5.
[4] W. Zhao et al., “CuSide-T: Chunking, simulating future and decoding for transducer based streaming ASR,”Proc. ISCSLP, IEEE, 2024, pp. 11–15.
[5] J. Yu et al., “FastEmit: Low latency streaming ASR with sequence-level emission regularization,”Proc. ICASSP, IEEE, 2021, pp. 6004–6008.
[6] Z. Tian et al., “Peak-first CTC: Reducing the peak latency of CTC models by applying peak-first regularization,”Proc. ICASSP, IEEE, 2023, pp. 1–5.
[7] H. Bu et al., “AISHELL-1: An open-source Mandarin speech corpus and a speech recognition baseline,”Proc. O-COCOSDA, IEEE, 2017, pp. 1–5.
[8] B. Zhang et al., “Wenetspeech: A 10000+ hours multi-domain Mandarin corpus for speech recognition,”Proc. ICASSP, IEEE, 2022, pp. 6182–6186.
[9] D. Wu, B. Zhang, C. Yang, Z. Peng, W. Xia, X. Chen, and X. Lei, “U2++: Unified two-pass bidirectional end-to-end model for speech recognition,” arXiv preprint arXiv:2106.05642, 2021.
