
 语音小管家
近年来,神经网络偏置(Deep Biasing)方法在上下文语音识别(Contextual ASR)任务中取得了显著进展,其旨在提升模型对实体名称、技术术语等罕见短语的识别能力。当前主流方法多基于浅融合或神经网络偏置技术,将上下文短语中的子词视为独立单元进行增强,这可能会破坏上下文短语的整体性,从而影响识别准确率。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)和长安汽车合作论文“Contextualized Automatic Speech Recognition with Dynamic Vocabulary Prediction and Activation”被语音旗舰会议Interspeech 2025接收。该方法利用动态词表预测与激活机制,基于编码器实现上下文语音识别,并在架构上进行了优化,引入了偏置损失函数,以扩展基于帧级输出的短语级上下文预测。此外,该论文还提出了一种置信度激活解码方法,可在抑制错误偏置的同时,确保上下文短语的完整输出。在LibriSpeech和Wenetspeech两个数据集上的实验结果表明,与基线系统相比,所提出方法在整体词错误率(WER)上分别实现了28.31%和23.49%的相对降低,在上下文短语上的WER相对降低幅度分别达到了72.04%和75.69%,验证了所提方法在中英文语音识别任务中的广泛适应性与有效性。现对该论文进行简要的解读。
论文题目:ContextualizedAutomatic Speech Recognition with Dynamic Vocabulary Prediction and Activation
作者列表:林振楠*、黄凯勋*、任伟*、杨林举、谢磊
合作单位:长安汽车
论文原文:https://arxiv.org/abs/2505.23077
背景动机
近年来,在神经网络技术进步的推动下,端到端自动语音识别(E2E-ASR)取得了显著进展 [1, 2, 3, 4, 5, 6]。然而,E2E-ASR 模型高度依赖于其训练数据,导致在面对未知语境下的罕见短语(例如,实体名称和技术术语)时,识别准确率会显著下降。因此,通过深度偏置(Deep Biasing)技术提升 E2E-ASR 的能力,对于准确识别这类罕见短语至关重要。
为解决这一挑战,典型的偏置方法是浅层融合(Shallow Fusion)[7, 8, 9, 10, 11]。该方法使用加权有限状态转换器(WFST)来构建上下文解码图,以改进对上下文短语的识别。然而,通过这种方法提升上下文短语预测的效果有限。基于神经网络的深度偏置方法 [12, 13, 14, 15, 16] 提供了一个更好的解决方案,它将一个专用的偏置模块集成到端到端模型中,使其能够通过可编辑的上下文短语列表快速适应多样化的场景。与浅层融合相比,深度偏置具有更强的适应性,并显著提高了罕见短语的识别能力。
为了提升上下文化语音识别的效果,先前的研究引入了用于深度偏置的偏置模块,例如 CLAS [17] 和 CATT [18]。一些方法,如 CPPN [19],则引入了额外的偏置损失函数来引导模型捕获上下文信息,从而提高了上下文短语的识别准确率。然而,大多数现有偏置方法将上下文短语表示为子词序列,并对每个子词进行孤立的优化。例如,像 "Alexander" 这样的人名可能被分割成子词序列"A"、"lex" 和 "ander",上下文化模型需要学习提高整个序列的概率。但这些方法通常忽视了子词序列的完整性,导致部分或错误的子词预测。先前的研究尝试通过使用前缀树方法 [14, 15, 20] 或集成额外文本数据 [20, 21] 来解决这个问题。这些方法需要额外的计算资源,并且在数据需求方面存在实际限制。最近的一项研究提出将上下文短语视为离散标签),并使用动态词表(Dynamic Vocabulary)[22] 在解码时引入短语级偏置标记。每个标记代表一个完整的上下文短语,使模型能够捕获短语内部子词之间复杂的依赖关系。然而,该方法主要在解码器上实现,使其依赖于自回归解码,并且不如基于编码器的方法那样具有可扩展性。
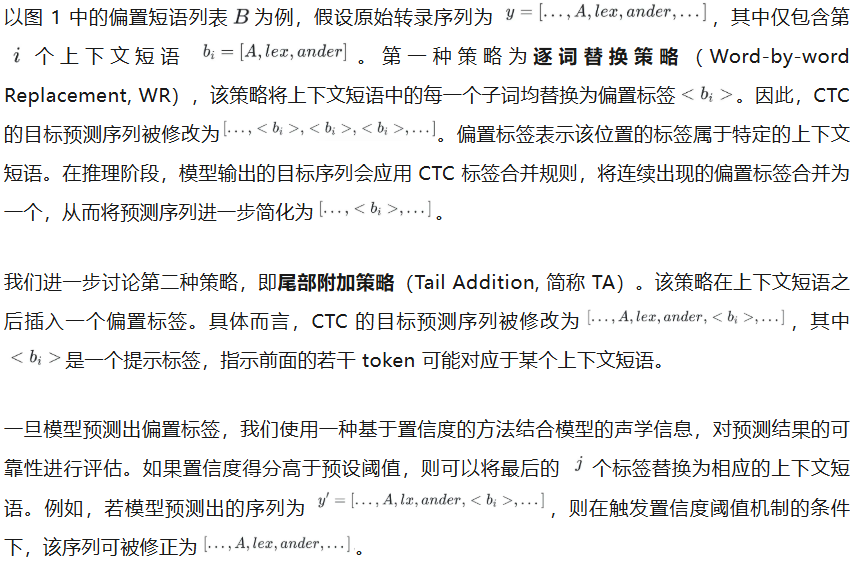
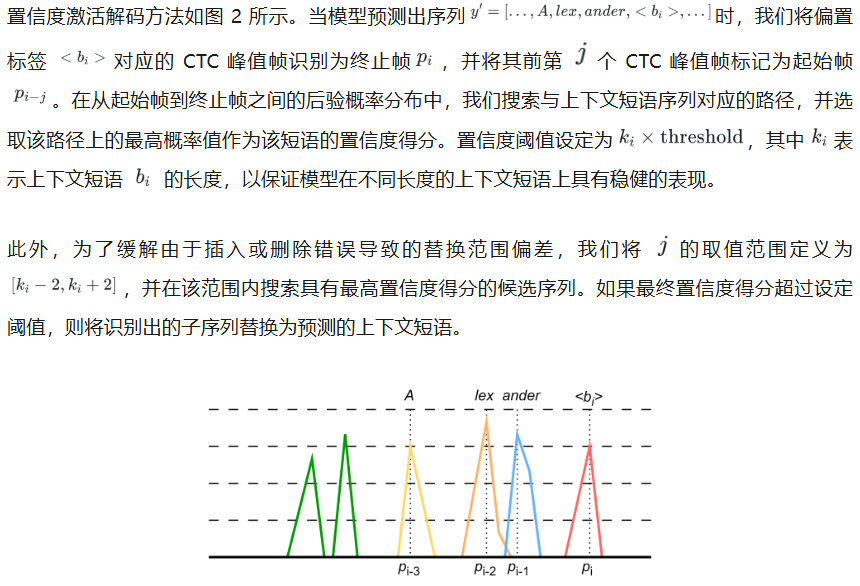
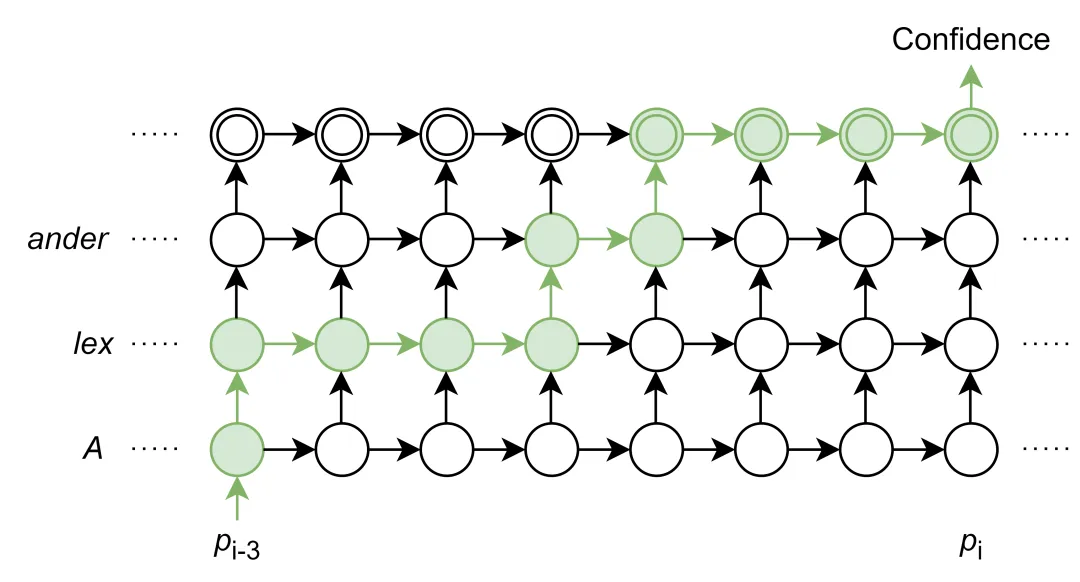
受 Sudo 等研究者工作的启发 [22],我们提出了一种基于编码器架构的上下文语音识别方法,该方法利用了动态词表预测与激活(Dynamic Vocabulary Prediction and Activation)机制。我们使用动态词表,将上下文短语视为统一的标记(即短语级偏置标记),并将其集成到连接时序分类(Connectionist Temporal Classification, CTC)模型的帧级输出(Frame-Level Output)中。我们优化了网络架构,并融入了偏置损失函数,从而增强了模型学习和建模上下文短语的能力。此外,为了更好地利用偏置标记来改进模型的预测结果,我们提出了一种置信度激活的解码策略。该策略结合 CTC 后验概率对模型输出进行后处理,从而实现将预测出的偏置标记及其对应文本准确替换为相应的上下文短语。
我们提出的方法在 英文 LibriSpeech [23] 和中文 WenetSpeech [24] 数据集上,分别实现了 28.26% 和 23.49% 的词错率(WER)相对降低,同时上下文短语的 WER 分别降低了 71.16% 和 75.69%。这些结果验证了我们方法的有效性,证明了该策略在主流英文和中文语音识别基准上均能取得性能提升。
方法介绍
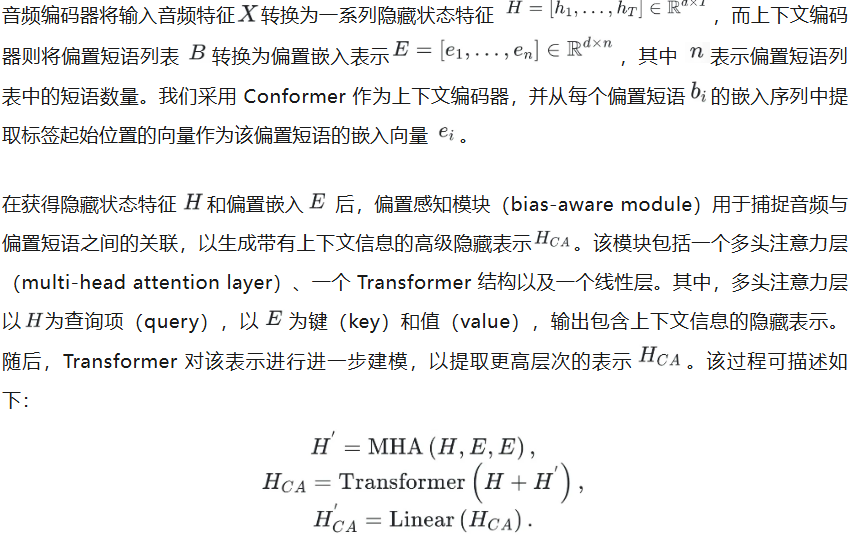
为了避免对模型原本的识别性能产生影响以及加速热词模块的收敛,我们使用预训练的ASR模型添加热词模块,同时冻结原本的模型参数,仅训练热词模块相关参数。如图1所示,为保持模型的可扩展性,我们在编码器上整合了偏置模块,引入了上下文编码器、偏置感知模块、基于多头注意力的输出层和偏差投影层。
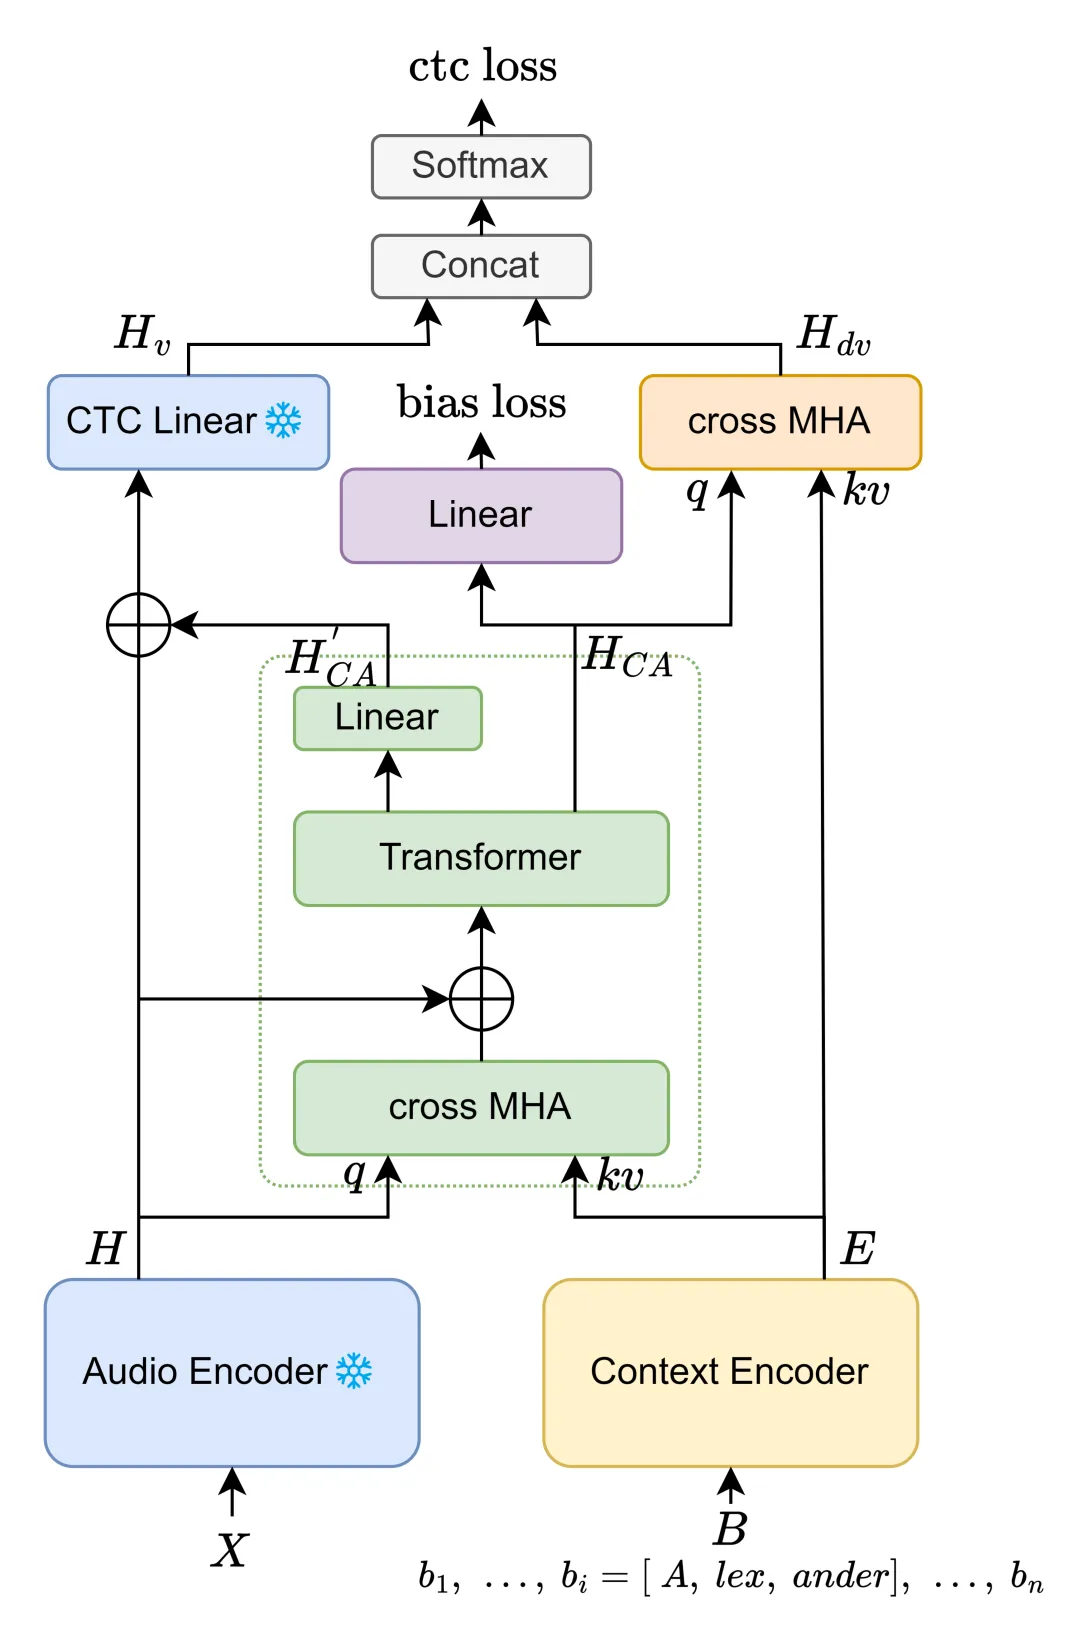
图1 DVPA模型结构
置信度激活策略
实验验证
实验设置与基线
我们分别在 Librispeech [23] 语料库和 Wenetspeech [24] 语料库上进行了实验。Librispeech 数据集包含大约 1000 小时的英文阅读音频。我们在 960 小时的训练数据集上训练 baseline 和偏置模块,dev-clean,dev-other 数据集用于验证,test-clean,test-other 数据集用于评估。测试使用 Librispeech 语料库偏置列表 [20] 作为上下文短语列表。该数据为测试集中的每条数据都构建了大小为 100、500、1000 大小的热词列表,其中的干扰项热词是从整个语料库的罕见词汇中随机采样得到的。
Wenetspeech 上下文偏置数据集由约 1000 小时的 Wenetspeech 子集组成 [27]。我们在该数据集上训练 baseline 和偏置模块,并用其测试集作为评估。测试集被划分为人名,地名以及组织机构名三个测试子集,用 hanlp1 开源工具包识别标签中的命名实体,保留那些出现次数在5到700次之间的命名实体,选取其中的人名、地名和组织机构名,总计298个命名实体来为测试集构建热词列表。
除了使用词错误率(WER)评估ASR模型性能外,我们还使用偏置词错误率(B-WER)和非偏置词错误率(U-WER)评估模型对上下文偏置列表词汇增强性能。U-WER对不在偏置列表中的单词进行测量,而B-WER对在偏置列表的单词上进行测量。对于插入错误,如果插入的短语在偏置列表中,则将其计入B-WER,否则计入U-WER。
对于中文数据集,我们使用CER、U-CER和B-CER评估模型性能。
我们在 Wenet [25] 上训练CTC/AED模型作为baseline以及预训练的ASR模型。并将所提出的模型与DV、CPPN方法进行比较。
标签策略分析
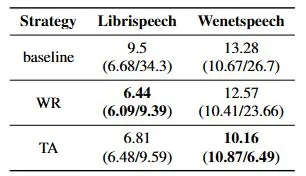
为了评估两种不同上下文标签策略在提升上下文短语识别效果方面的影响,我们在 LibriSpeech 的 test-other 测试集(偏置词列表大小为 100)以及 WeNetSpeech 测试集上进行了比较,评估这两种策略在英文和中文场景下的有效性。如表 1 所示,两种策略均能有效提升上下文短语的识别能力。其中,WR 策略在 test-other 测试集上的表现略优于 TA 策略,但在 WeNetSpeech 测试集上的表现则明显较差,尤其是在处理较长的中文短语时。这可能是由于 WR 策略在建模长上下文短语方面的能力有限。而 TA 策略通过在末尾附加偏置标签,主要强化了上下文短语与整体发音之间的相似性。综合英文和中文测试集上的表现,我们在后续实验中主要采用 TA 策略。
表 1 不同标签策略在 Librispeech 和 Wenetspeech 上的WER(%)结果。指标格式如下:WER (U-WER / B-WER)
Librispeech实验分析
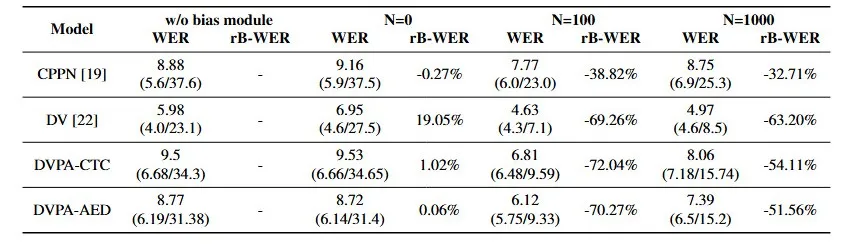
本节分析了不同自动语音识别(ASR)系统在 Librispeech test-other 测试集上,在不同偏置词列表大小条件下的性能表现。考虑到各基线系统在性能上的差异,我们主要关注各系统在 B-WER 上的相对改进情况。如表 2 所示,相较于基线方法,我们提出的方法(以下简称为 DVPA)将 WER 降低了 28.32%,B-WER 降低了 72.04%。当N=100 时,我们的方法在性能上优于其他上下文化的 ASR 模型,取得了显著的性能提升。尽管随着偏置词列表规模的增大,模型整体性能有所下降,但其有效性依然保持较高水平。值得注意的是,即便在偏置词列表大小设为零的情况下,引入偏置模块也不会对模型性能造成明显负面影响。
表 2 不同系统在 Librispeech 上的WER(%)结果。指标格式如下:WER (U-WER / B-WER)
消融实验分析
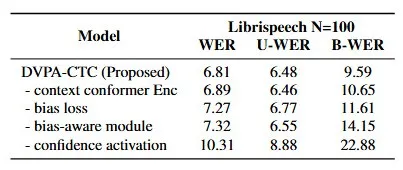
为评估各个模块对整体模型性能的影响,我们在 Librispeech 数据集上进行了消融实验。实验结果表明,移除偏置损失函数会导致模型性能下降。与 WA 策略相比,TA 策略在引入偏置损失函数后表现出更明显的性能提升。这可能是因为 TA 策略主要强调整体发音的匹配,但在建模子词级别的发音细节方面存在不足,从而限制了其效果。此外,去除偏置感知模块会导致 WER 和 B-WER 显著上升,说明该模块对于有效捕捉偏置信息具有关键作用。当关闭置信度激活的解码策略时,错误的预测与替换行为会对识别性能产生负面影响,进一步验证了该策略的有效性。
表 3 消融实验
WenetSpeech实验分析
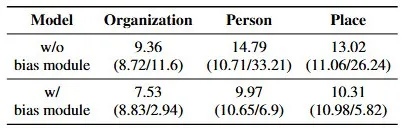
为评估所提方法在中文场景下的有效性,我们在 WenetSpeech测试集上进行了实验。如表 4 所示,实验结果表明,我们提出的方法在中文任务中显著提升了 WER 和 B-WER 的表现,同时在处理不同类型和长度的上下文短语(如组织名称、地名和人名)时表现出较强的鲁棒性。具体而言,模型在 CER 上取得了平均 23.49% 的相对提升,在 B-CER 上取得了 75.69% 的相对提升。上述结果进一步验证了该方法在中文上下文化语音识别任务中的有效性。
表 4 在 Wenetspeech 上的WER(%)结果。指标格式如下:WER (U-WER / B-WER)
参考文献
[1] A. Graves, S. Fern´andez, F. Gomez, and J. Schmidhuber, “Connectionist temporal classification: labelling unsegmented sequence data with recurrent neural networks,” in Proc. ICML, 2006, pp. 369–376.
[2] A. Graves, “Sequence transduction with recurrent neural networks,” in Proc. ICML, 2012.
[3] J. K. Chorowski, D. Bahdanau, D. Serdyuk, K. Cho, and Y. Bengio, “Attention-based models for speech recognition,” Advances in neural information processing systems, 2015.
[4] A. Gulati, J. Qin, C.-C. Chiu, N. Parmar, Y. Zhang, J. Yu, W. Han, S. Wang, Z. Zhang, Y. Wu, and R. Pang, “Conformer: Convolution-augmented transformer for speech recognition,” in Proc. Interspeech, 2020, pp. 5036–5040.
[5] W. Chan, N. Jaitly, Q. Le, and O. Vinyals, “Listen, attend and spell: A neural network for large vocabulary conversational speech recognition,” in Proc. ICASSP. IEEE, 2016, pp. 4960–
4964.
[6] K. Cho, B. van Merrienboer, . G¨ulehre, D. Bahdanau, F. Bougares, H. Schwenk, and Y. Bengio, “Learning phrase representations using rnn encoderdecoder for statistical machine translation,” in Proc. EMNLP, 2014.
[7] I. Williams, A. Kannan, P. S. Aleksic, D. Rybach, and T. N. Sainath, “Contextual speech recognition in end-to-end neural network systems using beam search,” in Proc. Interspeech, 2018, pp. 2227–2231.
[8] Z. Chen, M. Jain, Y. Wang, M. L. Seltzer, and C. Fuegen, “End-to-end contextual speech recognition using class language models and a token passing decoder,” in Proc. ICASSP. IEEE, 2019, pp. 6186–6190.
[9] D. Zhao, T. N. Sainath, D. Rybach, P. Rondon, D. Bhatia, B. Li, and R. Pang, “Shallow-fusion end-to-end contextual biasing,” in Proc. Interspeech, 2019, pp. 1418–1422.
[10] R. Huang, O. Abdel-hamid, X. Li, and G. Evermann, “Class lm and word mapping for contextual biasing in end-to-end asr,” in Proc. Interspeech, 2020, pp. 4348–4351.
[11] S. Kim, Y. Shangguan, J. Mahadeokar, A. Bruguier, C. Fuegen, M. L. Seltzer, and D. Le, “Improved neural language model fusion for streaming recurrent neural network transducer,” in Proc. ICASSP. IEEE, 2021, pp. 7333–7337.
[12] Z. Chen, M. Jain, Y. Wang, M. L. Seltzer, and C. Fuegen, “Joint grapheme and phoneme embeddings for contextual end-to-end asr,” in Proc. Interspeech, 2019, pp. 3490–3494.
[13] M. Han, L. Dong, S. Zhou, and B. Xu, “Cif-based collaborative decoding for end-to-end contextual speech recognition,” in Proc. ICASSP. IEEE, 2021, pp. 6528–6532.
[14] G. Sun, C. Zhang, and P. C. Woodland, “Tree-constrained pointer generator for end-to-end contextual speech recognition,” in Proc. ASRU. IEEE, 2021, pp. 780–787.
[15] S. Dingliwal, M. Sunkara, S. Ronanki, J. Farris, K. Kirchhoff, and S. Bodapati, “Personalization of ctc speech recognition models,” in Proc. SLT. IEEE, 2023, pp. 302–309.
[16] M. Han, L. Dong, Z. Liang, M. Cai, S. Zhou, Z. Ma, and B. Xu, “Improving end-to-end contextual speech recognition with fine-grained contextual knowledge selection,” in Proc. ICASSP. IEEE, 2022, pp. 8532–8536.
[17] G. Pundak, T. N. Sainath, R. Prabhavalkar, A. Kannan, and D. Zhao, “Deep context: end-to-end contextual speech recognition,” in Proc. SLT. IEEE, 2018, pp. 418–425.
[18] F.-J. Chang, J. Liu, M. Radfar, A. Mouchtaris, M. Omologo, A. Rastrow, and S. Kunzmann, “Context-aware transformer transducer for speech recognition,” in Proc. ASRU. IEEE, 2021, pp. 503–510.
[19] K. Huang, A. Zhang, Z. Yang, P. Guo, B. Mu, T. Xu, and L. Xie, “Contextualized end-to-end speech recognition with contextual phrase prediction network,” in Proc. Interspeech, 2023, pp. 4933–4937.
[20] D. Le, M. Jain, G. Keren, S. Kim, Y. Shi, J. Mahadeokar, J. Chan, Y. Shangguan, C. Fuegen, O. Kalinli, Y. Saraf, and M. L. Seltzer, “Contextualized streaming end-to-end speech recognition with trie-based deep biasing and shallow fusion,” in Proc. Interspeech, 2021, pp. 1772–1776.
[21] J. Qiu, L. Huang, B. Li, J. Zhang, L. Lu, and Z. Ma, “Improving large-scale deep biasing with phoneme features and text-only data in streaming transducer,” in Proc. ASRU. IEEE, 2023, pp. 1–8.
[22] Y. Sudo, Y. Fukumoto, M. Shakeel, Y. Peng, and S. Watanabe, “Contextualized automatic speech recognition with dynamic vocabulary,” in Proc. SLT. IEEE, 2024, pp. 78–85.
[23] V. Panayotov, G. Chen, D. Povey, and S. Khudanpur, “Librispeech: An asr corpus based on public domain audio books,” in Proc. ICASSP. IEEE, 2015, pp. 5206–5210.
[24] B. Zhang, H. Lv, P. Guo, Q. Shao, C. Yang, L. Xie, X. Xu, H. Bu, X. Chen, C. Zeng et al., “Wenetspeech: A 10000+ hours multi-domain mandarin corpus for speech recognition,” in Proc. ICASSP. IEEE, 2022, pp. 6182–6186.
[25] Z. Yao, D. Wu, X. Wang, B. Zhang, F. Yu, C. Yang, Z. Peng, X. Chen, L. Xie, and X. Lei, “Wenet: Production oriented streaming and non-streaming end-to-end speech recognition toolkit,” in Proc. Interspeech, 2021, pp. 1–5.
[26] D. S. Park, W. Chan, Y. Zhang, C.-C. Chiu, B. Zoph, E. D. Cubuk, and Q. V. Le, “Specaugment: A simple data augmentation method for automatic speech recognition,” in Proc. Interspeech, 2019, pp. 2613–2617.
[27] Y. Xu, B. Liu, Q. Huang, X. Song, Z. Wu, S. Kang, and H. Meng, “Cb-conformer: Contextual biasing conformer for biased word recognition,” in Proc. ICASSP. IEEE, 2023, pp. 1–5.
