
 语音小管家
语音识别(ASR)作为可以准确高效转录语音的技术,在当今社会中扮演着越来越重要的角色。当前语音识别已经取得了长足进步,但是当遇到不利语音条件时,识别错误率急剧升高。口音是说话人受到教育背景、地域或母语影响而偏离标准发音规范的情况,在现实世界中广泛多样。最近,借助大语言模型(LLM)的生成式纠错(Generative Error Correction, GER)能力,语音识别的准确率得到进一步提升。此外,混合专家(MoE)已经成为大语言模型同时在多种领域中具备强大能力所采用的通用技术。如何将大语言模型的生成式错误纠正与混合专家结合,以增强语音识别在现实世界多样化口音场景下的性能,是本研究的目标。
最近,西北工业大学音频语音与语言处理研究组(ASLP@NPU)的论文“Mixture of LoRA Experts with Multi-Modal and Multi-Granularity LLM Generative Error Correction for Accented Speech Recognition”被语音研究领域顶级期刊 IEEE Transactions on Audio, Speech and Language Processing (TASLP) 录用。该论文提出了将大语言模型生成式错误纠正与混合专家相结合的方法以提升语音识别在多种口音下性能。现对该论文进行简要的解读。
论文题目:Mixture of LoRA Experts with Multi-Modal and Multi-Granularity LLM Generative Error Correction for Accented Speech Recognition
作者列表:穆秉甡,魏坤,郭鹏程,谢磊
论文预印版:https://arxiv.org/abs/2507.09116
背景动机
大语言模型(Large Language Models,LLMs)的重大进步极大地推动了其在自动语音识别(Automatic Speech Recognition,ASR)领域的研究。生成式纠错(Generative Error Correction,GER)[1] 通过对LLMs进行低秩适应(Low-rank Adaptation,LoRA)[2] 使其学习从ASR假设到转录的映射,取得了显著效果。
口音是说话人受教育背景、地域或母语影响而偏离标准发音规范的情况。口音语音识别既需要发音信息,也需要语义信息。不同的口音在音素发音上表现出相当大的差异,而且还会涉及音素连读、弱化、替换和省略等现象。细微的发音差异对于实现准确的口音语音识别至关重要。然而,GER完全依赖N个最优词级别假设进行转录预测,忽略了口音语音中固有的发音信息。
此外,在实际情况中单一语言往往包含多种口音,每种口音都有独特的发音模式。为每种口音训练一个专门的模型并将其视为专家,然后通过专家混合(Mixture of Experts,MoE)方法整合这些专家,是解决口音语音识别中口音多样性挑战的一种切实可行的解决方案。受MoE的启发,许多研究人员将LoRA视为领域专家,从而提出了混合LoRA专家(Mixture of LoRA Experts,MoLE)方法。该方法存在两个主要问题:一是无约束的MoE中较高的变异系数反映出路由器始终将较大的权重分配给相同的少数几个专家,这种专家利用不平衡问题在MoE中很常见,表明专家与领域之间缺乏明确的对应关系;二是静态的Top-K专家选择策略限制了MoE的适应性,这需要更动态的专家选择策略来应对不同领域的复杂性。
本文旨在利用口音语音中的多模态多粒度发音和语义信息,即语音模态发音信息、口音语音音素级别假设中的文本模态发音信息和词级别假设中的文本模态语义信息来改进GER,同时通过MoLE将多个口音LoRA专家进行集成,应对语音识别在现实世界中多口音场景识别错误率高的挑战。
提出的方案
我们的方案可以总结为以下流程:(1)通过多模态GER获取单口音LoRA专家;(2)改进的带有层次路由和动态阈值的混合LoRA专家方法(HDMoLE)组合单口音LoRA专家;(3)多粒度GER预测最终结果。
多模态GER
多模态GER利用语音编码器和连接层产生的语音嵌入和ASR输出的最佳假设,同时利用口音语音中的语音模态发音信息和最优词级别假设中的文本模态语义信息来预测口音语音的转录。如图1所示,我们对每种口音语音通过三阶段训练方式获取单口音LoRA专家。
阶段1:使用全部口音数据只训练连接层,使其具备语音特征到LLM文本空间的对齐能力。
阶段2:加载阶段1的连接层参数,使用全部口音数据同时训练连接层和LLM的LoRA部分。因为在阶段3连接层保持冻结,所以合适的连接层初始化至关重要。
阶段3:加载阶段2的连接层参数并保持冻结,使用单口音数据只训练LLM的LoRA部分,获取每个口音的LoRA专家。
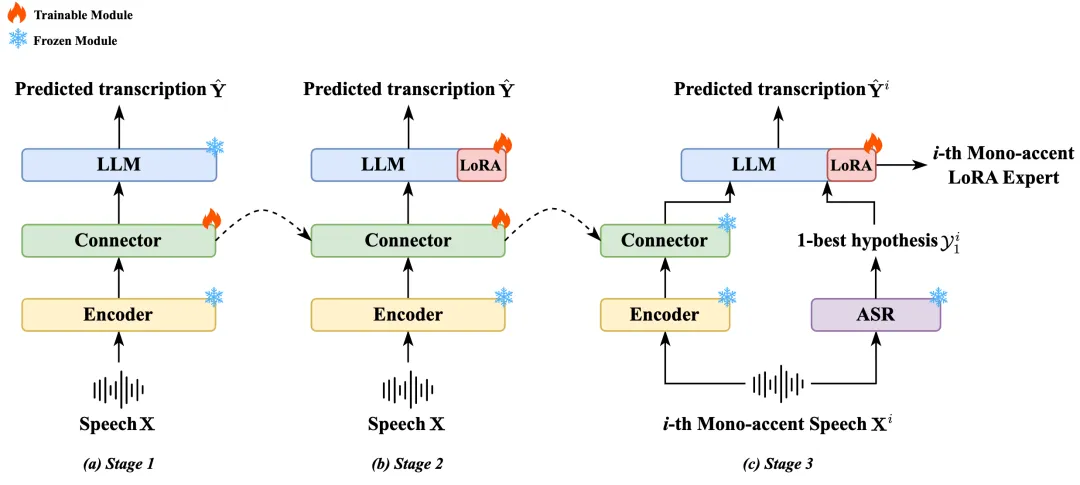
图1 利用多模态GER获取单口音LoRA专家的三阶段训练策略图
改进的HDMoLE
层次路由:层次路由包含全局路由和局部路由,其中预训练的口音分类模型(Accent Recognition,AR)为全局路由器,每层HDMoLE中的路由器为本地路由器。全局路由将AR模型产生的输入语音口音分类概率输入到每层HDMoLE中,概率高的口音类别对应的LoRA专家具有更高的权重,通过这种方式为每个LoRA专家明确需要关注的口音类别,明确了LoRA专家与口音类别的对应关系,减轻LoRA专家利用不平衡的问题。同时由于同一种语言的不同口音之间存在可能的互补关系,本地路由则隐式引导专注于不同口音类别的LoRA专家进行协作。
动态阈值:动态阈值策略允许每个MoLE层灵活选择需要激活的LoRA专家。该策略需要定义一个阈值,选择权重超过阈值的LoRA专家。阈值的初始化需要特别注意,因为初始化的阈值较大可能会导致所有LoRA专家权重低于这个阈值,从而导致没有LoRA专家被选择。在每层HDMoLE中,我们分别为全局权重和局部权重分配两个独立的动态阈值。通过全局和局部阈值,我们可以获取筛选并归一化的全局和局部权重,将两者相加可以获得每个LoRA专家的最终权重。
混合LoRA专家:我们使用上一个步骤中获得的LoRA专家权重,对每个LoRA专家的输出进行加权求和,以获得每层HDMoLE的输出。
与之前的不同[3]:(1)在本研究中,我们将HDMoLE由连接层扩展到了LLM的多个线性层,使其可以更有效的完成多口音适配。(2)在本研究中,我们将HDMoLE中原本需要从头训练的LoRA专家替换为预训练好的LoRA专家,并且在HDMoLE训练过程中保持LoRA专家冻结,只更新局部路由器和动态阈值。这极大简化了HDMoLE的计算量,同时保持原有LoRA专家的能力不受影响,并且可以进一步通过相似口音之间的LoRA协作获取更优的多口音语音识别性能。
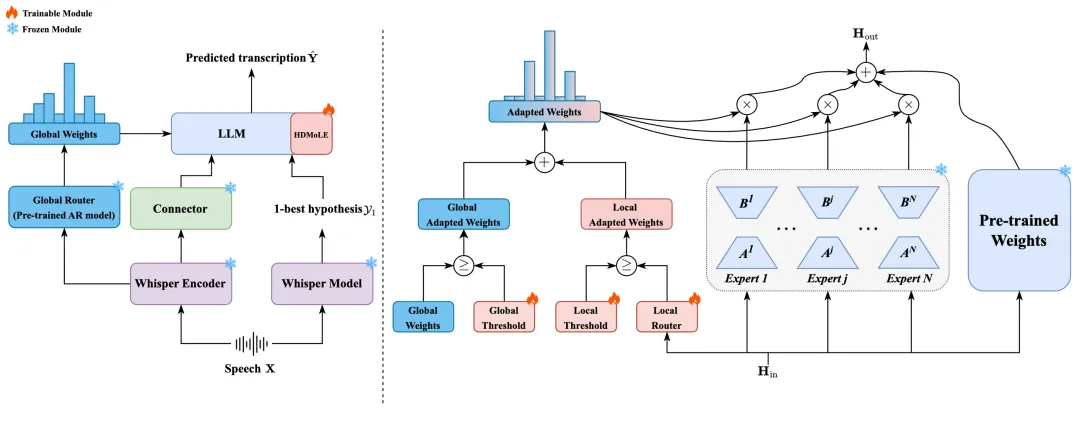
图2 改进的HDMoLE结构图
多粒度GER
更细粒度的语言信息有助于激活LLM更全面的文本处理能力。音素作为与发音相关的细粒度语言单位,使LLM能够更深入地理解单词发音模式,从而增强单词级别的纠错能力。单词作为与语义相关的粗粒度语言单位,能让LLM更好地理解假设的语义内容,提升假设级别的纠错能力。 多粒度GER利用HDMoLE模型产生的N个最优的词级别假设中的文本模态语义信息及其对应的N个最优的音素级别假设中的文本模态发音信息来预测最终的口音语音转录。如图3所示,我们通过使用Phonemizer工具将HDMoLE产生的N个最优词级别假设转化为对应的N个最优的国际音标(International Phonetic Alphabet,IPA)音素序列假设,然后将两者通过LoRA微调,使LLM学习两种粒度假设到最终转录的映射。
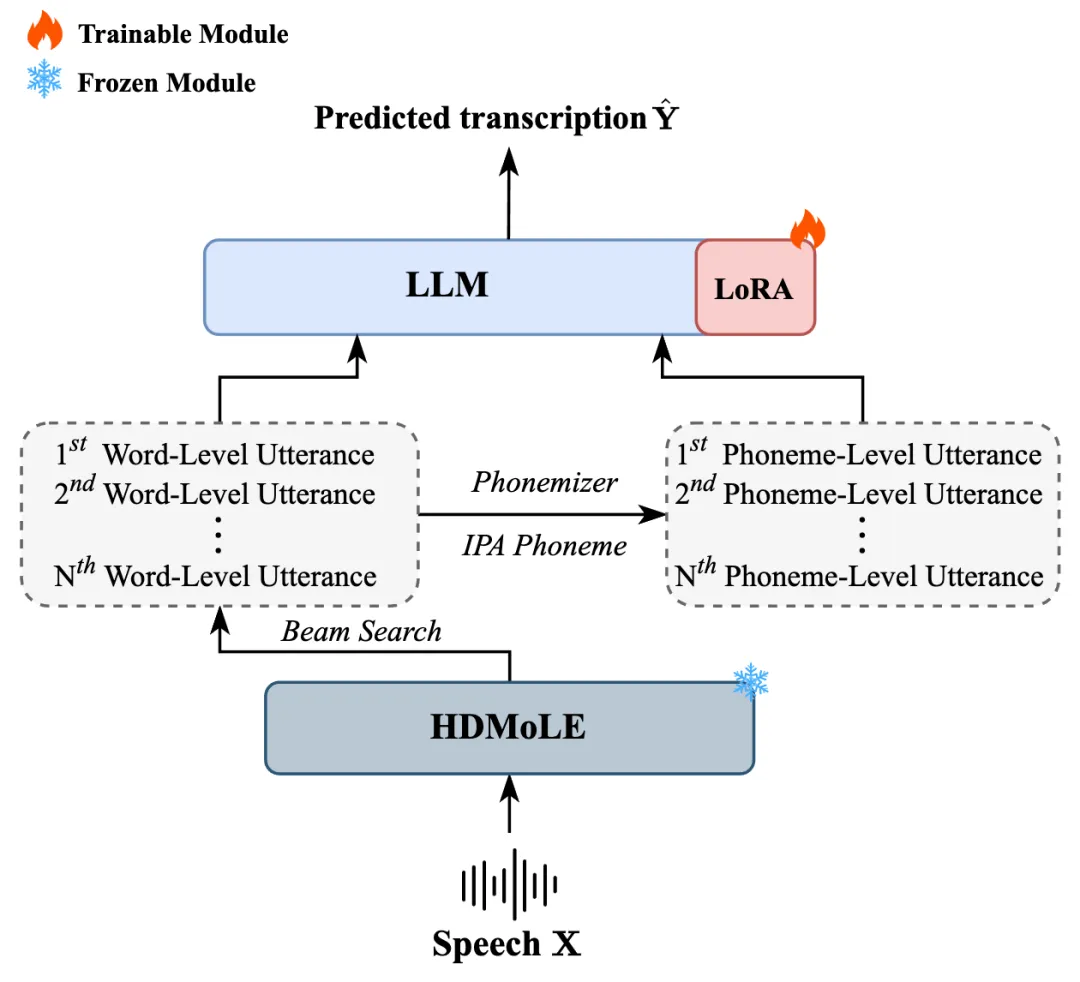
图3 多粒度GER结构图
实验
我们选取了Common Voice 19.0[4]、VCTK[5] 和AESRC[6] 数据集的9种英语口音数据进行实验,如表1所示。
表1 英语口音数据集的组成
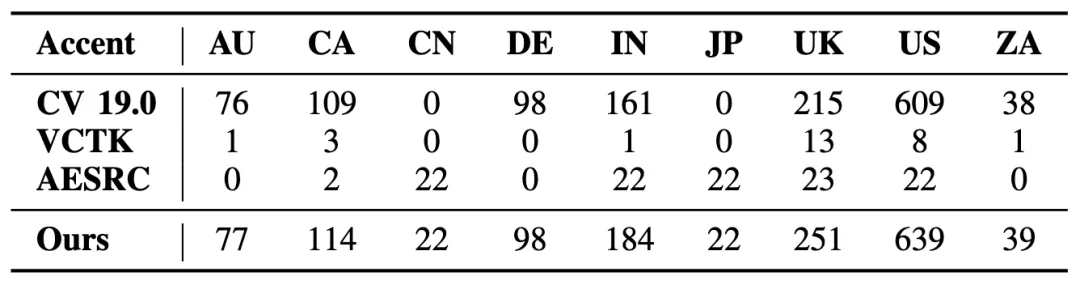
表2对比了现有预训练模型和方法与本论文方案在可训练参数、总模型参数、浮点运算次数(Floating Point of Operations,FLOPs)、平均词错误率(Word Error Rate,WER)和每种口音WER等指标的差异。我们的方法在可训练参数和FLOPs较少的情况下,取得了最佳的语音识别性能。
表2 主实验结果
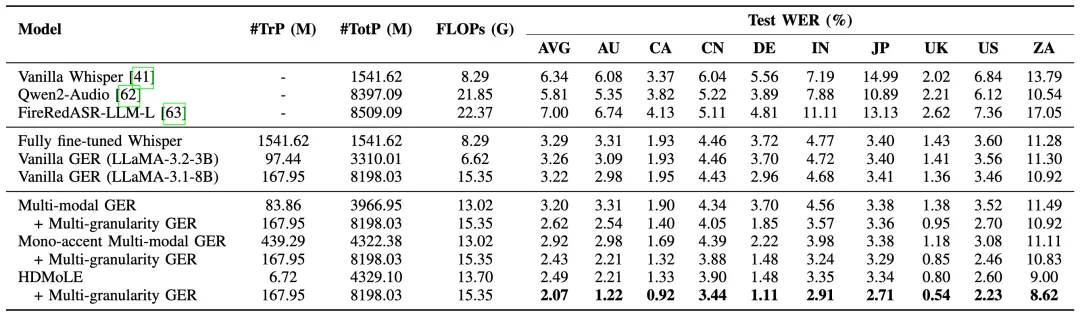
表3对比HDMoLE与其他MoLE方法。由于其他MoLE方案并没有开源代码,于是我们严格按照这些方案的原论文进行了复现,并且罗列了HDMoLE与其他MoLE方法的主要区别。HDMoLE在可训练参数较少的情况下,取得了最佳的语音识别性能。
表3 HDMoLE与其他MoLE对比
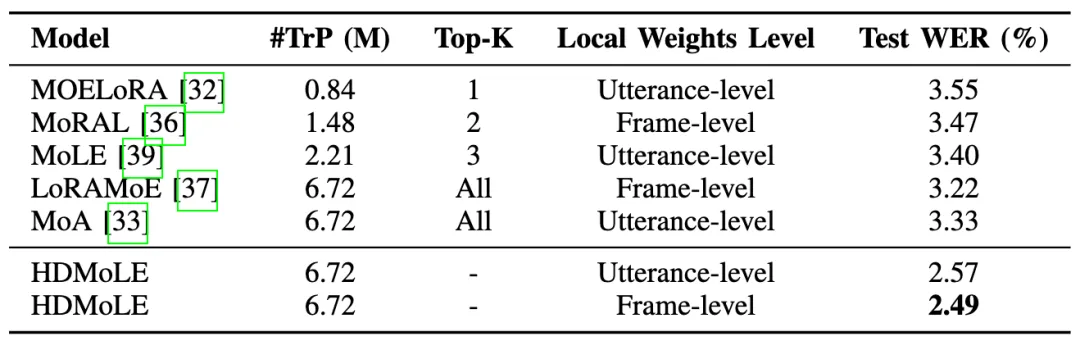
表4展示了对多模态GER的消融实验。语音嵌入与最佳词级假设的组合实现了最佳性能,而语音嵌入和最佳音素级假设的输入导致性能下降,这是因为没有语义信息的细粒度发音信息的组合无法激活LLM的转录预测能力,表明语义信息在使大语言模型能够有效地从假设中预测转录方面起着关键作用。然而,将语音嵌入、词级假设和音素级假设同时输入到LLM中会进一步降低性能。这种现象可归因于信息中过多的冗余和冲突,加重LLM负担过重。词级假设提供的语义信息对GER至关重要,过多的发音信息会阻碍其性能。基于这一结论,我们只能分别提出多模态GER和多粒度GER,而不是将它们整合到一个单一的GER变体中。
表4 多模态GER的消融实验
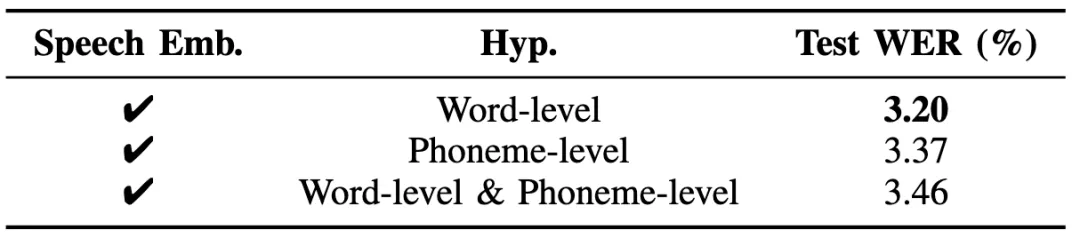
表5展示了对HDMoLE中动态阈值的消融实验。我们发现静态固定专家选择策略不如动态阈值专家选择策略,且对全局和局部路由器都应用动态阈值可以获得最佳结果。
表5 HDMoLE动态阈值的消融实验
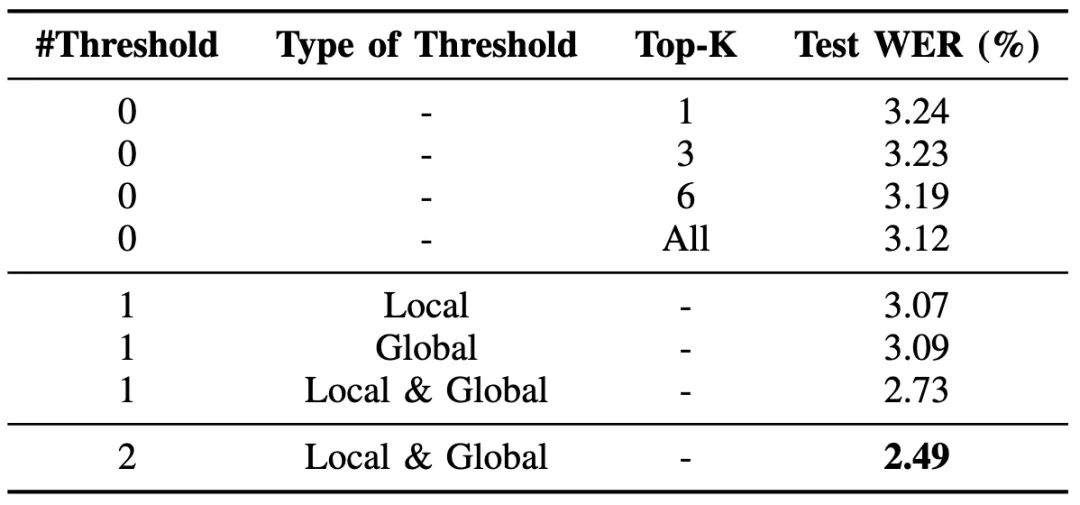
图4展示了在每个采用HDMoLE的LLM层选择LoRA专家的平均数量。我们可以观察到一个明显的趋势,即在前十个LLM层中,所选LoRA专家的数量逐渐减少,随后趋于稳定。这一现象表明,LLM的前十个层倾向于利用更全面的信息,需要HDMoLE整合更多数量的LoRA专家。LLM的较深层专注于更特定的信息,所以HDMoLE只需整合较少数量的LoRA专家。
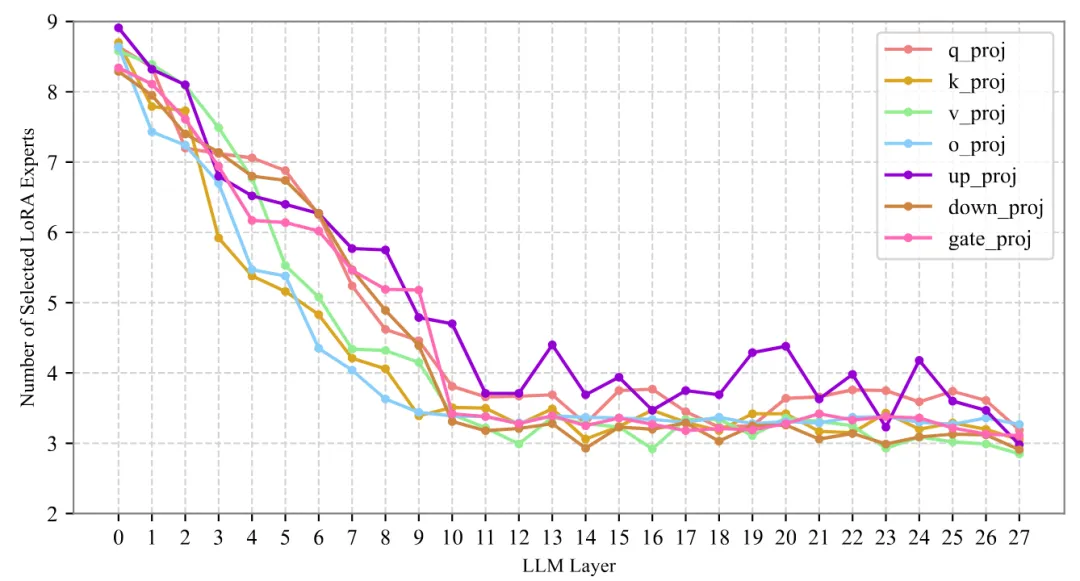
图4 每个LLM层激活LoRA专家的平均数量
图5的可视化结果表明,全局路由增强了局部路由生成局部权重的能力,这些局部权重在区分不同口音时更为有效。某些口音在一定程度上具有相似性,这有助于在语音识别性能上相互提升。对于容易混淆的口音,分层路由利用这种相似性带来的互补性组合相关的LoRA专家。对于明显不同的口音,分层路由可以为其相应的单一口音LoRA专家分配显著更高的权重。
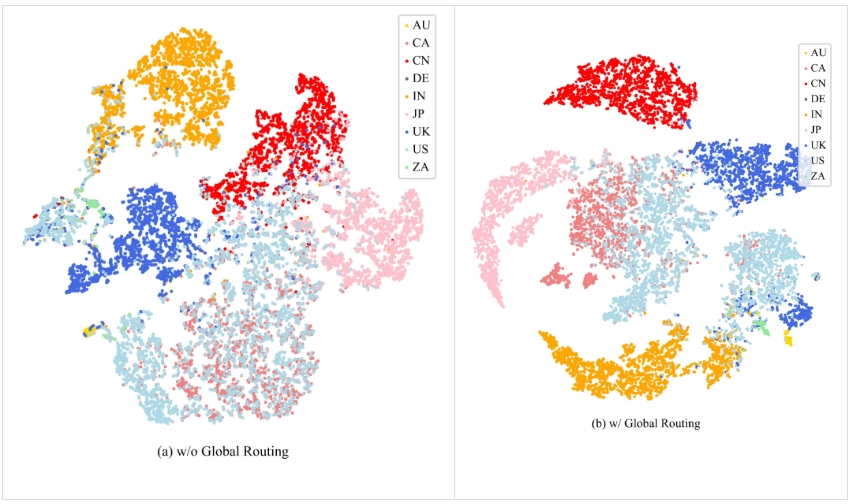
图5 T-SNE可视化在是否有全局路由的条件下局部权重的分布
表6研究了HDMoLE中全局路由的影响。当口音识别准确率(AR ACC)为0时,表明不存在全局路由,此时局部路由仍能部分执行合并LoRA专家的任务。当AR ACC为50.79% 时,全局路由显著干扰了局部路由,导致性能下降。一旦AR ACC超过71.29%,全局路由在引导局部路由方面发挥重要作用,从而带来更好的LoRA专家合并结果。
表6 全局路由器性能对语音识别的影响
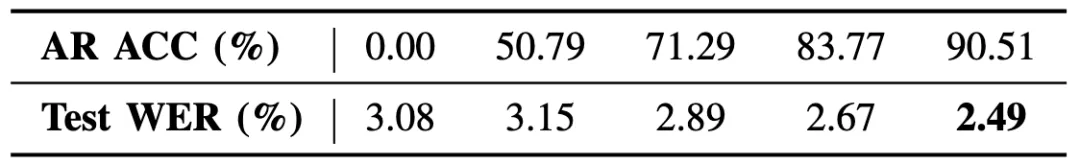
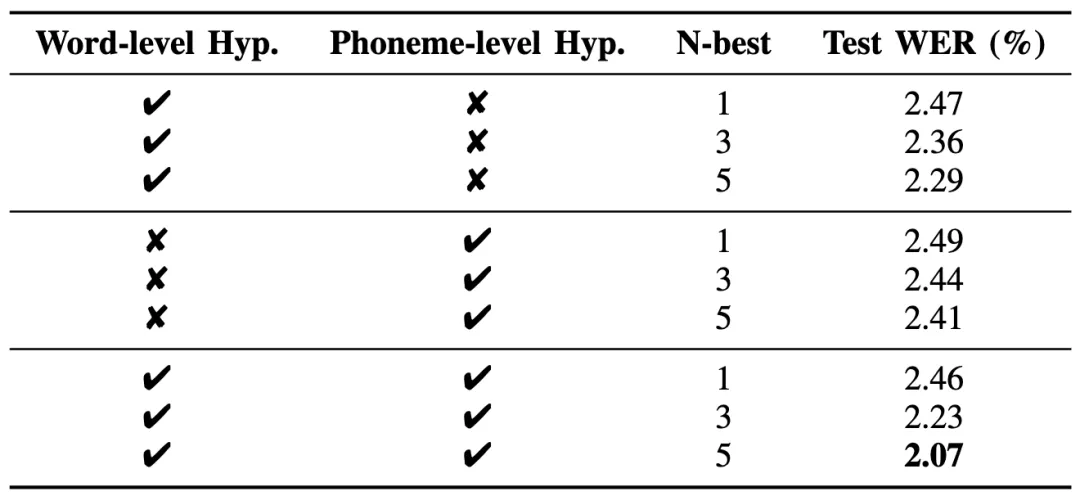
表7评估了不同粒度和假设数量多粒度GER的影响。随着假设数量的增加,语音识别性能有所提升,因为更多的假设增加了包含更准确单词或音素的可能性。此外,N最佳词级假设的表现优于N最佳音素级假设,这表明LLM更擅长理解词级假设中的语义信息,从而有助于在假设层面进行纠错。通过同时利用词级和音素级假设可实现最佳性能,其中词级假设提供语义信息,音素级假设提供发音信息。
表7 多粒度GER消融实验
参考文献
[1] Chen Chen, Yuchen Hu, Chao-Han Huck Yang, Sabato Marco Siniscalchi, Pin-Yu Chen, and Eng-Siong Chng, “Hyporadise: An open baseline for generative speech recognition with large language models,” Advances in Neural Information Processing Systems, vol. 36, 2024.
[2] Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang, and Weizhu Chen, “LoRA: Low-Rank Adaptation of Large Language Models,” in Proc. ICLR, 2022.
[3] Bingshen Mu, Kun Wei, Qijie Shao, Yong Xu, and Lei Xie, “HDMoLE: Mixture of LoRA Experts with Hierarchical Routing and Dynamic Thresholds for Fine-Tuning LLM-based ASR Models,” in Proc. ICASSP, 2025.
[4] Rosana Ardila, Megan Branson, Kelly Davis, Michael Henretty, Michael Kohler, Josh Meyer, Reuben Morais, Lindsay Saunders, Francis M Tyers, and Gregor Weber, “Common Voice: A Massively-Multilingual Speech Corpus,” in Proc. LREC, 2020, pp. 4218–4222.
[5] https://datashare.ed.ac.uk/handle/10283/3443
[6] Xian Shi, Fan Yu, Yizhou Lu, Yuhao Liang, Qiangze Feng, Daliang Wang, Yanmin Qian, and Lei Xie, “The Accented English Speech Recognition Challenge 2020: Open Datasets, Tracks, Baselines, Results and Methods,” in Proc. ICASSP, 2021, pp. 6918–6922.
