
 语音小管家
语音到语音大模型(SLLM)火了,但你是否也发现:一旦从“文字”换成“开口说话”,模型的知识与推理能力就开始出现了退化?这并不是错觉,而是“声学-语义鸿沟”在作怪。本文带你看一篇来自香港中文大学(深圳)李海洲教授/王本友教授团队发布的新模型——EchoX,它用一种很巧妙的训练方式,把“会说话”和“会思考”重新拧回到一起。
论文链接: https://www.arxiv.org/abs/2509.09174
⏩问题本质
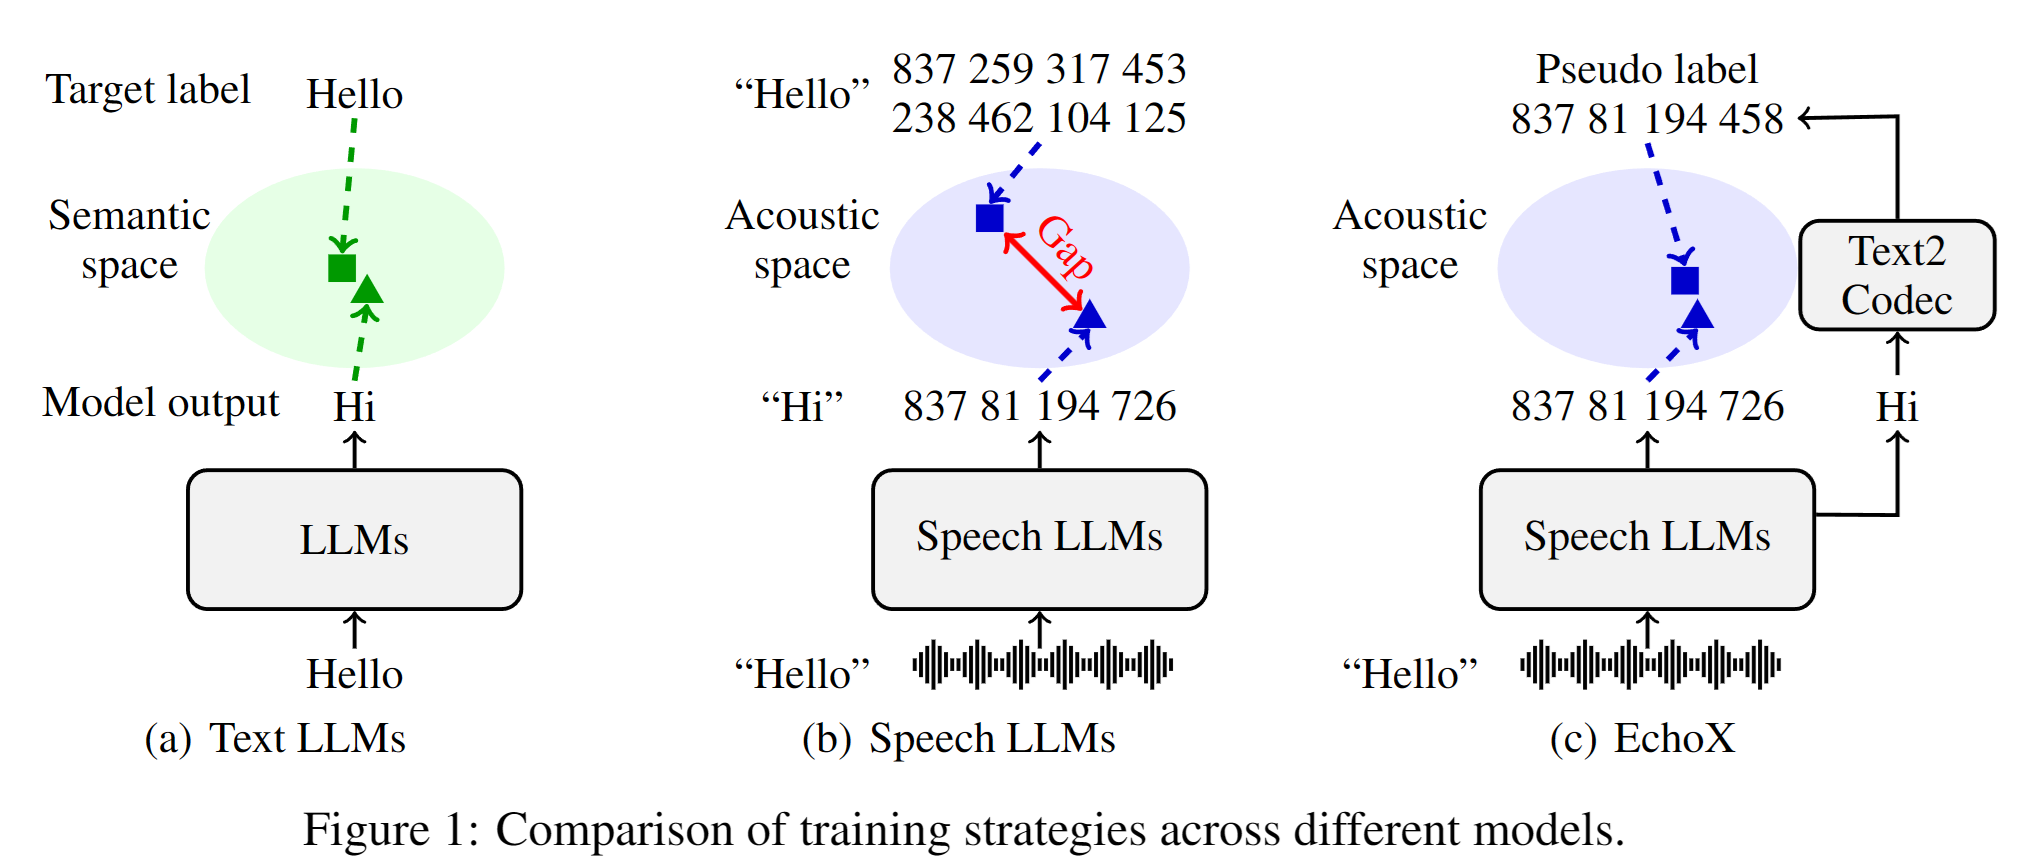
在文本LLM训练过程中,语义等价即可,并不需要考虑发音问题。而现有SLLM以“语音编码后的声学token一致”为训练目标,模型被迫追求“发音一致”而忽略语义信息。但于是出现:语义正确但发音错误会被重罚,知识与推理能力被拖累。
⏩EchoX破局
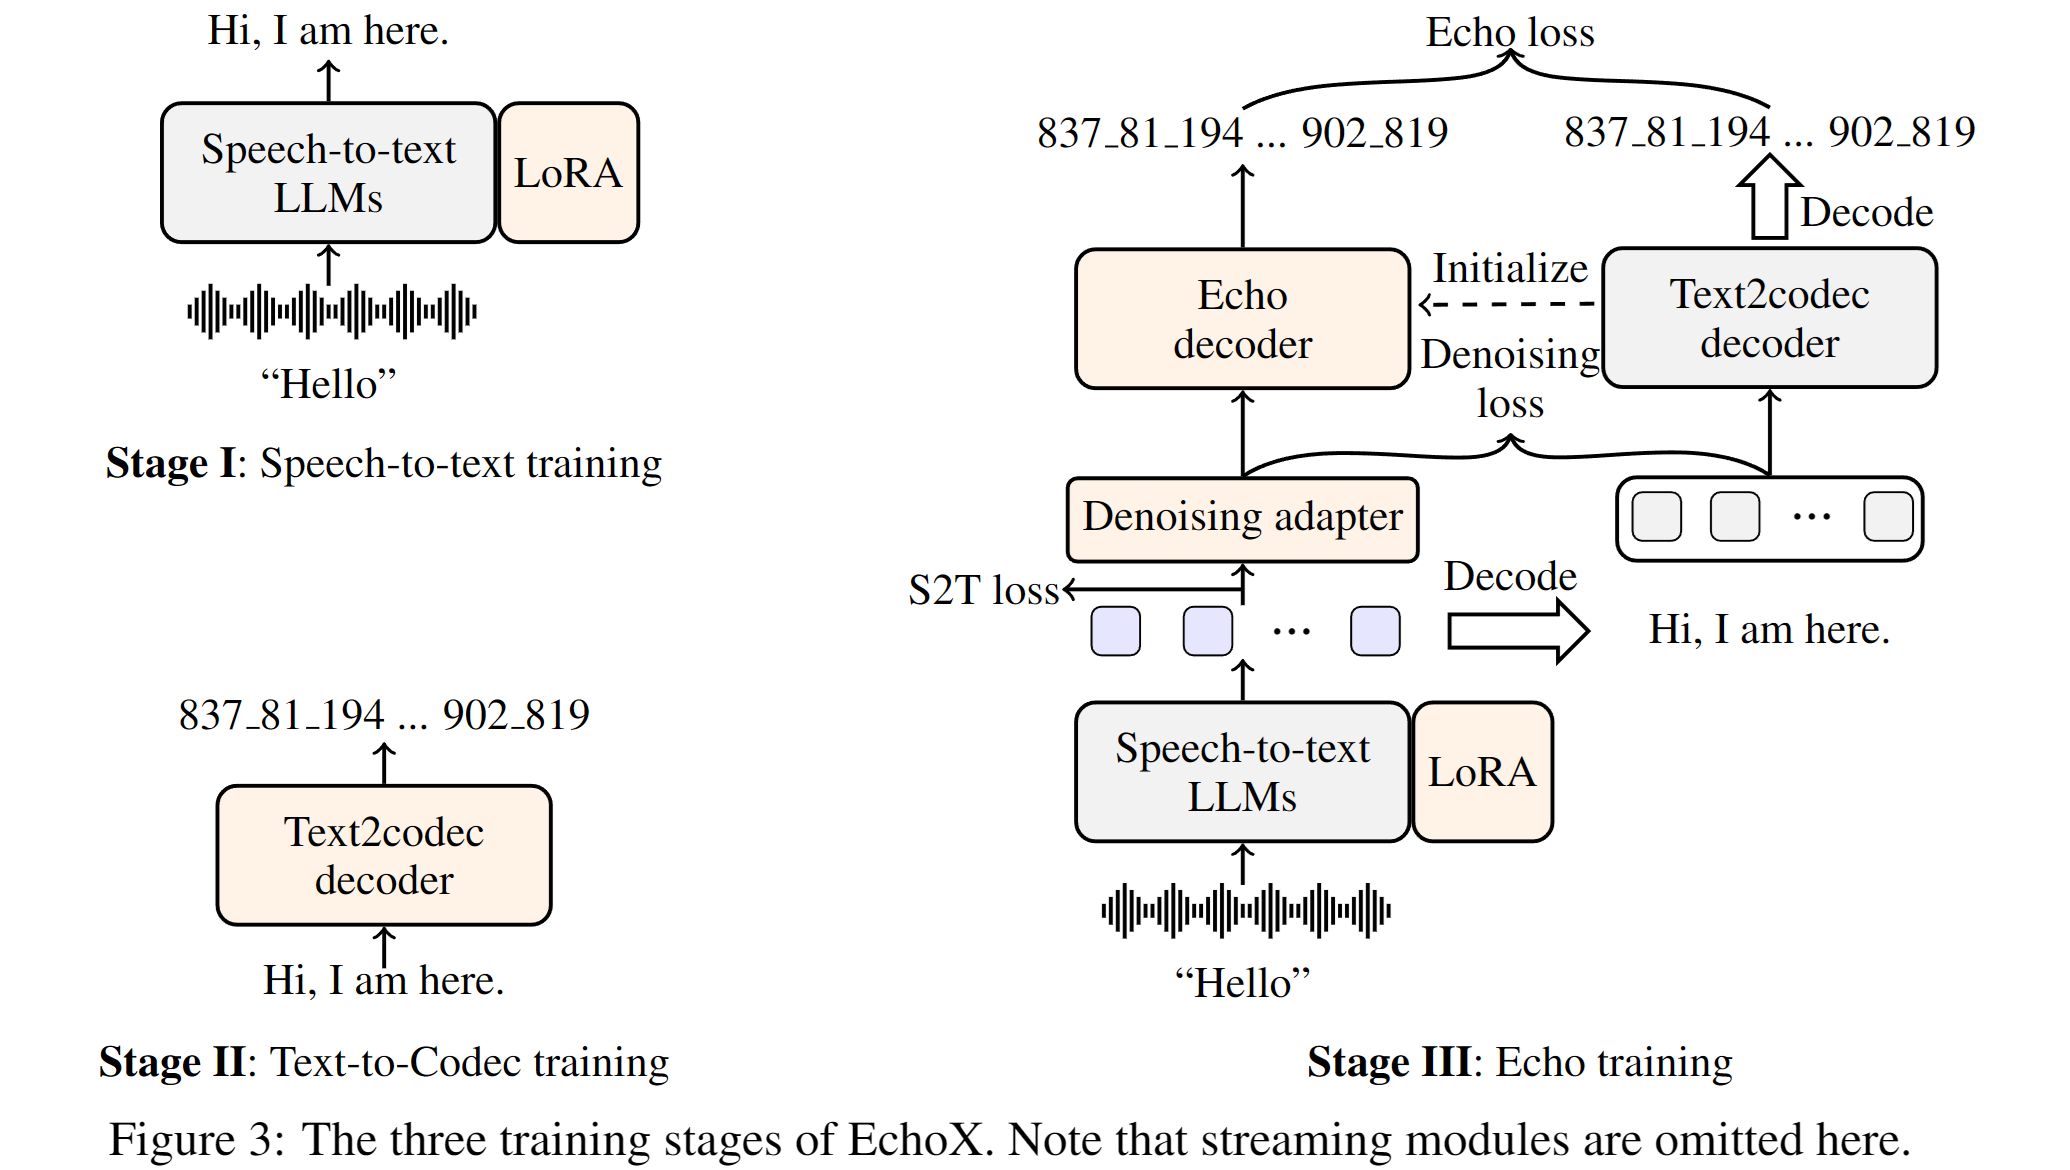
先让模型学到清晰的语义表征,再由一个Echo解码器把语义动态回声为语音token,同时追求“说得像”与“说得对”。为此,EchoX构建了语义→文本→语音token的“伪标签”链路,用这些伪标签直接监督Echo解码器把隐藏语义“说出来”;并在送入解码器前加一层去噪适配器,对齐表示、降低“语义→语音”转写误差。
⏩三阶段训练
Stage I|Speech→Text(先听懂):将文本LLM适配为S2T,对话式地学“语义理解”。Stage II|Text→Codec(学会说):训练T2C发声器,把文本转成语音token;同时构建unit language(比原始unit更短),将序列长度近乎减半,减少长序列误差累积。Stage III|Echo训练(语义直接说):用S2T产生的隐藏状态H,先贪心得到文本→经冻结的T2C发声器得到伪语音token→以此监督Echo解码器;并与去噪/对齐、S2T文本监督组成“三损失”多任务学习,同时对齐语义与发声。推理阶段加入相似度“流式触发器”决定“读/写”时机,带来低延迟的流式合成、更流畅的交互体验。
⏩成绩怎样?用更少参数和数据打出“高性价比”
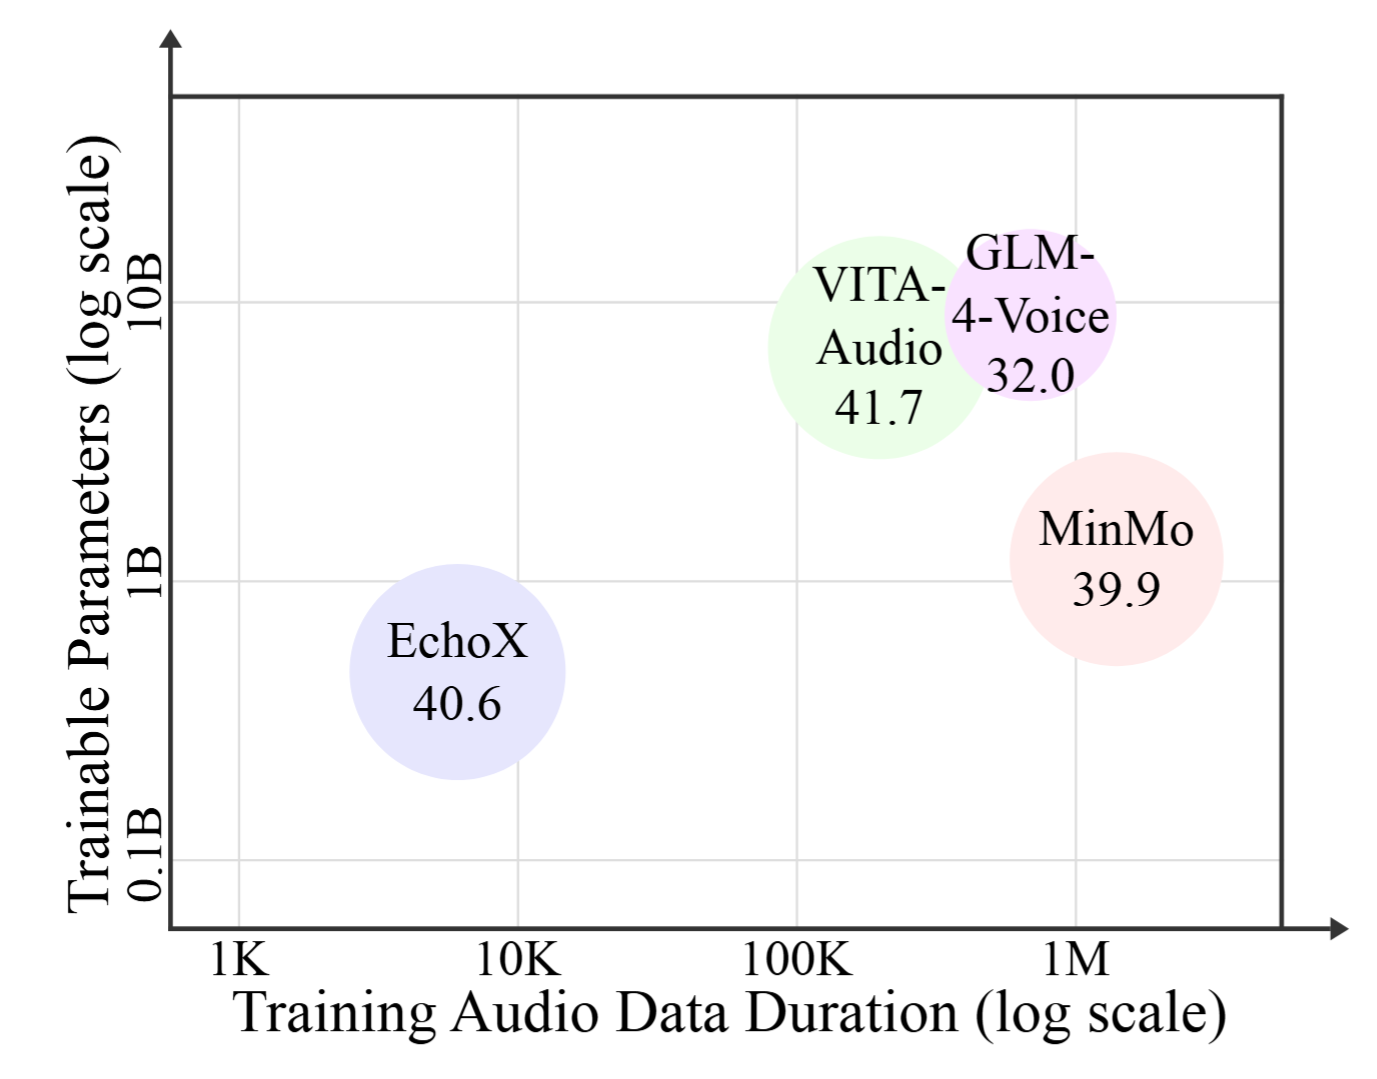
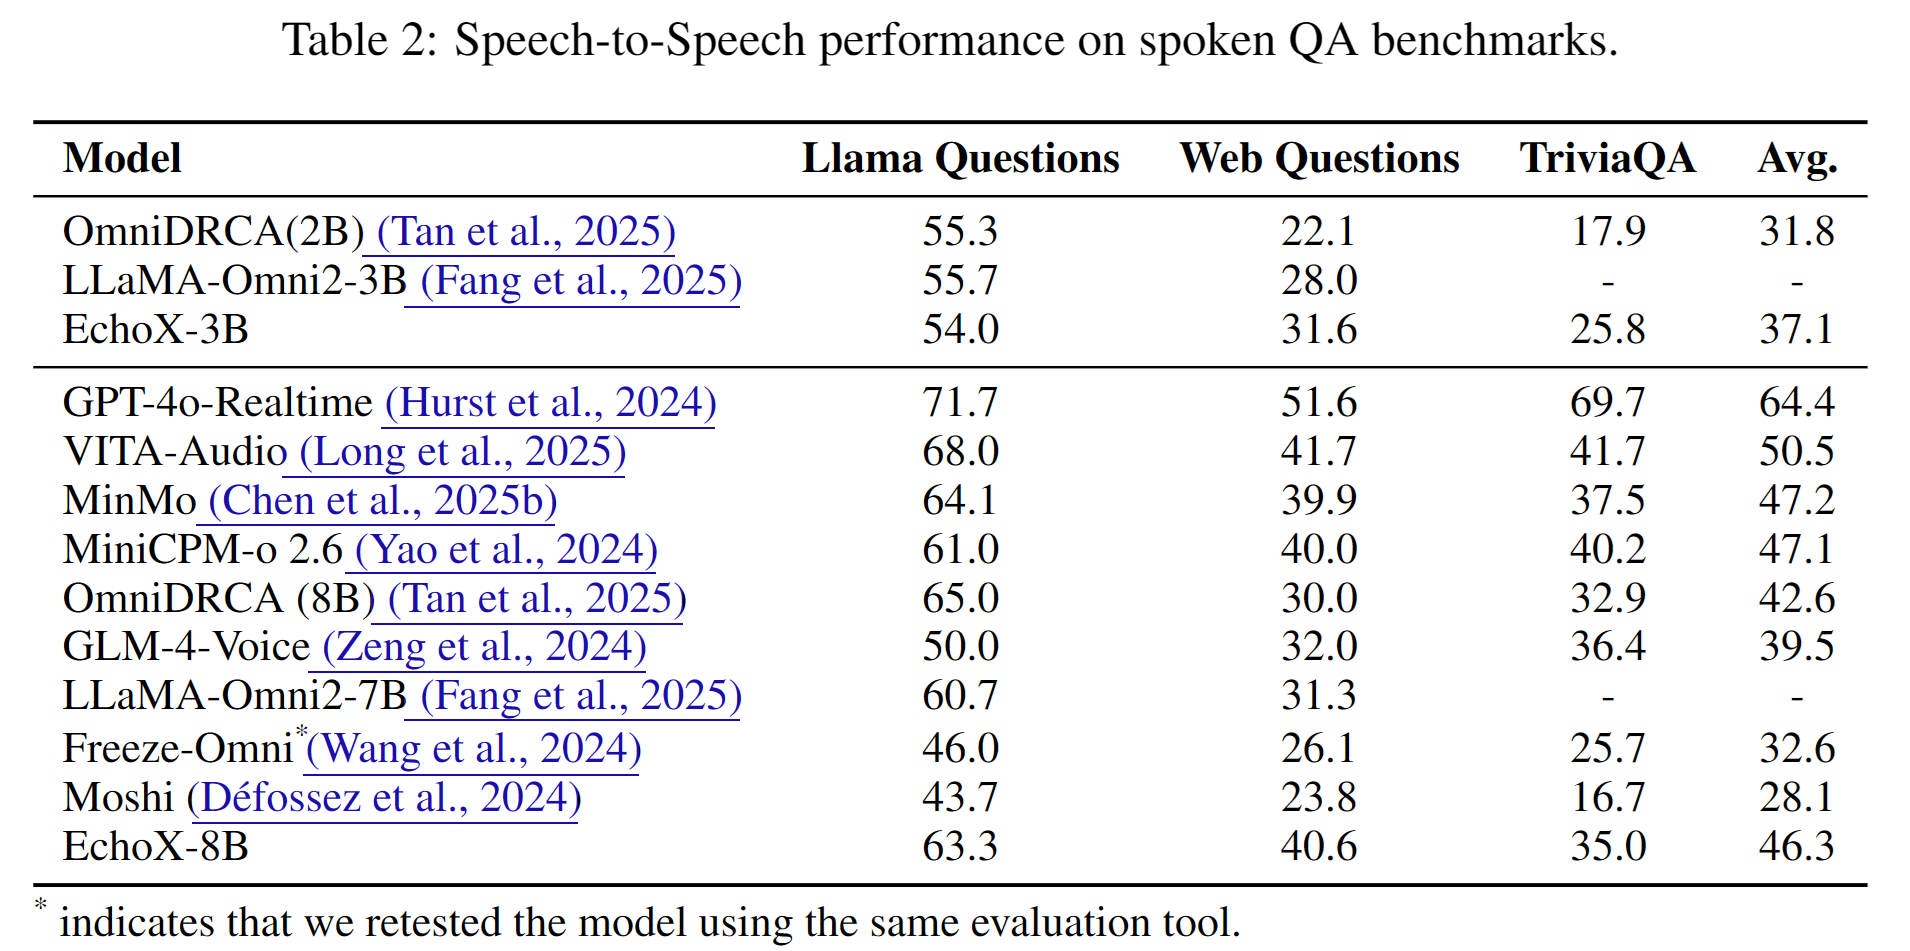
S2S(语音问答):EchoX-8B在Web Questions 40.6、TriviaQA 35.0,接近/超越多款同量级方法;EchoX-3B也有31.6 / 25.8的稳健表现。
流式延迟:以“tokens”为单位的延迟显著降低,3B量级从~138降到~27,且精度不明显受损。
⏩为什么它能“保智商”?
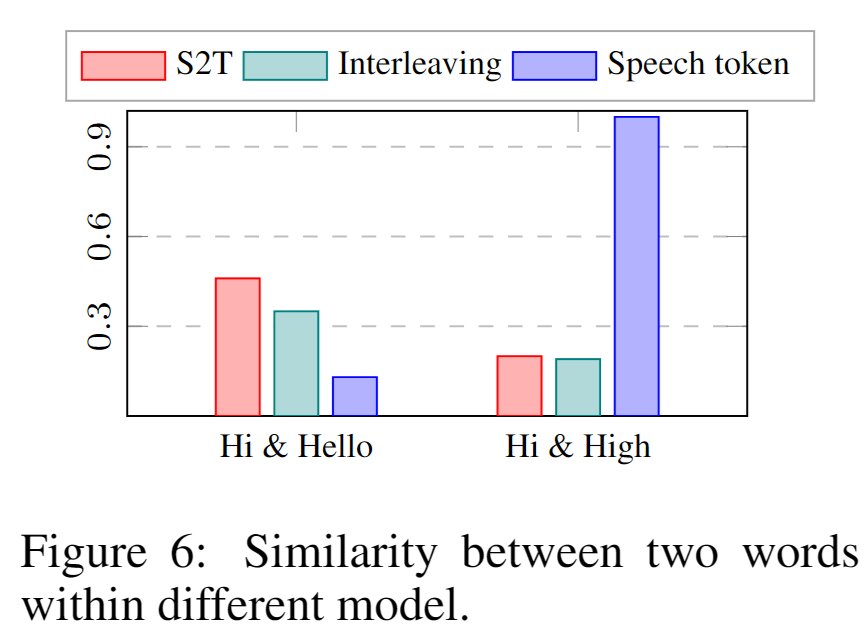
直觉上,把“说得像”当唯一目标,会让模型在“口型对就好”的方向发力;而EchoX把“说得像”建立在“想得对(语义对)”之上:先稳住语义,再用Echo解码器按语义去组织发音,加上去噪与更短更稳的unit language,知识与推理不再被声学目标绑架。
⏩结语
EchoX的价值不在“把声音合成得多像人”,而在于它重新让语音大模型把“内容正确”放在“声音正确”之前。这一步,可能正是“会聊天的语音助手”走向“会思考的语音助手”的关键拐点。
⏩开源与资源
模型(Hugging Face):
数据集(Hugging Face):
EchoX-Dialougues:
EchoX-Dialogues-Plus:
在线体验:
⏩前置工作参考
Soundwave: Less is More for Speech-Text Alignment in LLMs:https://arxiv.org/abs/2502.12900
Leveraging Unit Language Guidance to Advance Speech Modeling in Textless Speech-to-Speech Translation:https://arxiv.org/abs/2505.15333
