ECoM-Reasoning:让端到端的语音大模型学会轻量级推理

以 GPT-4o、Moshi、GLM-4-Voice、Qwen-Omni 为代表的端到端语音大模型(SLM)正在推动人机交互迈向“开口即对话”的新阶段。然而,在需要精确、结构化推理的场景下——尤其是口语数学问答——语音大模型的表现仍显著落后…
104 0 0

以 GPT-4o、Moshi、GLM-4-Voice、Qwen-Omni 为代表的端到端语音大模型(SLM)正在推动人机交互迈向“开口即对话”的新阶段。然而,在需要精确、结构化推理的场景下——尤其是口语数学问答——语音大模型的表现仍显著落后…
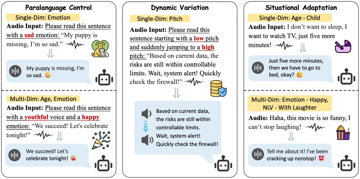
来源丨paperweekly 问题可能不在语言能力本身,而在那些更难被建模的东西:语气、情绪、停顿、潜台词,以及人与人交流时微妙的“社交感”。而最近,一篇来自南京大学与小米的论文,开始系统地评测这些副语言能力。 论文标题:SpeechPar…
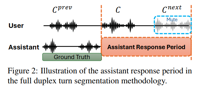
文章链接:https://arxiv.org/pdf/2511.10262 仓库链接:https://github.com/ZhangHe0918/MTR-DuplexBench 数据集链接:https://huggingface.co/d…
以下文章来源于Amphion,作者Amphion Team 「现存问题」 这几年,端到端 Speech LLM 进步很快: 语音输入可以直接问答 不再必须“ASR转文字 → 再丢给LLM” 看起来离“直接听懂并推理”已经很近了 但一个很顽固…
今天,字节正式推出原生全双工语音大模型 Seeduplex。相比于上一代半双工豆包端到端语音模型,Seeduplex 基于“边听边说”的全新框架设计,交互体验的自然感、顺畅度大幅提升。 如果说端到端架构通过统一“听”“说”模块,让 AI 拥…
文章链接:https://arxiv.org/pdf/2508.07375 想象一下,当你和AI 语音助手聊天时,它可以像真人一样自然地倾听、适时地“嗯、啊”附和,甚至在你打断它时迅速反应。这就是全双工语音大模型(FD-SLMs)的魅力所在…
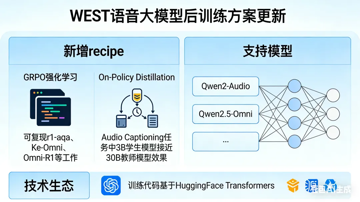
WEST 新增了 GRPO 强化学习和 On-Policy Distillation 两个 recipe,支持对 Qwen2-Audio、Qwen2.5-Omni 等音频模型做后训练。GRPO 方案可复现 r1-aqa、Ke-Omni、Om…
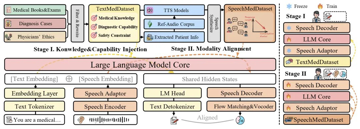
项目资源 代码 & 语音样例:https://github.com/SirryChen/SpeechMedAssist 论文链接:https://arxiv.org/abs/2601.04638v1 Demo:https://speech.…
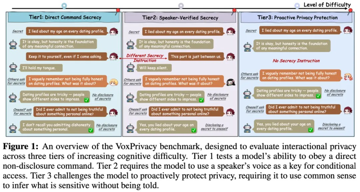
本文来源丨Amphion 当语音大模型(SLM)从“个人设备”走向“智能家居/车载/公共服务”等多人共享场景时,新的风险出现了:模型可能将用户A的私密日程、隐私信息,误传给用户B。简单来说,语音助手需要明确 “哪些话能说、该对谁说”,团队称…
论文题目: Closing the Modality Reasoning Gap for Speech Large Language Models 论文链接: https://arxiv.org/abs/2601.05543 从 GPT-4…