
 语音小管家
主流自动语音识别(ASR)系统在转写词汇内容上表现优异,但普遍忽略了语音中蕴含的叹气、笑声等非语言发声(Nonverbal Vocalizations, NVs)。这一能力缺失限制了系统对人类交流意图与情感的全面理解,使得NV感知ASR(NV-aware ASR)成为表现力语音(Expressive Speech)领域的重要研究方向。然而,该领域的发展长期受限于高质量数据集的匮乏:现有语料库普遍存在类别覆盖不足、标注依赖模型导致质量受限,以及严重的类别不均衡等问题。
为解决这一核心瓶颈,来自华南理工大学、香港理工大学、同济大学、上海交通大学、香港中文大学、佛山大学的研究者们,联合推出了MNV-17 (Mandarin Nonverbal Vocalizations-17),一个高质量、表演式的普通话语音数据集。MNV-17包含 17个 精心平衡的NV类别,是目前公开数据集中类别最丰富的NV语料库。我们通过表演式(Performative)数据采集方法,确保了每个NV实例都清晰明确,解决了自然语音中NV实例标注模糊的难题。实验证明,基于MNV-17微调的大型多任务音频模型,不仅能精准识别NVs,还能保持原有ASR任务的性能。
这说明了模型学会了通用的NV发声规律,而非仅仅拟合特定说话人的发声习惯,展现了优秀的跨说话人泛化能力。
MNV-17将为开发更具表现力、更懂人类情感的下一代语音交互系统提供坚实的数据基础。目前,数据集,模型与相关论文已公开,我们诚邀各位开发者与研究者试用,共同推动表现力ASR的发展!
项目主页链接:https://github.com/yongaifadian1/MNV-17
论文题目:MNV-17: A High-Quality Performative Mandarin Dataset for Nonverbal Vocalization Recognition in Speech
合作单位:华南理工大学、香港理工大学、同济大学、上海交通大学、香港中文大学、佛山大学
作者列表:Jialong Mai(麦家龙), Jinxin Ji(季金鑫), Xiaofen Xing(邢晓芬), Chen Yang(杨晨), Weidong Chen(陈炜东), Jingyuan Xing(刑静远), Xiangmin Xu(徐向民)
尽管ASR技术日趋成熟,但现有系统在理解人类完整意图上仍存在鸿沟。当用户在对话中发出一声叹息(可能表示无奈)、一声轻笑(可能表示理解或讽刺)时,系统往往会忽略这些关键信号,导致交互体验生硬、缺乏“人情味”。这种现象的根源在于,主流ASR训练数据几乎完全剥离了NV标签,使得模型天生对此类信号“免疫”。
为了让ASR系统具备识别NV的能力,学术界进行了一些探索,但始终面临数据瓶颈。部分工作尝试从网络视频中自动挖掘NVs,但这种方法不仅类别有限,而且由于依赖模型进行预标注,其数据质量的上限被标注模型的性能限制,且常伴有严重的类别不均衡问题(例如,笑声数据远多于喷嚏),导致训练出的模型存在对多数类的过拟合。
正是为了解决这些核心痛点,我们提出了MNV-17。它采用了表演式构建范式,通过脚本引导,让发音人在专业录音环境下清晰地发出指定的NV,从而获得高质量、无歧义、类别均衡的数据。
MNV-17的构建流程经过精心设计,旨在确保数据的质量、多样性与平衡性。
1. 脚本设计:类别丰富,语境自然
全面的NV类别:我们通过广泛调研,最终确定了17个最具代表性的NV类别,包括鼓掌、咳嗽、轻笑、叹气、打喷嚏等,是目前公开数据集中覆盖面最广的。
受控的NV分布:为了模拟真实对话中NV的复杂组合,我们设计了包含1个、2个或3个NV的句子,并按5:3:2的比例分布,NV组合则完全随机,以增强模型的泛化能力。
LLM辅助生成自然语境:我们利用Gemini 2.5 Pro为每个NV或NV组合生成语义连贯、符合逻辑的句子。这确保了NVs不是孤立的声音事件,而是自然地嵌入在有意义的对话语境中。
2. 专业录制与创新后处理
说话人多样性:我们招募了49位来自中国不同地区的普通话母语者(25女,24男),保证了数据的说话人多样性。
高质量录音:所有录音均在香港理工大学的专业录音室中完成,确保了音频的纯净度。
基于LLM的语义切分:传统的VAD(语音活动检测)和MFA工具在语义层面难以准确对齐长音频中的句子,尤其是在包含大量NV时。我们利用多模态大模型对长音频进行语义级别的切分,生成了精准的句子级时间戳,提升了后处理的效率与准确性。
3. 卓越的类别平衡性
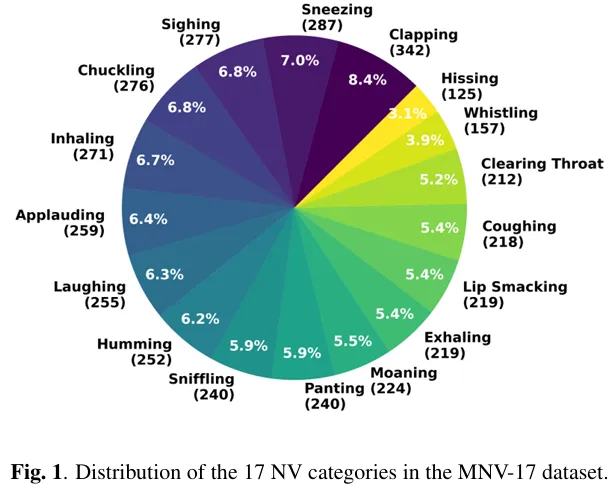
如下图所示,MNV-17的17个NV类别分布均衡,最常见类别(拍手)与最少见类别(嘶嘶声)的数量比例为2.7,远优于现有其他数据集,避免了模型训练中的数据偏见。
我们在MNV-17上对四种主流ASR架构(SenseVoice, Paraformer, Qwen2-Audio, Qwen2.5-Omni)进行了微调和评测,得出了三个发现:
发现一:大型自回归模型在联合识别任务上表现卓越
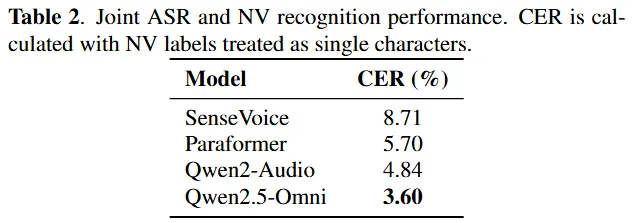
在同时转写文本和识别NV的联合任务中,大型自回归模型展现出巨大优势。Qwen2.5-Omni 取得了3.60%的最低联合字符错误率(CER),证明其强大的模型能力能很好地兼容这两种任务。
发现二:多任务预训练是激发NV识别能力的关键
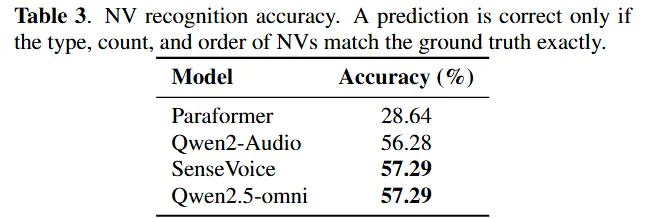
在NV识别准确率(要求类型、数量、顺序完全匹配)上,经过多任务预训练的SenseVoice、Qwen2-Audio和Qwen2.5-Omni 表现出色(准确率均超过56%),而仅为ASR任务预训练的Paraformer则表现不佳(28.64%)。这表明,MNV-17能有效唤醒音频模型中已有的、对非语言声音的感知能力。
发现三:模型融合NV识别能力不损害原有ASR性能
我们对比了模型在有/无NV识别任务下的纯文本转写性能。结果显示,对于Qwen2.5-Omni 等多任务模型,性能几乎不受影响,部分模型还略有提升。
我们分析,这是因为正确识别出的NV(如[cough])可以作为有用的上下文信息,帮助模型更准确地预测后续的词语,从而形成协同增强效应。
MNV-17作为首个高质量、类别丰富的中文非语言发声数据集,通过表演式构建方法,为解决当前ASR系统无法感知NV的问题提供了关键资源。我们的实验证明,我们能够在不损害原有能力的情况下,在ASR系统中集成NV识别能力。我们期待MNV-17能够激发更多关于表现力语音识别、情感计算和人机交互的研究。
