
 语音小管家
来源丨乐百一家
论文题目:《Speech-Aware Long Context Pruning and Integration for Contextualized ASR》
论文地址:https://arxiv.org/pdf/2511.11139
作者是中科院自动化所和中国科学院大学的团队,核心是提出了一个叫SAP²的框架,专门解决长上下文场景下自动语音识别(ASR)又慢又不准的问题,代码还开源了,地址是 github.com/jymh/SAP2-ASR,想复现的朋友可以直接冲。
01、为啥要做这个研究?
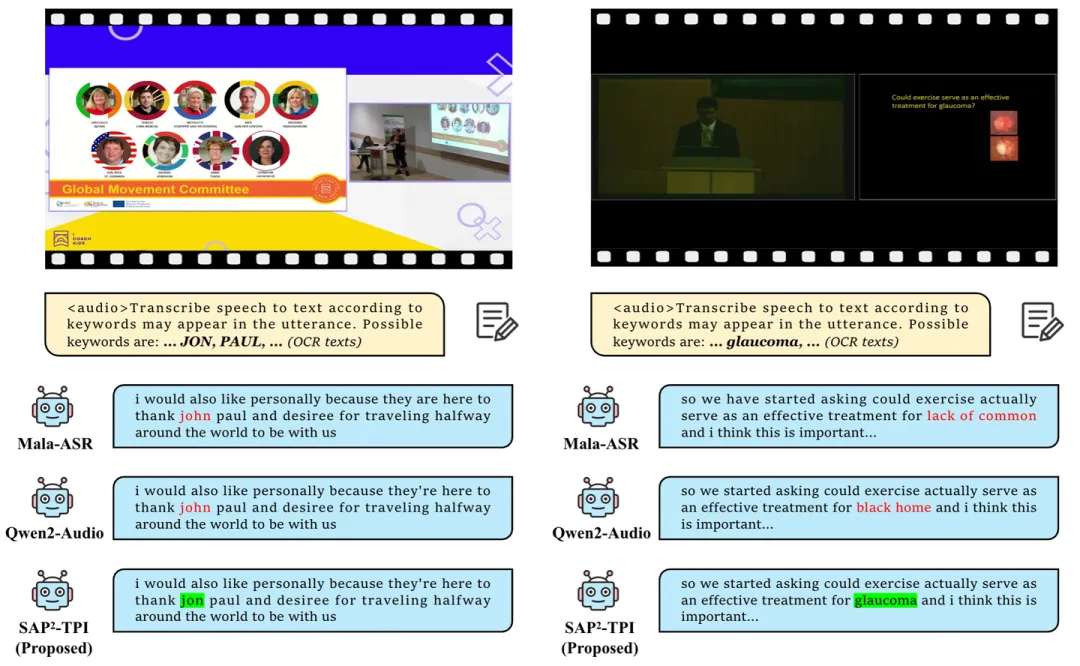
左边是“少见人名”识别,右边是“医学术语”识别,红色字是模型认错的专有名词,绿色字是TPI修正的。能明显看到,MaLa-ASR和Qwen2-Audio-PC经常把人名、术语拼错,而TPI能精准修正,说明它在“领域专有名词”识别上的优势。
深度偏置端到端(bias-E2E)模型:靠注意力影响解码,但性能不如预训练大模型,而且架构改起来麻烦; SpeechLLM模型:把上下文当提示词用,灵活是灵活,但处理长文本和滤噪声的能力不行。
02、SAP²到底是怎么工作的?
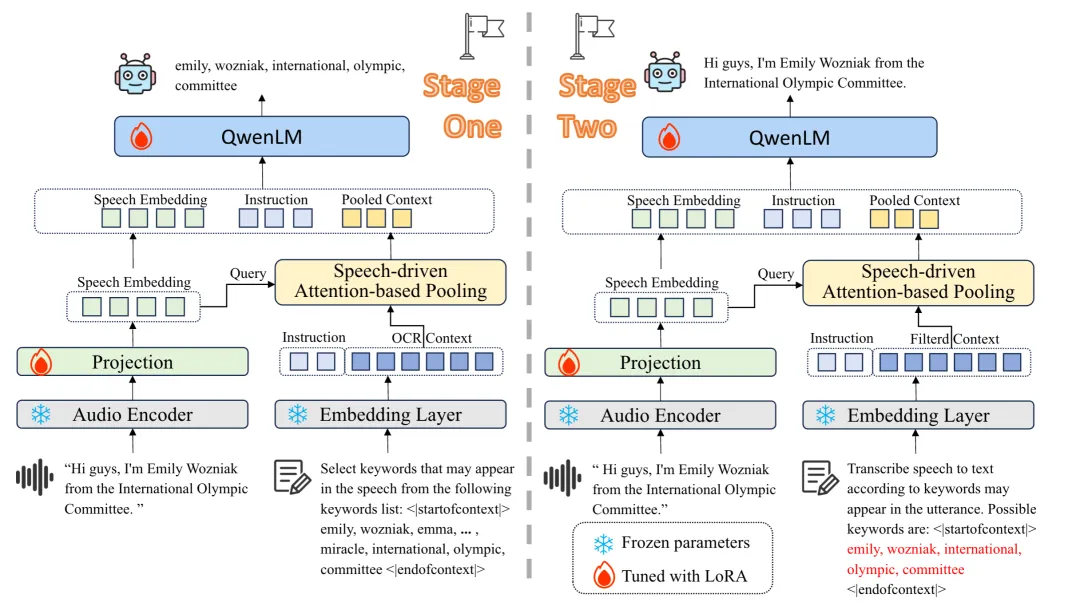
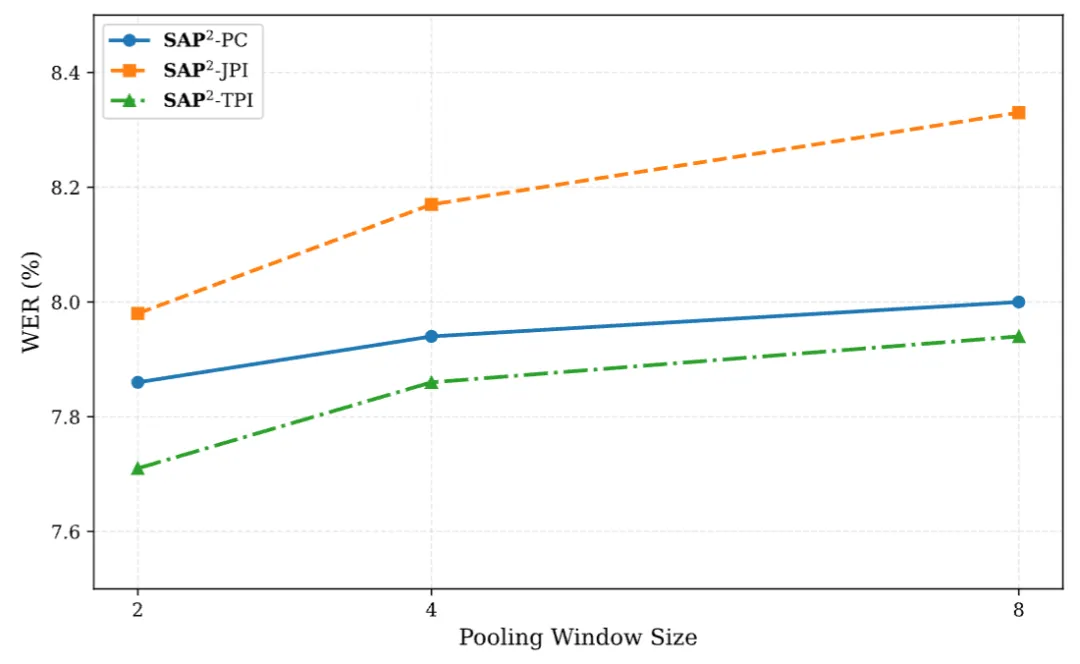
先把语音X转成语音embedding hx,把上下文Z转成文本embedding hz; 算hx和hz的多头交叉注意力得分——得分高的文本token,说明和语音更相关; 按固定窗口(默认2个token为一个窗口)对得分加权后的hz做“池化”,比如原来100个token,池化后变成50个,既压缩了长度,又没丢关键信息。
03、实验做得怎么样?
SlideSpeech:会议演讲场景,上下文是幻灯片OCR文本,分S95(161小时)和L95(473小时)训练集,还特意做了“1-slide”和“5-slide”的对比,看长上下文的影响; LibriSpeech:有声书场景(通用领域),上下文是动态建的“偏置词表”,训练集分train-clean(460小时)和train-other(500小时)。
WER(词错误率):整体识别准不准; B-WER(偏置词错误率):上下文里的关键词识别得怎么样(最核心,毕竟剪枝就是为了关键词); U-WER(无偏词错误率):非关键词的识别率,看模型基础能力没丢; 召回率:关键词有没有被完整保留下来。
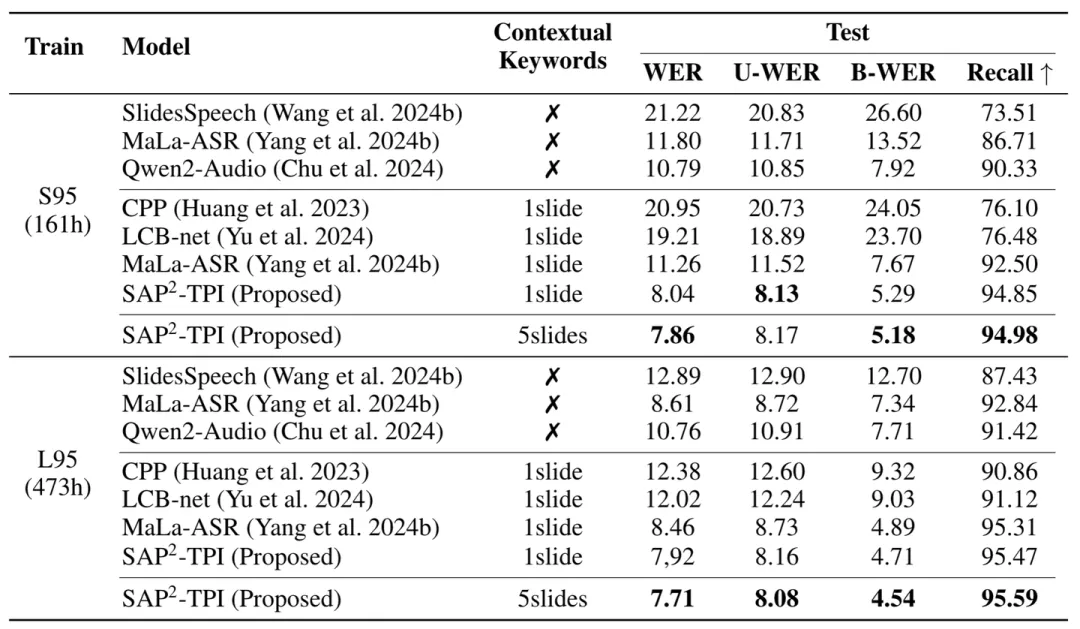
5-slide上下文时,WER低到7.71%,比之前的SOTA(MaLa-ASR)在S95/L95上的WER分别降了30.19%和10.45%; 关键词识别超给力:B-WER比“不掺上下文的基线”降了41.1%,召回率还能保持95.59%(剪枝没把有用的关键词弄丢); 长上下文鲁棒性:从1-slide加到5-slide,WER一直降,没出现“文本越长性能越差”的情况。
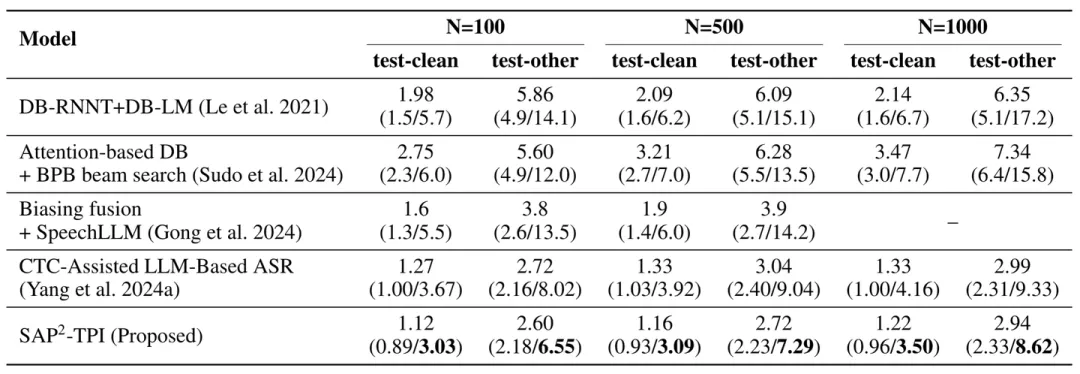
test-clean子集最低WER1.12%,比之前的SOTA(Gong et al. 2024)在N=100(偏置词100个)时降0.48%,N=500时降0.74%; 极端情况也能打:偏置词从100个加到1000个(翻10倍),test-clean的WER只升了0.1%,说明处理大量上下文时很稳定。
TPI(两阶段,SAP²的核心); PC(直接把Z和X拼一起,不剪枝); JPI(把“剪枝”和“ASR”放一个模型里联合训练)。
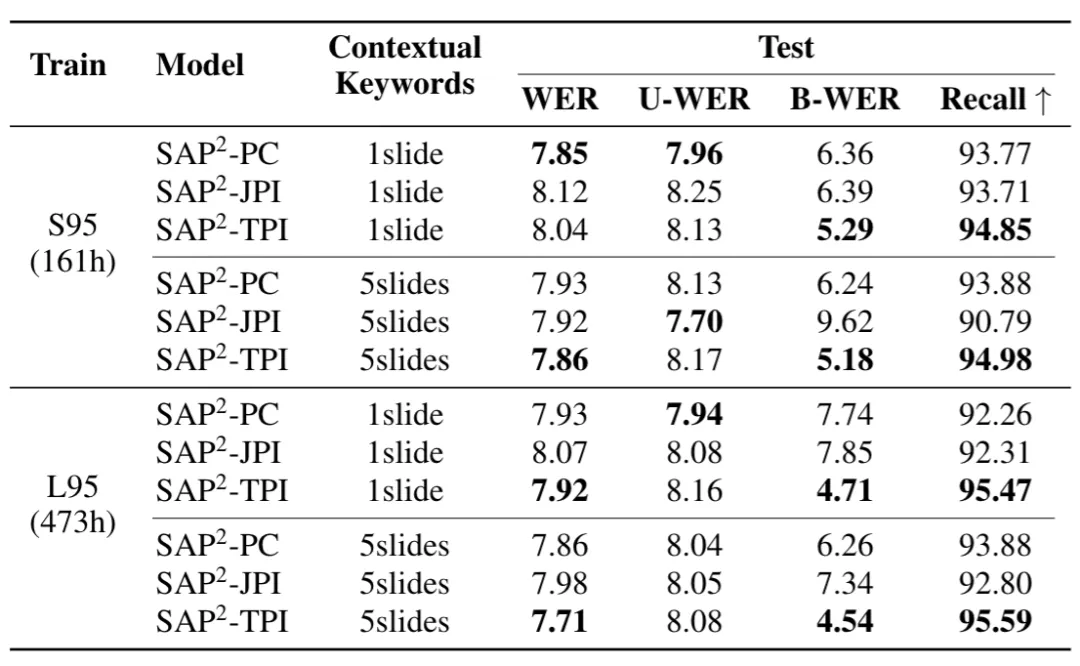
TPI的B-WER最低,比如L95 5-slide场景,TPI的B-WER是4.54%,比PC低1.72%,比JPI低2.8%; JPI因为要同时干“剪枝”和“识别”,两个目标打架,关键词筛选的F1-score只有21.19%,而TPI有94.48%(差了4倍多)。
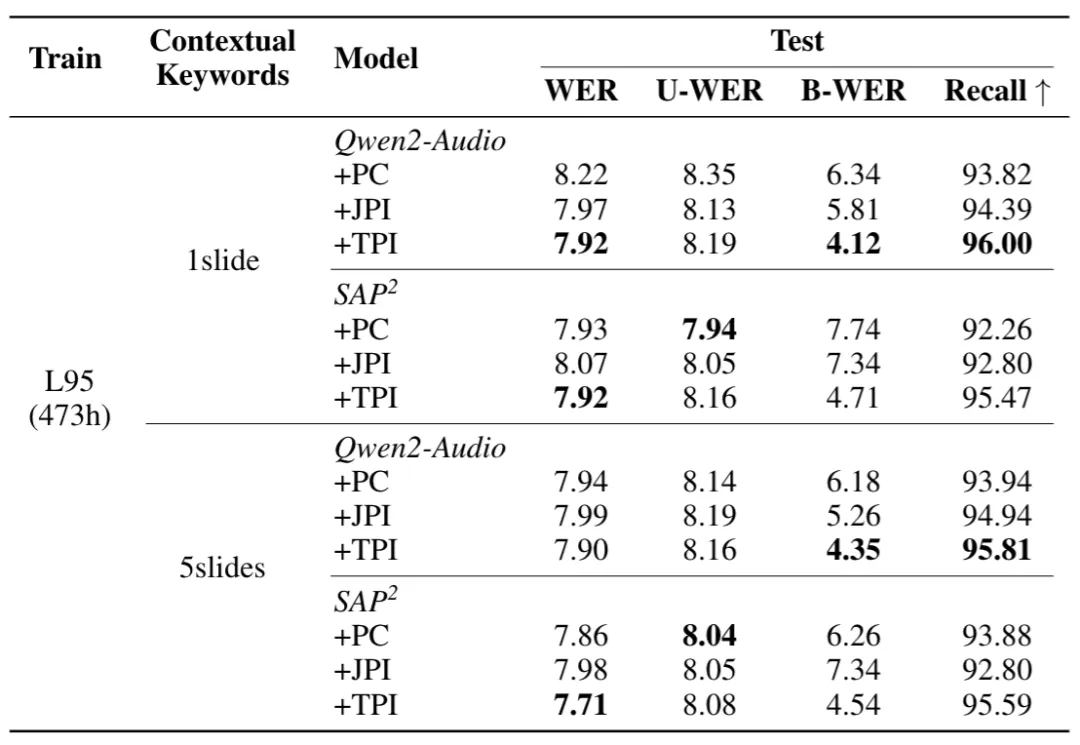
加了之后,TPI和PC的WER都降了,而且上下文越长(比如5-slide),效果越明显; 效率也提升了:TPI的训练时间比没加池化的Qwen2-Audio-TPI少24.97%,推理时间少20.20%,又快又准。
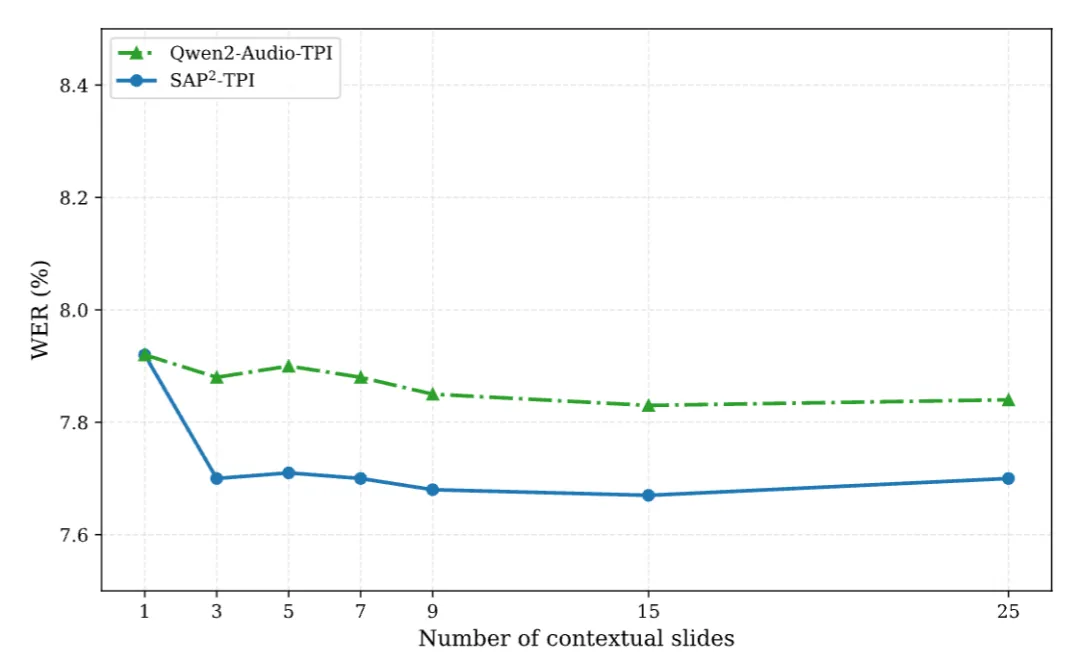
当slide数量>3时,TPI就开始比基线(Qwen2-Audio-TPI)好; 到25-slide时,平均token长度都到1562.73了,WER还是很稳定,没崩,说明对超长上下文的适应能力很强。
04、总结和未来计划
搞了个“语音感知剪枝框架”,能让SpeechLLM自动挑出和语音相关的关键词,解决长文本“吞不下”的问题; 提出“语音驱动注意力池化”,既能压缩上下文,又不丢关键信息,平衡了 accuracy和效率; 在两个数据集上都刷新了SOTA,而且长上下文场景下性能很稳。
现在剪的是“单个关键词”,以后想试试“短语级”的语义上下文(比如“sriracha sauce”这种词组,而不是单独的“sriracha”); 想把幻灯片的“图像信息”也加进来,搞多模态整合(毕竟幻灯片不只有文字,还有图); 进一步优化极端长上下文(比如100页幻灯片)的性能。
