
 语音小管家
论文标题:ParaS2S: Benchmarking and Aligning Spoken Language Models for Paralinguistic-aware Speech-to-Speech Interaction
论文地址:https://arxiv.org/pdf/2511.08723
发表时间:2025年11月13号
项目主页:https://paras2sbench.github.io
01、研究背景:现有语音对话模型的“尬聊”问题
副语言被无视:模型只抓文字意思,不管语音里的“隐藏情绪”;
没好的评估标准:以前的基准要么只看文本回复,要么只测基础语音理解,没人直接评估“输入语音→输出语音”的内容和风格配不配;
数据太少太贵:要做带副语言标注的语音对话数据,得雇人标情绪、录带风格的语音,成本高到用不起,模型没数据练自然不行。
02、核心框架:ParaS2S——一边评一边调的解决方案
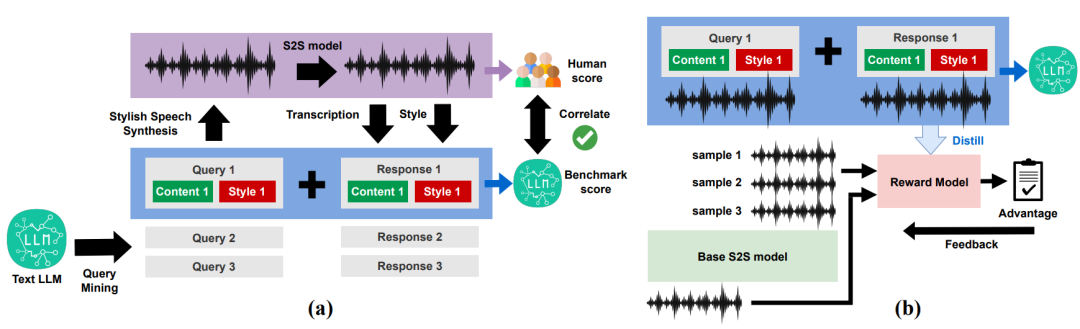
左图(a)是ParaS2SBench流程:从生成测试语音,到提取内容/风格,再到GPT评分,一步一步很清晰; 右图(b)是ParaS2SAlign流程:分SFT热身、蒸馏奖励模型、GRPO后训练三阶段,每个阶段的输入输出都标得很明白,能快速看懂整个调优逻辑。
端到端评语音:不绕弯子,直接拿输入语音和输出语音对比,既看内容对不对,也看风格配不配;
对比式风格:同一个文本内容,配两种相反风格(比如“遇到前任”配“惊讶”vs“悲伤”),逼模型必须听语音,不能靠文字猜;
文本要中性:比如“社区要建商场”,光看文字看不出情绪,模型只能靠语音里的副语言线索做回复。
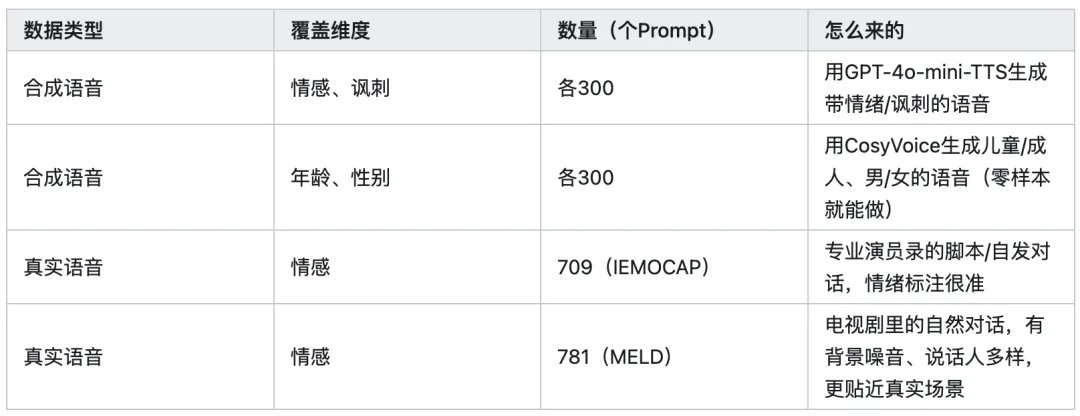
提信息:用Whisper-v3把输出语音转成文字(看内容对不对),用AudioReasoner(基于Qwen-Audio 2)提取输出语音的风格(比如“悲伤、正式”);
送GPT评分:把“输入内容+输入风格+输出内容+输出风格”喂给ChatGPT 4.1,按人工定的准则(1-5分,5分最好)打分;
出结果:这个分数就能当后续强化学习的“反馈信号”——分高说明模型做得好,分低就改。
按ParaS2SBench的逻辑,造10k组“输入语音→输出语音”数据(总共100小时);
让ChatGPT生成配输入风格的回复文字和风格描述,再用GPT-4o-mini-TTS合成高质量输出语音(还得过滤掉识别不准的,人工筛一遍);
以Kimi-Audio为基础模型,训“输入语音token→输出语音token”的预测,得到一个初步会看副语言的模型(叫θ_sft)。
用阶段1的θ_sft,给10k个输入语音各生成32个不同回复,凑320k组“输入→输出”对;
用ParaS2SBench给这些对打分,造一个“偏好数据集”(分高的回复更优);
用LoRA微调Qwen2.5-Omni当奖励模型(叫φ),输入“输入语音+输出语音+评分准则”,就能直接输出1-5分,快多了。
找100k个无标注语音(只留波形,丢了文字和风格标签),用Whisper转文字做输入token;
给每个输入生成G个回复,用奖励模型φ打分,算“优势值”(哪个回复更好);
用GRPO调优θ_sft:鼓励生成分高的回复,加KL正则避免模型忘了基础聊天能力,最后得到终版模型。
03、实验:ParaS2S到底好不好用?
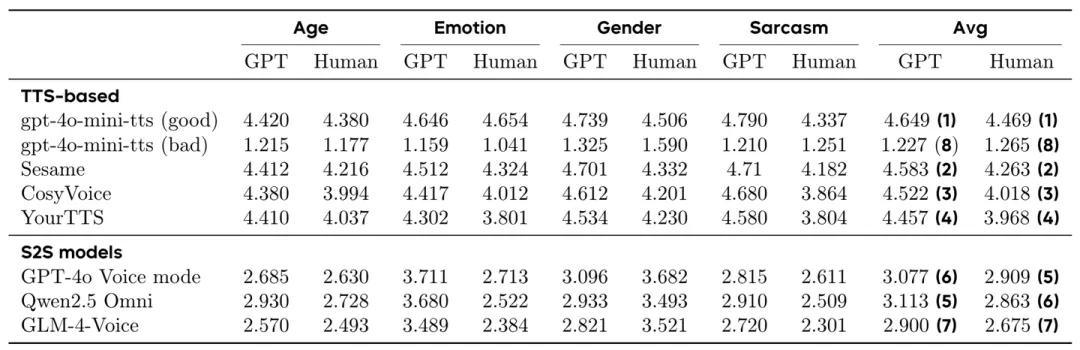
TTS模型(比如gpt-4o-mini-tts(god))分很高(GPT评4.649,人类评4.469),因为它们能精准控风格;
现有S2S模型(比如GPT-4o Voice、Qwen2.5 Omni)分都在3左右,说明它们确实不会看副语言;
所有模型的GPT评分和人类评分排名几乎一样,相关性超0.7,证明这个基准能代替人类打分。
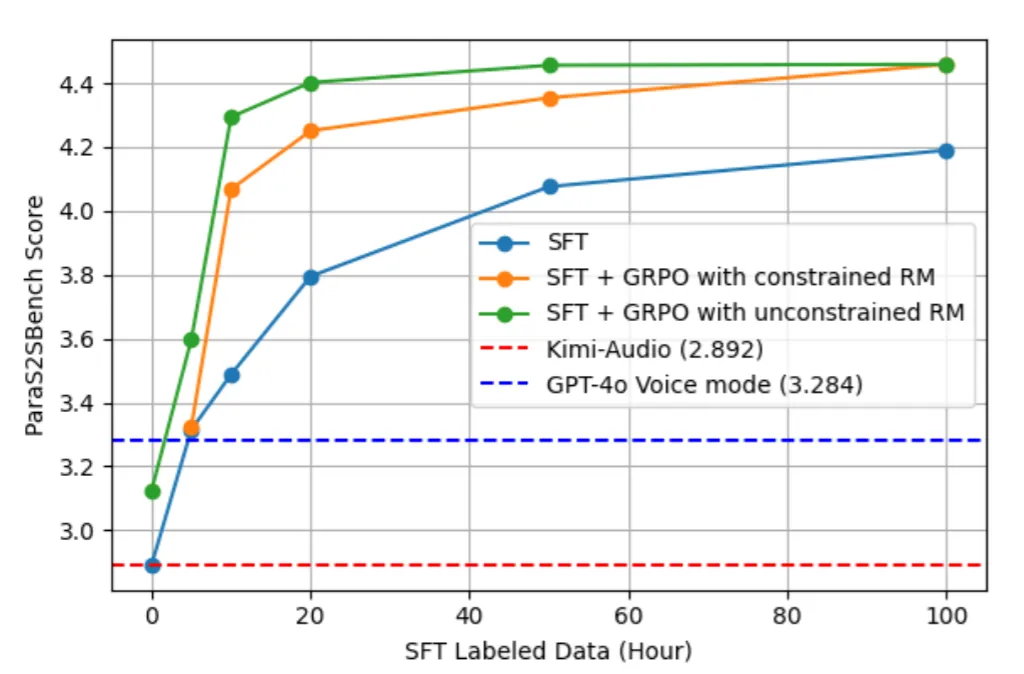
纯SFT虽然比现有模型好,但要大量数据才涨分;
RL(GRPO)不管用多少数据,都比同数据量的SFT好:10小时SFT+RL,就能追上50小时纯SFT的性能;20小时SFT+RL,能追100小时纯SFT;
必须先热身:直接用基础模型跑RL,根本学不会,因为生成的回复太差,没有效反馈。
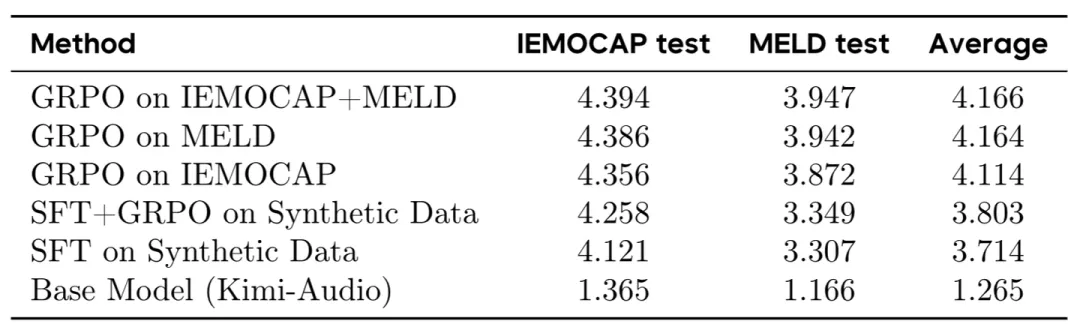
只用合成数据训的SFT+GRPO,在IEMOCAP(演员语音)和MELD(电视剧语音)上已经比现有模型好;
如果把真实语音加进RL训练,性能还能涨:比如“GRPO on IEMOCAP + MELD”在IEMOCAP得4.394分,MELD得3.947分,平均4.166,比纯合成数据训的高不少。
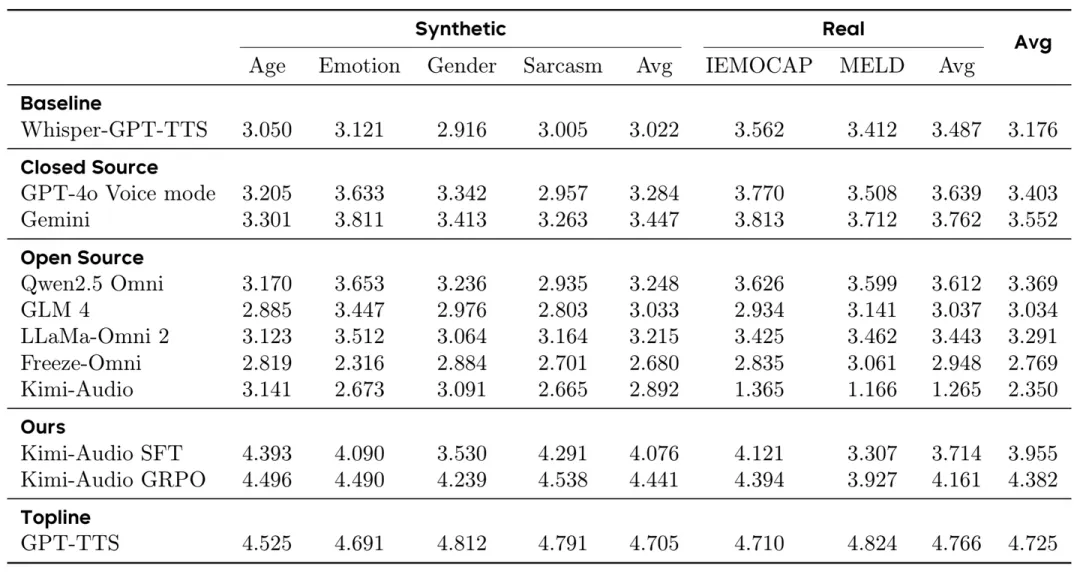
现有S2S模型(包括GPT-4o Voice、Qwen2.5 Omni)的分都不高,和“Whisper-GPT-TTS”(只转文字再合成语音,不管风格)差不多;
我们的模型(Kimi-Audio GRPO)在合成数据上平均4.441分,真实数据上平均4.161分,远超其他模型,还接近“GPT-TTS”(用了真实风格标签的上限模型)的水平。
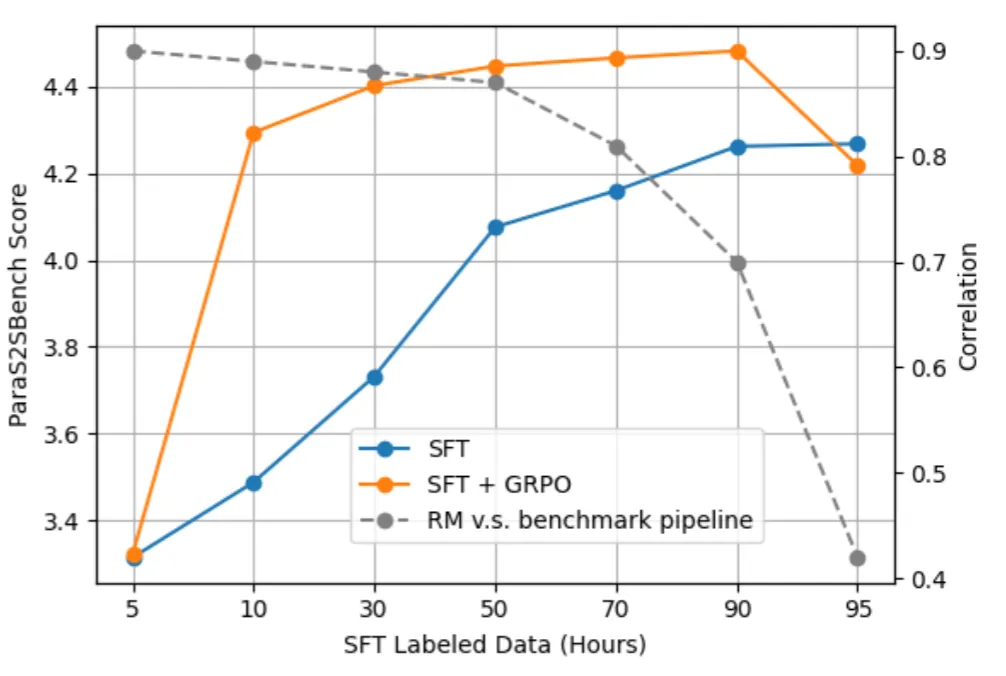
固定标注预算时,多给SFT数据,RL效果更好(因为热身模型质量高,生成的回复更有用);
奖励模型不用多的数据:只要10小时标注语音,就能训出和基准相关性>0.7的奖励模型,再多数据提升不大。
04、核心贡献:ParaS2S到底解决了什么问题?
首个副语言S2S基准:第一次实现“输入语音→输出语音”的端到端评估,还能暴露现有模型的“尬聊”问题;
首个RL调优框架:不用大量标注数据,靠“热身SFT+蒸馏奖励模型+GRPO”,让模型从无标注语音里学副语言能力;
数据效率超高:10小时标注数据+RL,就能追上50小时纯SFT的性能,解决了数据贵的痛点;
开源资源:会开放数据集、代码和模型,降低后续研究门槛。
05、结论
