
 语音小管家
论文题目:《SpeakerLM: End-to-End Versatile Speaker Diarization and Recognition with Multimodal Large Language Models》
咱们先通俗说下通义实验室这篇论文的核心目标:解决“说话人分割与识别(SDR)”任务,简单讲就是从音频里搞清楚“谁在什么时候说了什么”——比如会议转录、对话系统里都特别需要这功能。之前的方法总有各种坑,所以作者团队搞了个叫SpeakerLM的多模态大模型,主打端到端统一处理,还加了灵活的说话人注册机制,效果比之前的主流方法都好。
01、引言:为啥要搞SpeakerLM?
误差传递:SD要是标错了说话人边界或标签,ASR跟着错,最后转录结果就乱了;
处理重叠语音难:现实对话里经常有人抢话,但传统SD搞不定这个;
没联合优化:SD和ASR分开训,用的数据集、框架都不一样,没法发挥两者的协同作用。
02、相关工作:之前的方法差在哪?
传统说话人分割(SD):一般要三步——语音活性检测(VAD,找有声音的片段)、提取说话人embedding、聚类分组。后来有人用“神经网络说话人活性检测”代替VAD(比如Pyannote、Diarizen),能更好处理重叠语音,但还是没和ASR结合好。 SDR的三种架构(重点分析):
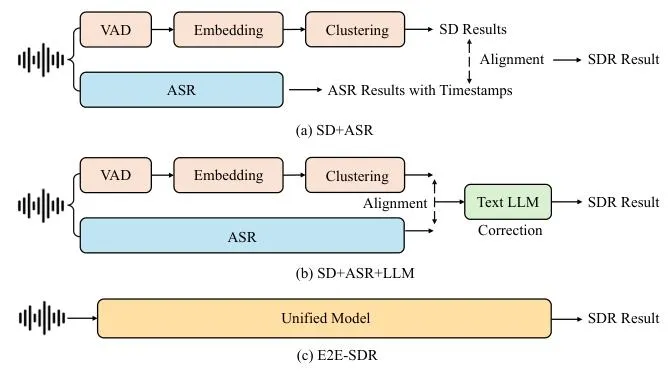
03、SpeakerLM核心设计:创新点都在这!
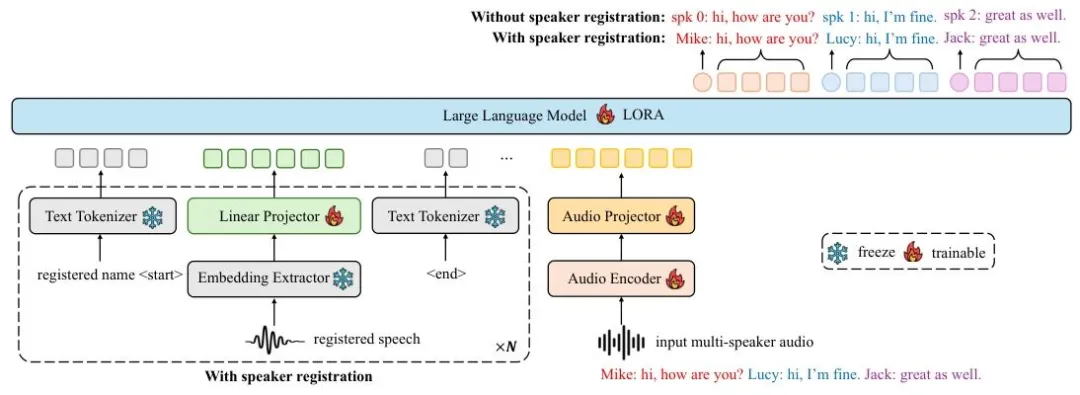
前端:用预训练的SenseVoice-large当“音频编码器”,把音频转成特征;再用一个两层Transformer+卷积的“音频projector”,把音频特征转到LLM能理解的空间里。 说话人注册模块:如果要注册说话人,先拿预训练的ERes2NetV2提取注册人的embedding,再用一个线性层projector转成LLM能接的格式;同时用文本tokenizer把注册人的名字、还有/标记转成token。 backbone:用Qwen2.5-7B-Instruct这个LLM,还加了LoRA(低秩适配),既能保留LLM的语言理解能力,又能高效微调。 输出差异:图2里能看到——有注册时,输出是“Mike: hi…”;没注册时,就用“spk 0: hi…”这种匿名ID,特别灵活。
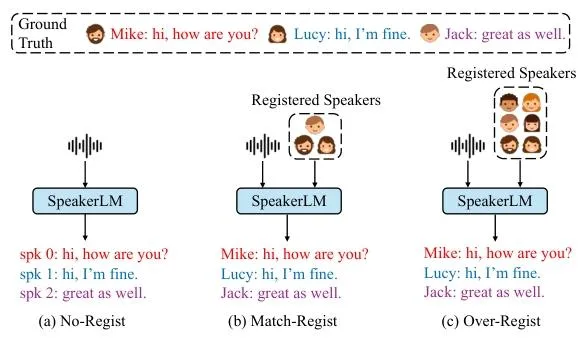
(a)No-Regist(无注册):不提供任何说话人信息,输出用匿名ID(比如spk 0、spk 1),和传统级联系统一样,适合不知道说话人是谁的场景;
(b)Match-Regist(匹配注册):注册的说话人数量和音频里实际的一样多,模型要把内容正确对应到名字上(比如图里“Mike、Lucy、Jack”都注册了,输出就标对名字),适合已知参会人的场景(比如公司会议);
(c)Over-Regist(过量注册):注册的人比实际说话人多(比如注册了10人,但只有3人说话),模型要排除没说话的人,只给实际说话人标归属——这特别贴近现实,比如企业系统里注册了很多员工,但每次会议只有少数人参加。 公式里也明确了:No-Regist时注册人数Nrg=0,Match-Regist时Nrg=实际说话人数Ngt,Over-Regist时Nrg=Ngt+多余人数Nov(N_ov>0)。
Stage1:只训ASR,得到“SpeakerLM-ASR”。用60万小时ASR数据,加LoRA训LLM,不加载说话人相关模块——目的是先把“听清楚内容”的能力拉满,毕竟ASR准了,后续SDR才好做。 Stage2:用模拟SDR数据训projector。冻结LLM和音频编码器,只训随机初始化的projector——模拟数据是把不同人的近场语音拼起来,加了噪音和混响(SNR 10-20dB),目的是让音频和文本特征先“粗对齐”,适应SDR任务。 Stage3:用真实SDR数据训音频编码器+projector。冻结LLM,联合训前两个模块——真实数据更复杂(比如会议远场语音),这一步是让模型抓真实场景的声学特征。 Stage4:联合训所有模块。给LLM加LoRA,一起训音频编码器、projector和LLM——最后一步整合语言(文本)和声学(音频)信息,搞定复杂多说话人场景。
04、实验准备:数据、设置都得讲清楚
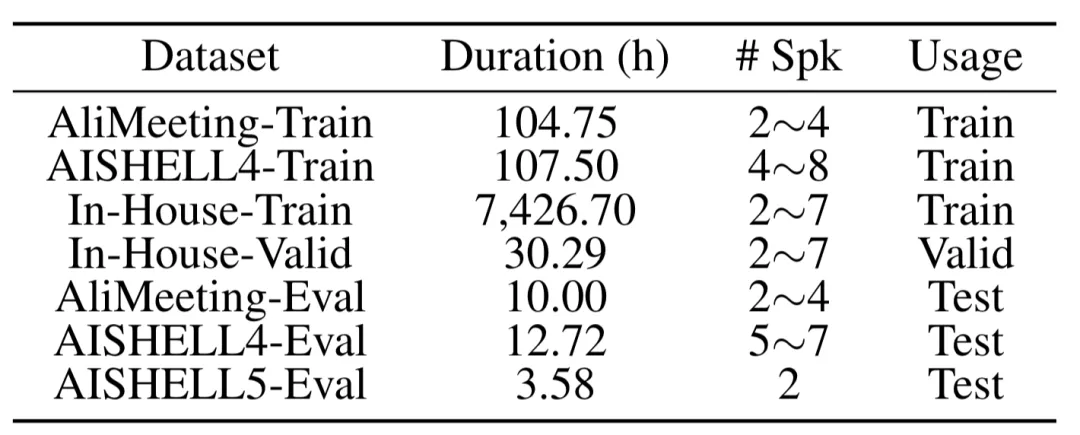
公开数据:AliMeeting(会议场景,训104.75h、测10h)、AISHELL4(会议场景,训107.5h、测12.72h)、AISHELL5(车内场景,测3.58h,有风声、轮胎声、空调声,特别难,用来测泛化性);
内部数据:7426.7h训练、30.29h验证,是近场录音,用来提升模型数据量。
CER:只看ASR准不准,不管说话人(比如把“你好”写成“你郝”,CER就高);
cpCER:联合看ASR和SD,无注册时找“最优标签排列”(比如模型标spk0,实际是spk1,只要内容对、排列对就算对);
saCER:联合看ASR和SD,有注册时直接按名字对齐(比如模型把Mike的话标成Lucy,就算错);
∆cp=cpCER-CER、∆sa=saCER-CER:反映“说话人归属误差”——比如CER很低但∆cp高,说明ASR准但说话人标错了,这俩指标不受ASR影响,更准。
SD+ASR:用Paraformer-large(ASR里的SOTA)当ASR,配4个SD工具(3D-Speaker、Pyannote3.1、Diarizen-base/large),共4个基线;
SD+ASR+LLM:用Diarizen-large+Para当前端,加LLM修正(ChatGPT4.5零样本、Qwen2.5-7B零样本、Qwen2.5-7B微调),共3个基线;
E2E-SDR:只有SpeakerLM自己。
音频都转成16kHz,片段长度40-50秒; 注册说话人的embedding:取2-10秒语音片段,平均得到;Over-Regist时多余人数N_ov随机1-50个; 优化器AdamW,学习率从1e-5 warm-up到5e-5,再余弦衰减; 用4个NVIDIA A800 GPU,每个阶段训1M步,每10K步验证一次。
05、实验结果:SpeakerLM到底有多强?
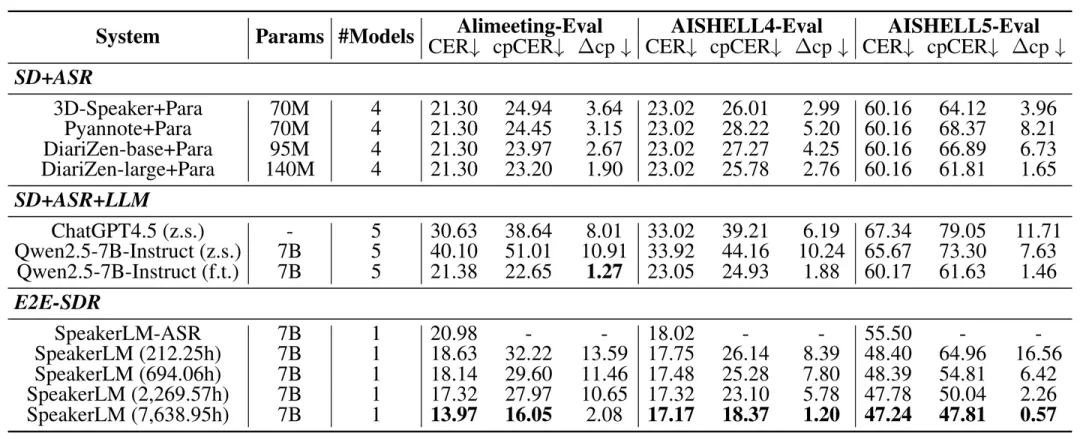
先看基线的问题:LLM零样本(ChatGPT4.5、Qwen2.5零样本)特别差,CER反而升高——因为LLM会“ hallucination(幻觉)”,明明让它只改说话人标签,它却改了内容;就算微调Qwen2.5,也只比最强的SD+ASR(Diarizen-large+Para)好一点。 SpeakerLM的“数据缩放能力”: 数据少的时候(212.25h,只有公开数据):SpeakerLM不如大部分基线,cpCER和∆cp都高; 数据多了(7638.95h,公开+内部数据):直接碾压所有基线!比如: AliMeeting-Eval(域内):cpCER比Diarizen-large+Para低6.60%,∆cp只有2.08%(说明说话人标得很准); AISHELL5-Eval(域外、难):cpCER低13.82%,∆cp才0.57%——这说明SpeakerLM泛化性超强,就算是车内噪音环境也hold住。 为啥CER提升不多?因为内部数据是近场录音,对远场带混响的语音,ASR提升有限,但SD(说话人归属)能力提升巨大,这正是SDR需要的。
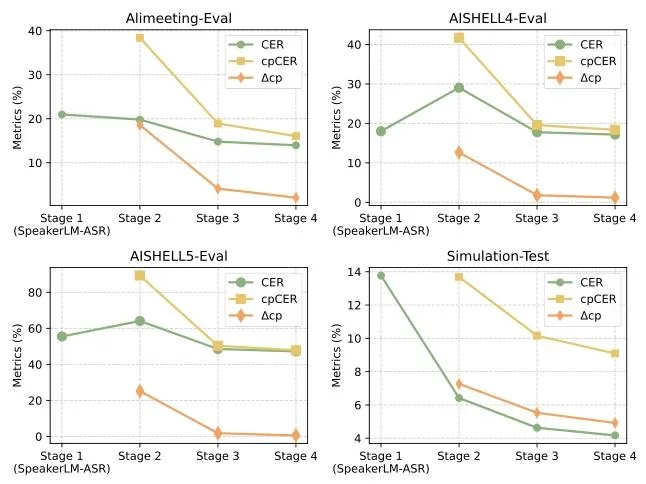
趋势:在AliMeeting-Eval和Simulation-Test上,从Stage1到Stage4,cpCER和∆cp稳步下降,说明多阶段训练有效; 小插曲:Stage2(模拟数据)在AISHELL4、AISHELL5上CER反而比Stage1高——因为模拟数据和这两个数据集“域不匹配”(模拟是简单拼的,真实是复杂场景);但Stage3、4用真实数据训完,性能就回来了,证明后两个阶段能解决域不匹配问题。
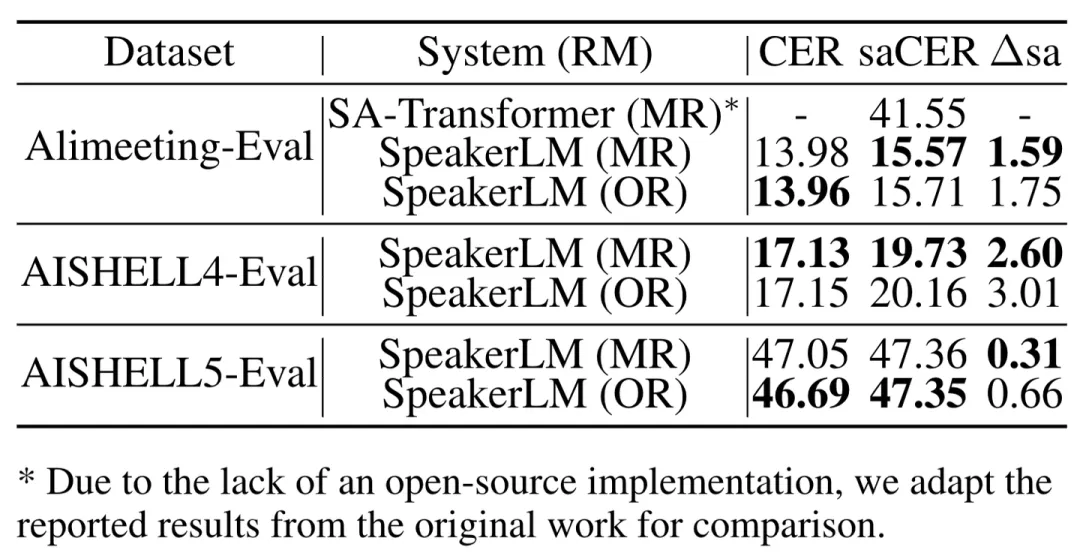
比SA-Transformer强太多:在AliMeeting-Eval上,SpeakerLM的saCER比SA-Transformer低25.98%——因为SA-Transformer只能处理“注册和实际完全匹配”的情况,而SpeakerLM能应对各种注册场景;
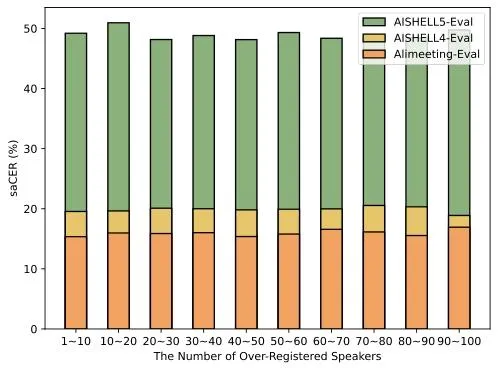
Match-Regist vs Over-Regist:两者的CER、cpCER差不多,但Over-Regist的∆sa更高(比如AliMeeting-Eval上,Match-Regist的∆sa=1.59%,Over-Regist=1.75%)——说明多余的注册信息会轻微影响说话人归属,但整体影响不大,模型能过滤冗余。
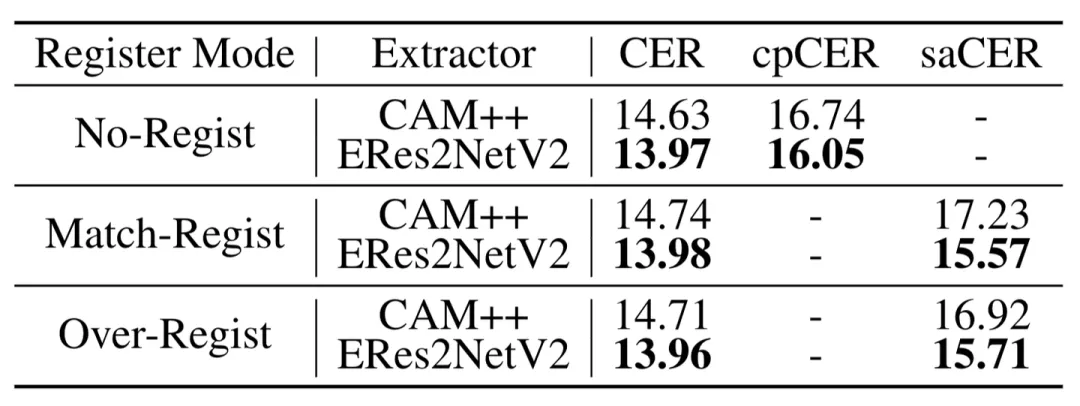
用ERes2NetV2比CAM++好:比如No-Regist时,ERes2NetV2的CER=13.97%、cpCER=16.05%,都比CAM++低——说明“说话人embedding质量”会影响SpeakerLM性能,好的embedding能让模型更准识别说话人。
06、结论:SpeakerLM的价值在哪?
搞出第一个“端到端SDR的多模态大模型(SpeakerLM)”,不用拆SD和ASR,解决了级联系统的误差传递问题; 加了“灵活的说话人注册机制”,能应对无注册、匹配注册、过量注册三种场景,特别贴合现实需求; 用“多阶段训练”让模型从简单到复杂逐步学习,数据越多性能越强,在域内、域外(比如车内噪音)都比现有基线好。
