
 语音小管家
语音识别(ASR)作为高效转录语音的技术,在当今社会中扮演着越来越重要的角色。借助大语言模型的语音识别(LLM-ASR)性能出色,但通常会产生高昂的计算成本。探索LLM-ASR的高效训练策略以及扩展方法具有重要意义,以便获得给定计算成本(FLOPs)情况下获得最佳性能。
最近,实验室博士生穆秉甡的论文“Efficient Scaling for LLM-based ASR”被语音研究领域重要会议 IEEE Workshop on Automatic Speech Recognition and Understanding(ASRU) 接收。该论文通过大量实验总结出了一个始终能以显著更低的计算预算实现更好性能的LLM-ASR训练策略,并且推出一个扩展方案,建立FLOPs与语音识别错误率之间的关系。现对该论文进行简要的解读。
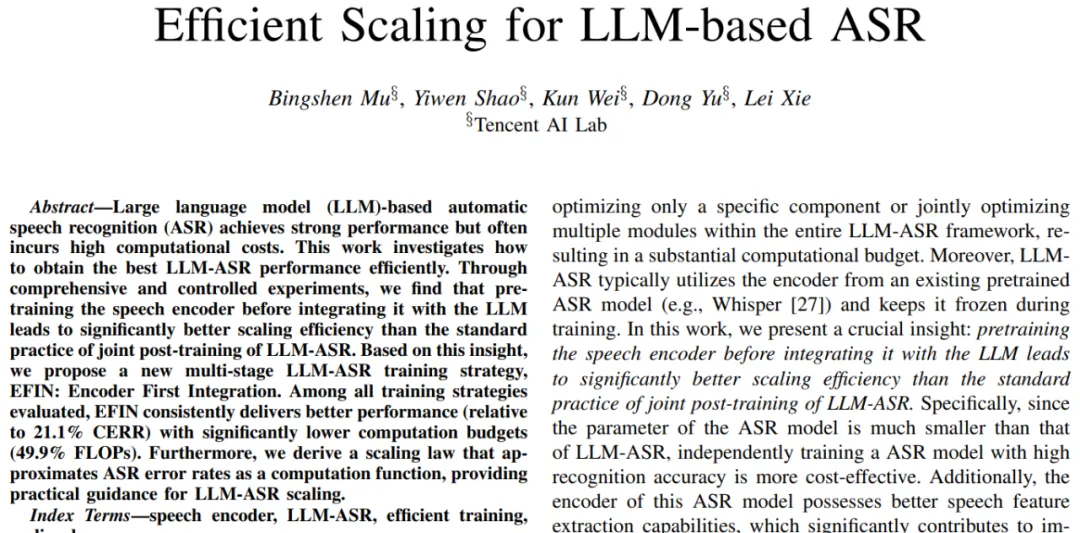
论文题目:Efficient Scaling for LLM-based ASR
作者列表:穆秉甡,邵益文,魏坤,俞栋,谢磊
论文预印版:https://arxiv.org/pdf/2508.04096
随着大语言模型(LLM)的迅速发展,大量研究致力于探索大语言模型在各个领域的潜力,包括在语音识别(ASR)领域。大语言模型中广泛文本知识和具备的上下文推理能力,可以为语音识别提供语义指导。最近将大语言模型与语音识别相结合的研究展示了卓越的性能,通过连接层将语音编码器与大语言模型连接的范式,已成为基于大语言模型的语音识别(LLM-ASR)的主流框架。然而,LLM-ASR中的大量参数需要巨大的计算资源来进行训练。 因此,如何在给定的计算资源预算下高效训练LLM-ASR以实现最佳性能是本论文的研究目标。
此前的研究探索了LLM-ASR的各种训练策略。然而,这些研究通常专注于在整个LLM-ASR框架内优化特定模块或者联合优化多个模块,这些策略将会造成大量的计算开销。此外,LLM-ASR通常会采用已有的预训练语音识别模型(如Whisper)的编码器,并在训练过程中将其冻结或者联合优化。在本研究中,我们提出一个关键观点:将语音编码器与大语言模型集成之前对语音编码器进行训练,相较于常见的LLM-ASR联合后训练方法,能显著提高效率。具体而言,由于语音识别模型的参数远少于LLM-ASR的参数,独立训练一个具有高识别准确率的语音识别模型更具性价比。此外,该语音识别模型的编码器具备更好的语音特征提取能力,这对提升LLM-ASR性能有显著帮助。因此,给定一个预训练的语音编码器和大语言模型作为基础,以及用于后训练的新领域数据,我们引入一种LLM-ASR的三阶段训练策略:编码器优先集成(EFIN)。
本文引入的EFIN训练策略由三个阶段组成。
Stage 1:使用其原始的结构和优化目标单独训练语音编码器
Stage 2:冻结语音编码器和LLM,只训练连接层至初步收敛
Stage 3:冻结语音编码器,同时训练连接层和LLM至最终收敛。在本论文中,我们使用LoRA训练LLM。
此外,我们研究了EFIN的缩放特性,以便在给定的计算预算下准确预测LLM-ASR的语音识别性能。通过使用不同微调后的Whisper编码器,我们使用2000到10000小时的数据集进行最后两阶段的训练,得出一个神经缩放定律。该定律表明,语音识别错误率(字符错误率,CER)与总计算成本(浮点运算次数,FLOPs)遵循幂律关系。
我们还比较了各种训练策略的缩放定律,观察到在相同的计算预算下,EFIN始终能实现更好的识别性能。此外,当语音编码器使用更大的模型容量和更广泛的数据进行预训练时,LLM-ASR性能会进一步提升。这些发现验证了我们的核心观点,并表明使用更多的计算资源对语音编码器进行预训练或微调,会使LLM-ASR具有更强的性能。
高效训练策略
我们刚才提出的关键观点,介绍一种名为EFIN的LLM-ASR训练策略,并通过与其他训练策略的对比来突出其优势。
实验设置:LLM-ASR的语音编码器是Whisper-medium[1],连接层由带有ReLU激活函数的两个线性层组成,LLM使用Qwen2.5-7B-Instruct[2],LLM采用LoRA微调[3]。每个训练阶段使用包含10000小时的全量WenetSpeech数据集[4]。
多阶段训练:LLM-ASR的训练通常分多个阶段进行,这些阶段依据所涉及的模块而有所不同。我们将主要阶段总结如下:
Alignment Stage:仅训练连接层,以使语音编码器的表征与大语言模型的文本嵌入空间对齐。
LLM Adaptation Stage:联合训练连接层和大语言模型,使大语言模型进一步适配语音领域的数据。
Full Joint Training Stage:将语音编码器、连接层层和大语言模型这三个模块联合优化直至收敛。
基线训练策略:我们逐步将这三个阶段纳入训练,以制定多种可供比较的策略。
Strategy-1:(1) Alignment Stage。这与SLAM-ASR[5]相同。
Strategy-2:(1) Alignment Stage;(2) LLM Adaptation Stage。这种策略与Icefall方案一致[6]。
Strategy-3:(1) Alignment Stage;(2) LLM Adaptation Stage; (3) Full Joint Training Stage。
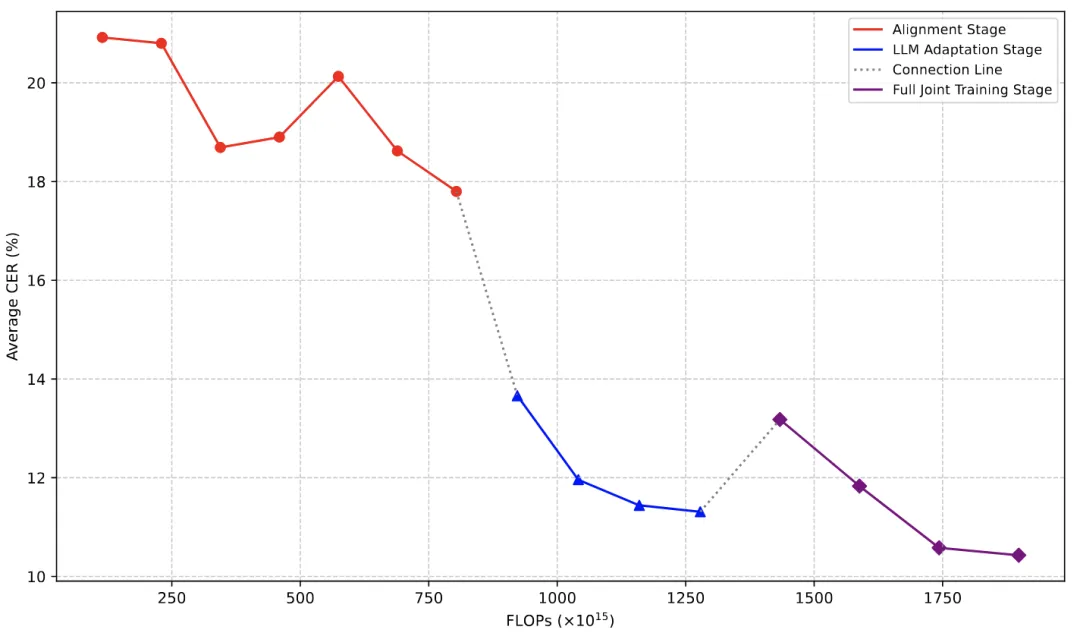
图1 Strategy-1、Strategy-2和Strategy-3在每个模型检查点的平均CER和FLOPs。Strategy-1:仅红色部分;Strategy-2:红色和蓝色部分;Strategy-3:红色、蓝色和紫色部分
如图1所示,我们发现Strategy-1对LLM-ASR的语音识别性能提升有限。加载连接层参数,然后同时训练连接层和大语言模型的LoRA参数,可显著提升性能(Strategy-2)。在此基础上,联合训练语音编码器、连接层层和大语言模型的LoRA参数,虽然性能提升幅度较小,但却会显著增加FLOPs的消耗(Strategy-3)。
EFIN:尽管计算效率不高,但Full Joint Training Stage带来的微小提升表明,优化语音编码器仍有可能提高性能。这促使我们研究在对齐阶段之前引入一个额外的阶段,使用其原始架构和目标独立微调语音编码器是否有益。
与Full Joint Training Stage不同,该阶段在优化语音编码器时计算成本高昂,且回报递减,我们的方法以一种更高效、更直接的方式分别对编码器进行微调。关键问题在于,这种编码器微调所带来的益处是否会在后续训练阶段持续存在。 为了回答这个问题,我们逐步将各个阶段纳入训练流程。
Strategy-4:(1)Encoder Fine-tuning/Pretraining Stage;(2) Alignment Stage。
Strategy-5:(1)Encoder Fine-tuning/Pretraining Stage;(2) Alignment Stage;(3) LLM Adaptation Stage。
Strategy-6:(1)Encoder Fine-tuning/Pretraining Stage;(2) Alignment Stage;(3) LLM Adaptation Stage; (4) Full Joint Training Stage。
表1 所有训练策略的在两个测试集上的CER和总FLOPs
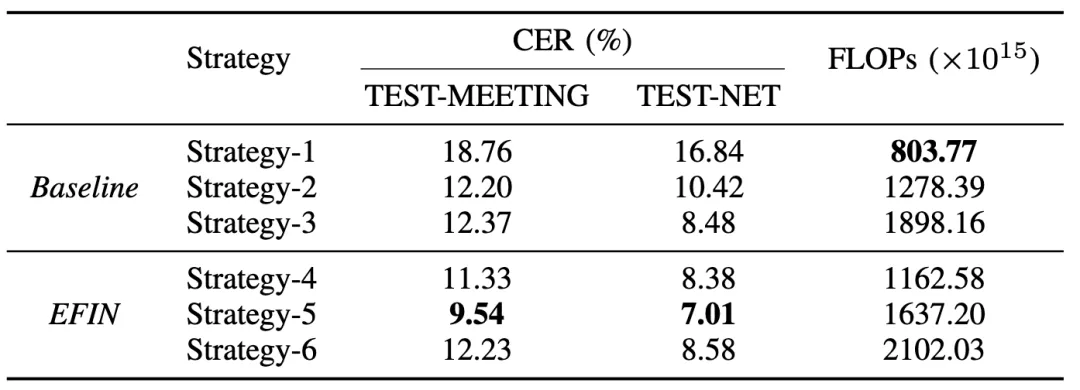
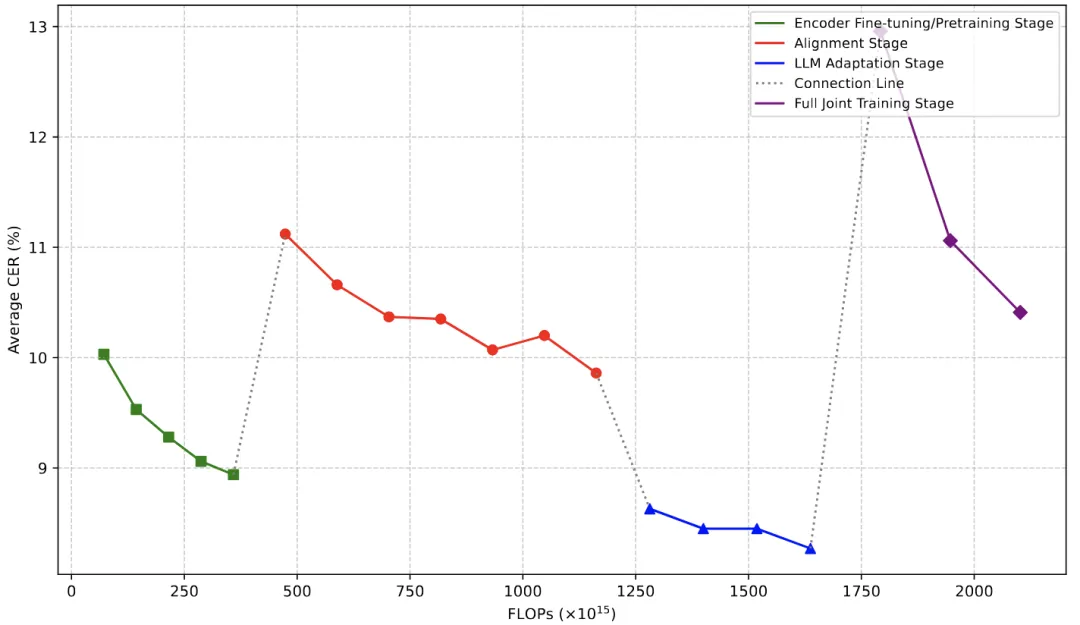
图2 Strategy-4、Strategy-5和Strategy-6在每个模型检查点的平均CER和FLOPs。Strategy-4:绿色和红色线段;Strategy-5:绿色、红色和蓝色线段;Strategy-6:绿色、红色、蓝色和紫色线段
表1和图2均表明,与基线策略相比,EFIN显著提升了语音识别性能,同时仅带来适度的计算成本增加。一个值得注意的发现是,一旦从Encoder Fine-tuning/Pretraining Stage开始训练,添加Full Joint Training Stage就不再必要,甚至可能会降低性能。
从图2可以推测,若有额外的计算资源(例如更多的训练步骤或更大的数据集),Strategy-6最终可能会赶上Strategy-5。然而,鉴于Full Joint Training Stage会使其成本大幅增加,我们认为这样做并不值得。因此,我们确定将EFIN作为一种三阶段训练策略(即Strategy-5),省略Full Joint Training Stage以实现更好的效率与性能权衡。
此外,对比Strategy-3和Strategy-5可得出一个重要结论:对编码器进行预训练在计算效率和效果上都更优。Strategy-5仅使用了Strategy-3计算预算的86%,就在TEST-MEETING数据集上实现了22.8%的CER相对降低,在TEST-NET数据集上实现了17.3%的CER相对降低。
迈向更高效的EFIN:虽然EFIN在有限的计算资源下已经取得了不错的性能,但我们进一步探究其效率是否还能提高。具体来说,我们重新审视Alignment Stage。如图3所示,此阶段(红色线段)消耗了相对较多FLOPs,且收敛速度较慢。 鉴于后续的LLM Adaptation Stage也会更新连接层,我们假设Alignment Stage实现完全收敛可能并无必要。相反,使连接层达到初步对齐或许就足以支持有效的后续优化。这就为通过缩短Alignment Stage来减少计算量提供了可能,且不会降低整体语音识别性能。
表2 Strategy-5第二阶段不同收敛程度在两个测试集上的CER和FLOPs
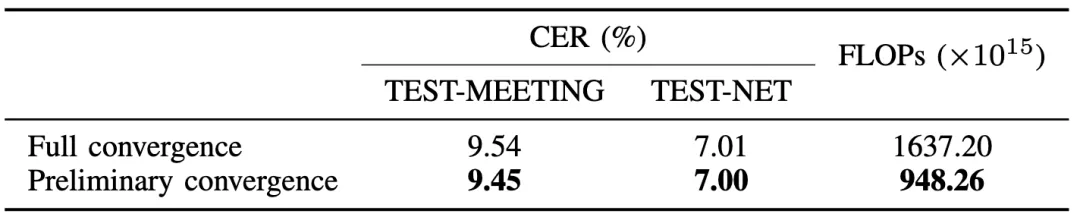
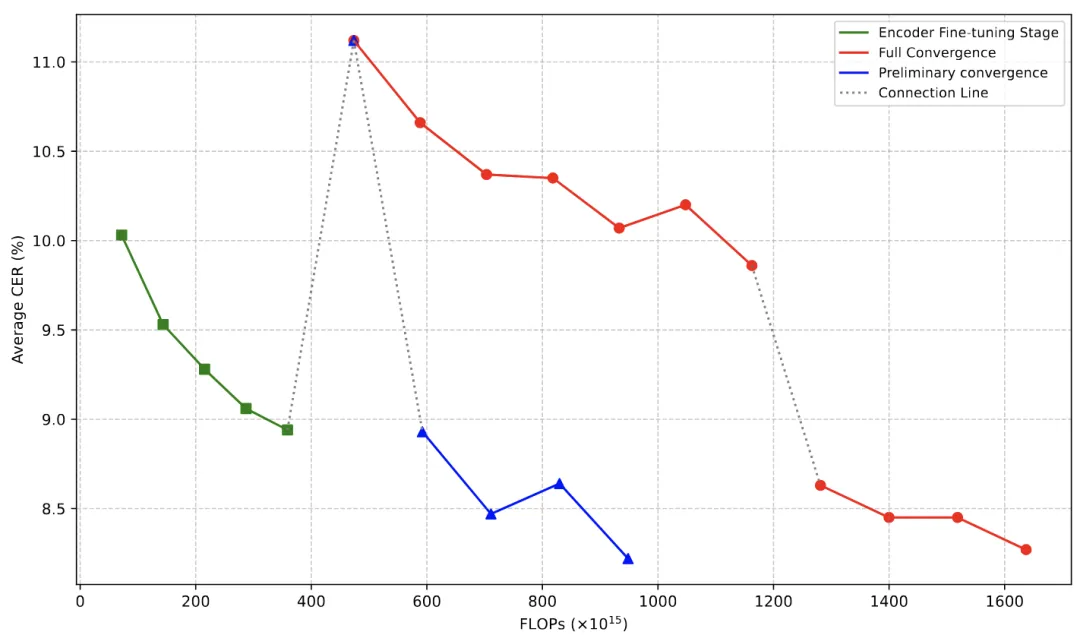
图3 Strategy-5第二阶段不同收敛程度下各模型检查点的平均CER和FLOPs。绿色:Encoder Fine-tuning/Pretraining Stage;蓝色:初步收敛Alignment Stage和LLM Adaptation Stage;红色:完全收敛Alignment Stage和LLM Adaptation Stage。
为了验证这一假设,我们进行实验以检验Strategy-5是否需要Alignment Stage达到完全收敛。表2的实验结果说明在进入下一阶段之前,仅将连接层训练到初步收敛水平,可使每秒浮点运算次数减少42.1%,并使语音识别性能略有提升。这表明,Alignment Stage的完全收敛并非必要,在实际应用中甚至可能并非最优。此外,图3表明仅进行初步收敛,后续训练过程的收敛速度会显著加快。
因此,EFIN最具效率和效果的形式为:(1)Encoder Fine-tuning/Pretraining Stage;(2)初步收敛的Alignment Stage;(3)LLM Adaptation Stage。
各种策略的扩展行为
实验设置:LLM-ASR结构保持不变,对于所有涉及微调或预训练语音编码器的EFIN策略,我们将语音编码器固定为在完整的10000小时WenetSpeech数据集上进行过微调的编码器,这使我们能够分离并分析涉及大语言模型阶段的缩放行为。对于其余的训练阶段(即Alignment Stage、LLM Adaptation Stage和Full Joint Training Stage),我们使用从WenetSpeech中随机采样的2000小时、5000小时、8000小时和10000小时的子集来改变数据规模。
实验结果:如表3所示,与基线训练策略相比,我们提出的EFIN变体始终展现出更好的扩展性——仅在适度增加计算成本的情况下就实现了更低的字符错误率。在所有评估方法中,性能最佳的策略是EFIN具有初步收敛的Strategy-5,它在所有数据规模下都展现出领先的语音识别性能。Strategy-5所需的FLOPs仅比最简单的Strategy-1多18%,但却实现了显著的53.8%的相对CER降低。与最强的基线Strategy-3相比,Strategy-5仍实现了21.1%的相对CER降低,同时仅消耗了49.9%的FLOPs。
表3 不同数据规模下六种训练策略的在两个测试集上的CER和总FLOPs
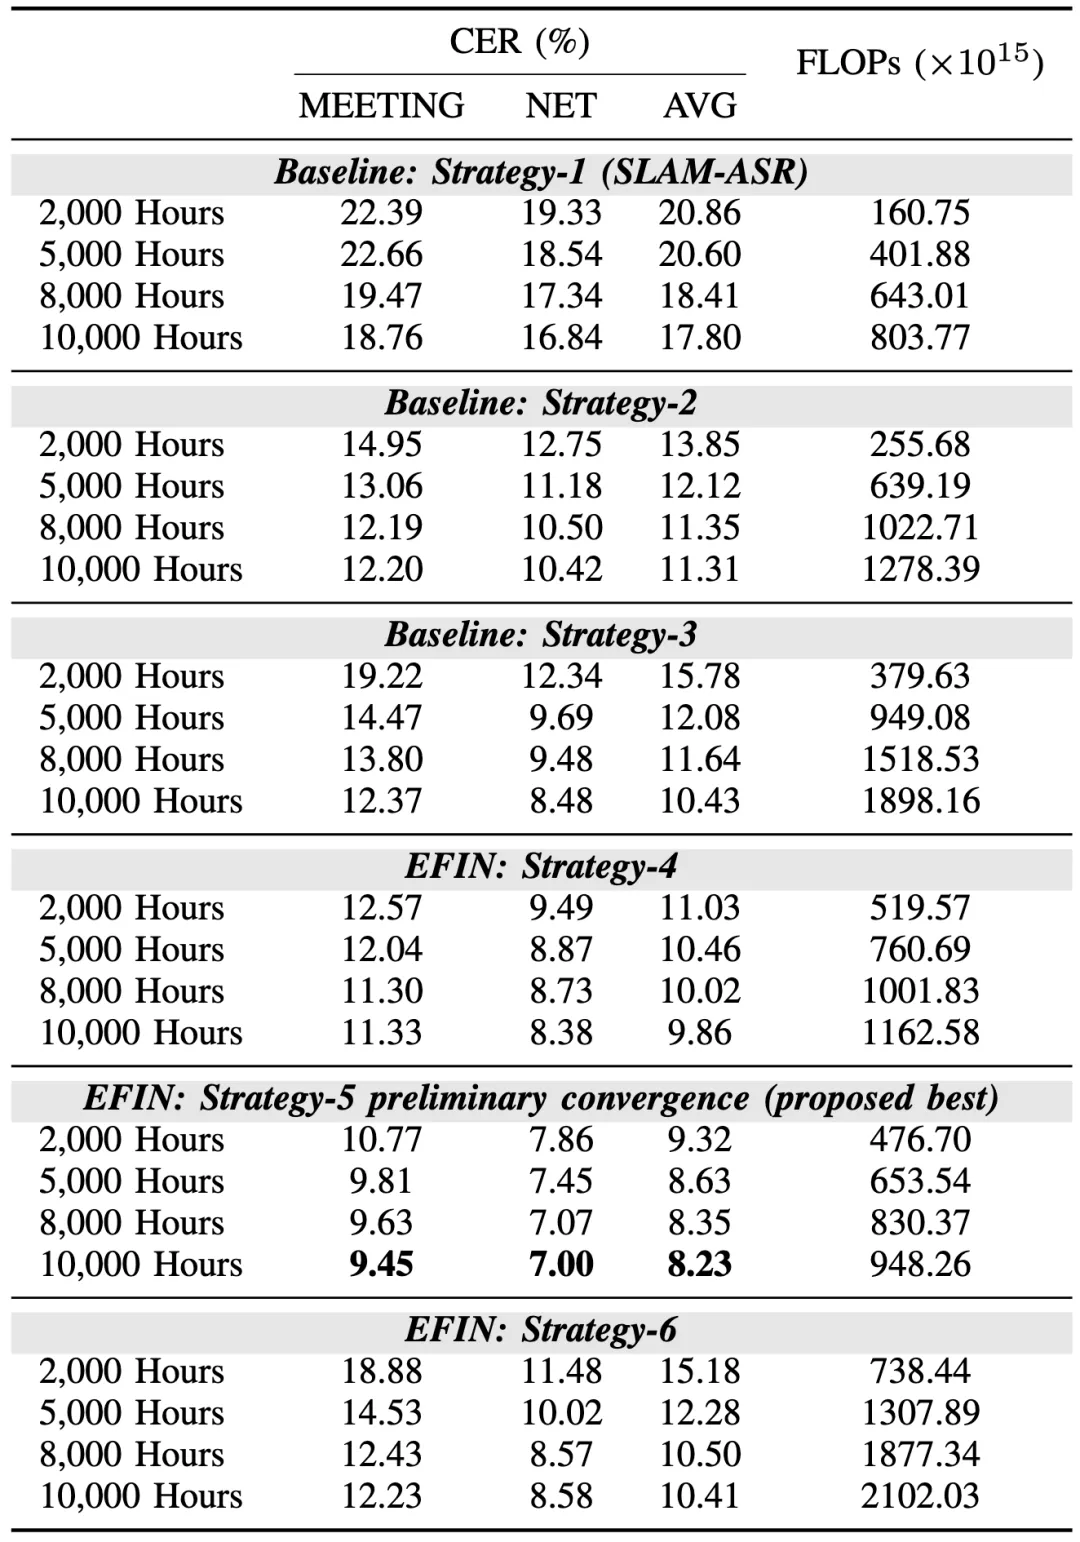
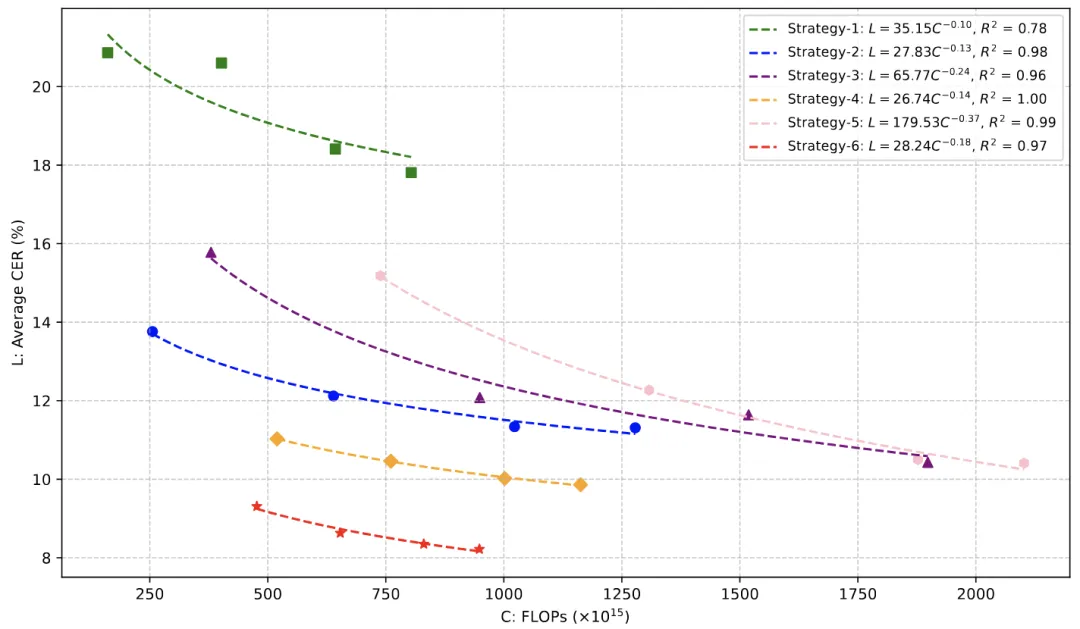
图4 多种训练策略的缩放定律曲线
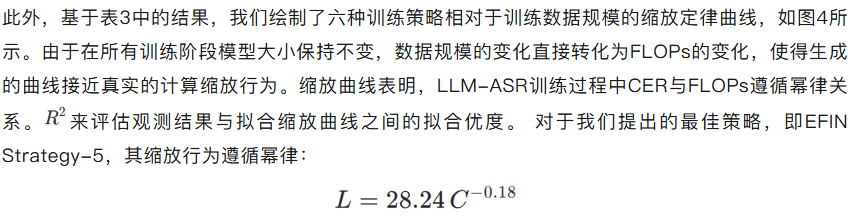
其中L表示平均CER,C表示FLOPs。这种关系使我们能够准确预测在给定计算预算下,LLM-ASR所能达到的语音识别性能。
更优的预训练语音编码器
为了进一步研究经过良好优化的语音编码器对LLM-ASR性能的影响,我们使用两个具有不同语音识别能力的预训练Whisper语音编码器进行实验。
实验设置:微调的Whisper-medium编码器:该编码器在完整的WenetSpeech数据集上进行了微调,与上述实验使用的语音编码器相同。
微调的Whisper-large-v2编码器:该编码器来自一个开源whisper模型,该模型在总时长为13906小时的多个中文语音识别数据集的组合上进行了微调。
LLM-ASR结构保持不变。我们将所提出的最佳EFIN训练策略的最后两个阶段应用于上述两个预训练语音编码器。我们从WenetSpeech数据集中随机选择2000小时、5000小时和8000小时的数据,以及全部10000小时的数据,以研究使用不同预训练编码器的LLM-ASR的缩放行为。
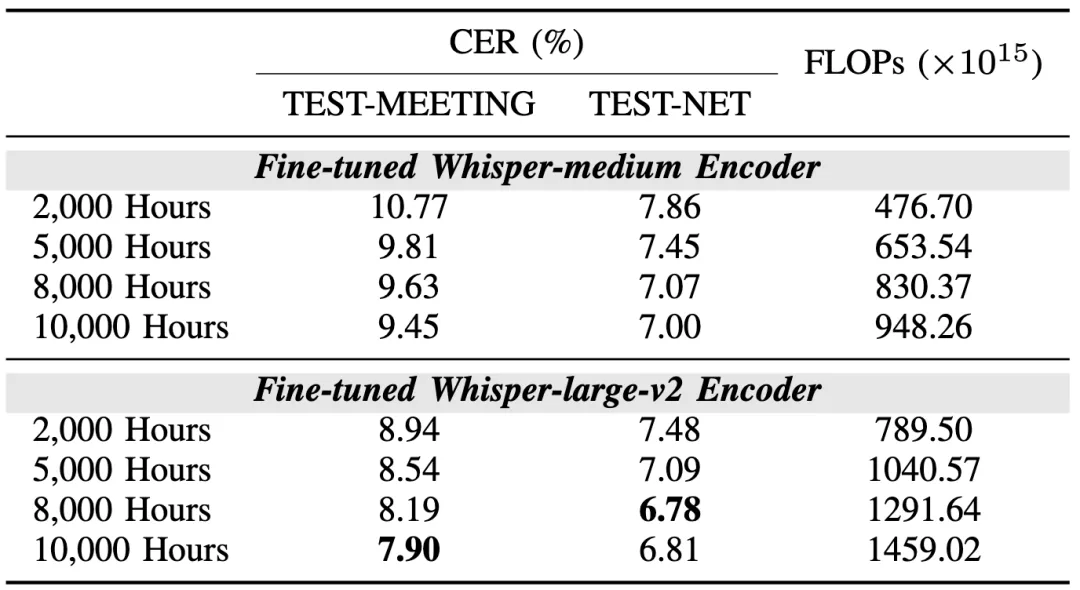
实验结果:如表4所示,使用更强的微调后Whisper-large-v2语音编码器,我们将CER从之前的最佳数值9.45%和7.00%进一步降低至7.90%和6.78%。 同样,根据表4中的结果,我们绘制了两种预训练语音编码器的缩放定律曲线,如图4所示。微调后的Whisper-large-v2编码器的新幂律缩放关系为:
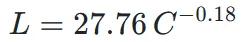
我们发现微调后的Whisper-large-v2编码器的缩放系数更低,这表明在相同的计算资源下,LLM-ASR性能有所提升。这一结果强化了强大编码器预训练的重要性:通过投入更多的计算资源来独立构建一个更好的语音编码器,我们可以更高效地实现卓越的LLM-ASR性能。
表4 不同数据规模下LLM-ASR中两种Whisper语音编码器在两个测试集上的CER和总FLOPs
[1] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, “Robust Speech Recognition via Large-Scale Weak Supervision,” in Proc. ICML, 2023, pp. 28 492–28 518.
[2] https://huggingface.co/Qwen/Qwen2.5-7B-Instruct
[3] E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang, W. Chen et al., “LoRA: Low-Rank Adaptation of Large Language Models,” in Proc. ICLR, 2022.
[4] B. Zhang, H. Lv, P. Guo, Q. Shao, C. Yang, L. Xie, X. Xu, H. Bu, X. Chen, C. Zeng et al., “WENETSPEECH: A 10000+ Hours Multi-Domain Mandarin Corpus for Speech Recognition,” in Proc. ICASSP, 2022, pp. 6182–6186.
[5] Z. Ma, G. Yang, Y. Yang, Z. Gao, J. Wang, Z. Du, F. Yu, Q. Chen, S. Zheng, S. Zhang et al., “An Embarrassingly Simple Approach for LLM with Strong ASR Capacity,” arXiv preprint arXiv:2402.08846, 2024.
[6] https://github.com/k2-fsa/icefall/tree/master/egs/speech_llm/ASR_LLM
