
 语音小管家
标题:All-in-One ASR: Unifying Encoder-Decoder Models of CTC, Attention, and Transducer in Dual-Mode ASR
地址:https://arxiv.org/pdf/2512.11543
作者单位:日本NTT公司
发表日期:2025年12月12日
说明:Accepted to ASRU 2025
01、背景:为啥非要搞“All-in-One”?
CTC:好训练,但语音和文本的对齐能力一般;
AED(注意力编码器-解码器):短语音识别超准,可长语音容易崩(依赖交叉注意力,上下文太长扛不住);
Transducer(论文里用的HAT模型,一种改进版):长语音稳得很,短语音却不如AED灵活。
02、基础准备:先搞懂“All-in-One”的“地基”
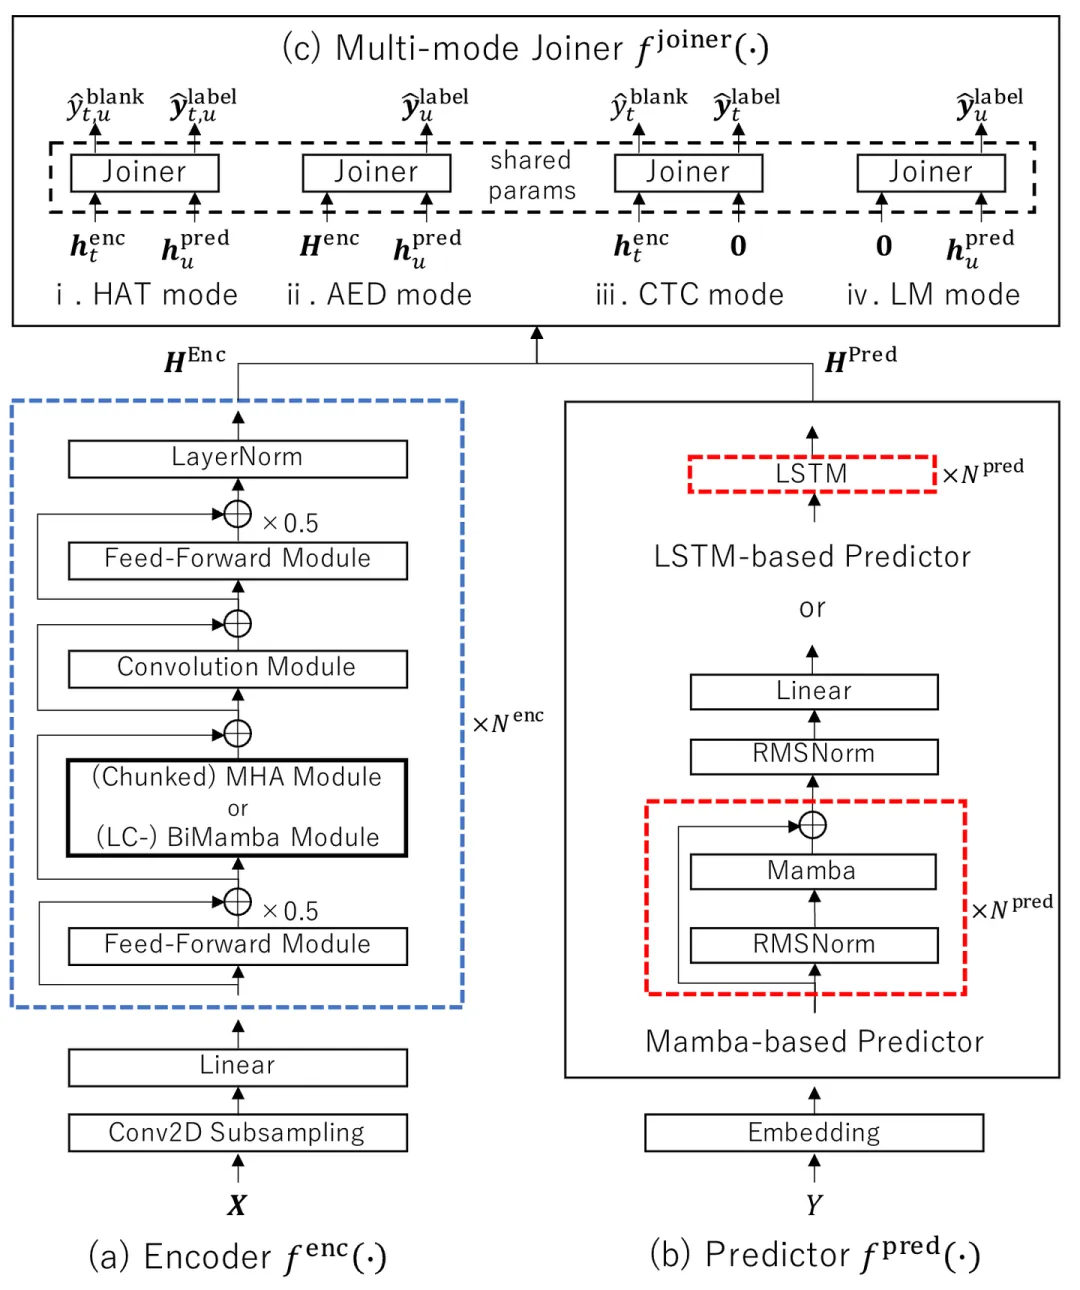
编码器(Encoder):把输入的语音特征(比如80维log Mel,窗口25ms、步长10ms)转成声学编码(Henc)。离线模式用全量上下文(比如Conformer用全自注意力,ConMamba用双向BiMamba);流式模式切成“块(chunk)”处理——Conformer用注意力掩码限制上下文,ConMamba改成“LC-BiMamba”(类似LSTM的块处理逻辑),保证实时性。 预测器(Predictor):把文本token(论文用word-piece,TLv2词汇量500,LibriSpeech 1000)转成语言编码(Hpred),试了LSTM和Mamba两种,最后发现Mamba效果更好,还加了RMSNorm归一化。 连接器(Joiner):把编码器的声学特征和预测器的语言特征“拼一起”,输出每个时间步的识别概率(比如“空白”概率和token概率)——这就是后面改造成“多模式”的关键。
03、核心创新:多模式连接器(Multi-mode Joiner)
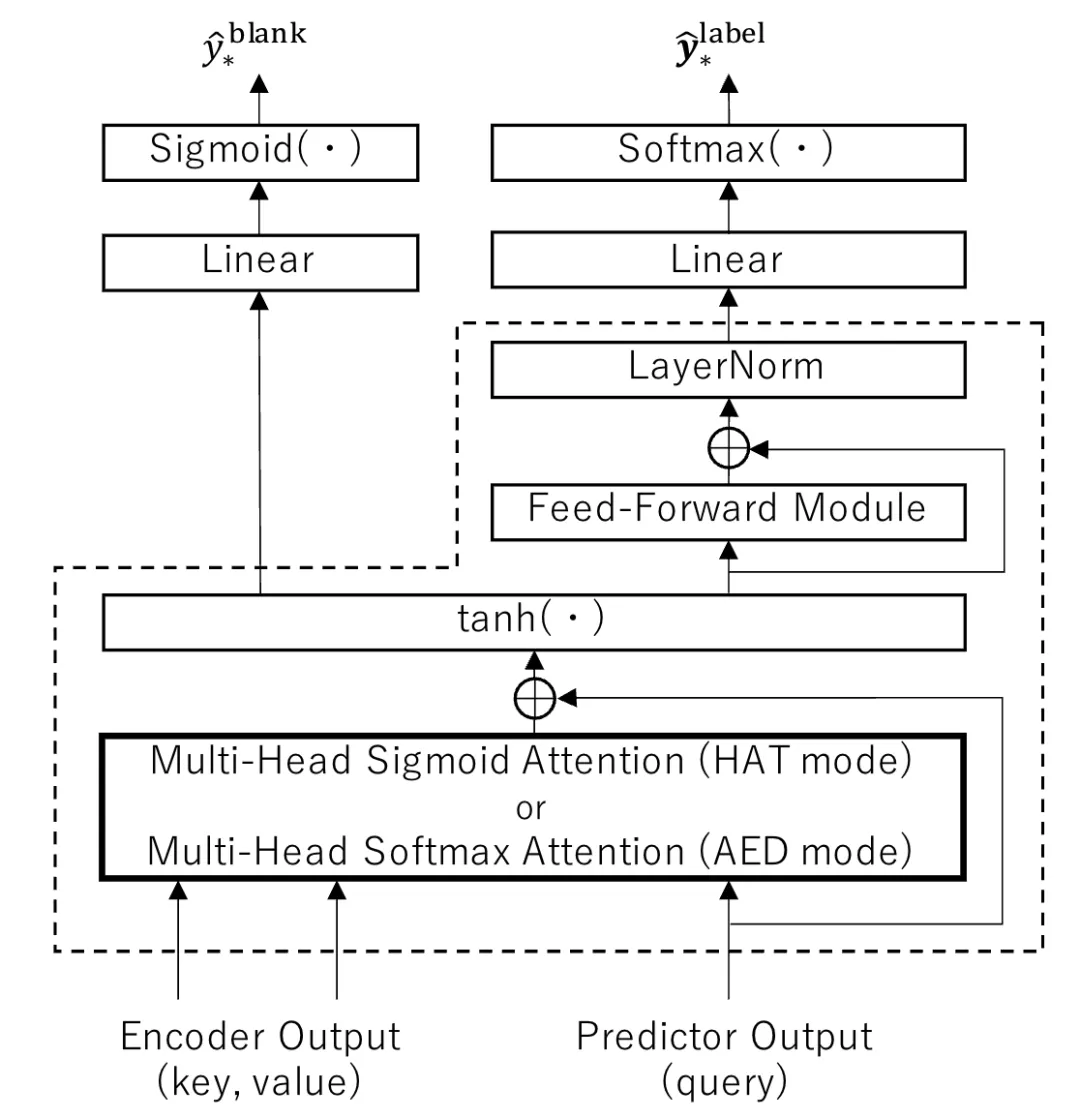
左边输入:Encoder Output(编码器输出) 这是语音的“声学特征”(比如Henc),在注意力里扮演“被查询的素材”——想预测“苹果”这个token,得从这些特征里找“哪个时间段对应‘苹果’的发音”,所以它会拆成 key(索引)和 value(具体特征),供后续匹配用。 右边输入:Predictor Output(预测器输出)这是文本的“语言特征”(比如Hpred),扮演“主动找匹配的目标”——当前要预测第3个token,它就变成 query(查询词),去左边的语音特征里“问”:“哪个key和我最像?”
Multi-Head Sigmoid Attention(多头Sigmoid注意力)→对应HAT模式 为啥用Sigmoid?因为HAT要支持“流式识别”(实时字幕),得逐帧算结果,不能等整段语音。Sigmoid注意力输出0-1的单值,每个“语音帧-token”对独立计算(比如第5帧和第2个token的权重,不管第6帧),算得快、能实时,实验里流式HAT的WER比单模式低(7.8% vs 8.5%),全靠它。 Multi-Head Softmax Attention(多头Softmax注意力)→对应AED模式 为啥用Softmax?AED擅长“离线短语音”,需要精准对齐。Softmax会把所有语音帧的权重“归一化”(总和为1),能全局找最匹配的帧(比如“你好”对应第10-15帧,权重集中在这几帧),实验里离线AED的短语音WER比HAT好(9.9% vs 10.6%),就是它的功劳。
Feed-Forward Module(前馈网络):对融合后的特征做非线性变换,提取更复杂的关联(比如区分“苹果”和“苹裹”); LayerNorm(层归一化):稳定训练,避免特征值波动太大; 输出层:用Linear(线性层)+ Sigmoid/Softmax输出概率——HAT的空白概率用Sigmoid(0-1),AED的token概率用Softmax(所有token概率和为1)。
新换的“掩码自注意力”:处理文本内部依赖(比如预测“吃”时,看不到“苹果”,用掩码挡未来信息),对应Transformer解码器的“掩码自注意力”; 原来的“Softmax注意力”:处理文本-语音对齐,对应Transformer解码器的“编码器-解码器交叉注意力”; 后面的“前馈+归一化”:和Transformer解码器的前馈模块完全一样。 三件事凑齐,就和单层Transformer解码器一模一样了!不用单独搭AED的解码器,省大劲了。
CTC模式:把预测器输出(H^pred)置零,Sigmoid注意力权重固定成0.5,相当于只靠编码器的声学特征预测,用CTC损失优化;
LM模式:把编码器的key/value置零,只靠预测器的语言特征预测,相当于内置轻量LM,用交叉熵损失优化;
TwA模式(Transducer with Attention):把HAT和AED的特征混在一起(tanh里加编码器特征),帮HAT和AED学好对齐,提升它们的性能,但自己识别效果一般,实验没重点测。
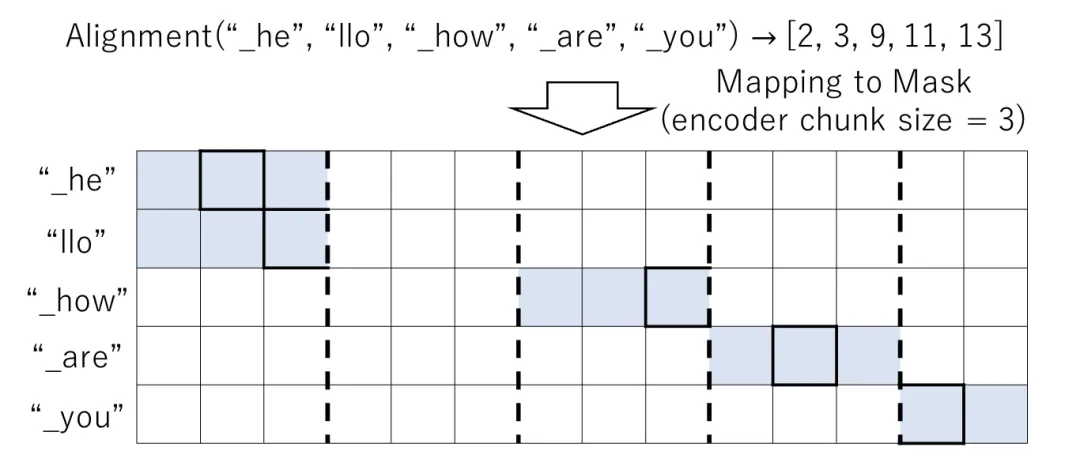
先拿 HAT 的对齐结果 :HAT 本来就擅长流式对齐,训练时能实时算出 “每个 token 对应哪几帧”(比如 “_he” 对应帧 2、“llo” 对应帧 3),不用额外训; 把对齐结果变成 “掩码” :比如 “_he” 对应帧 2,那 AED 算它的注意力时,就只让看 “帧 1-2”(标色的能看),帧 3 及以后全挡住(不让偷看);“llo” 对应帧 3,就允许看 “帧 1-3”,后面继续挡。
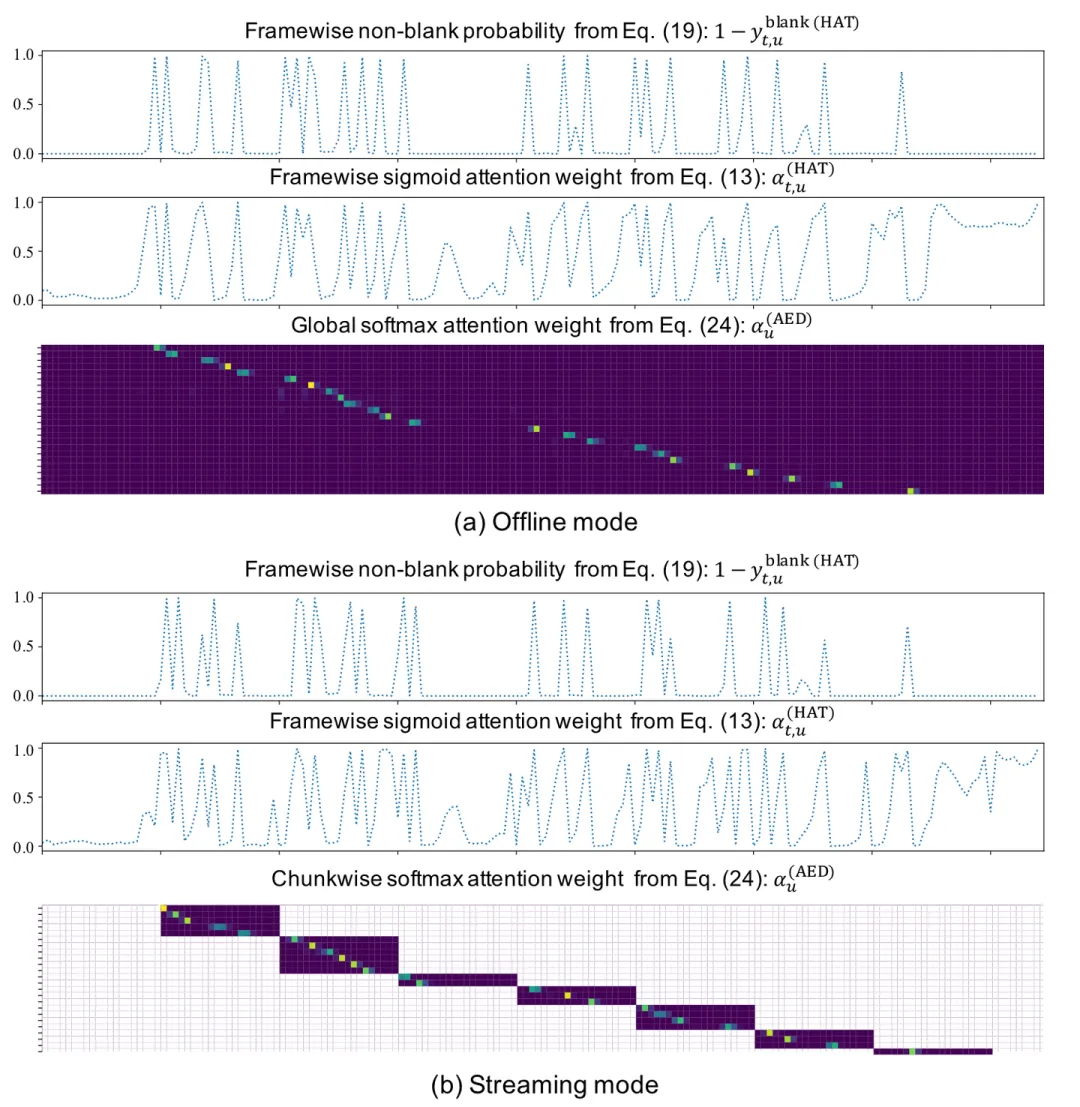
HAT 的非空白概率:值越高,说明HAT觉得 “当前帧不是空白,对应某个 token”; HAT 的 sigmoid 注意力权重:HAT 模式用的,看它跟非空白概率配不配; AED 的 softmax 注意力权重:AED 模式用的,看它咋抓语音帧。
HAT 的 sigmoid 权重和非空白概率几乎重合,没冗余 —— 说明它抓帧很准; AED 的 softmax 权重能全局找匹配帧(比如某个 token 对应好几帧,权重都集中在那)—— 符合离线看全量语音的需求。
HAT 的 sigmoid 权重有点小波动(毕竟上下文少),但还是能抓住关键帧; AED 的 softmax 权重范围变窄(因为按 chunk 处理),只看当前块里的帧 —— 符合流式实时性; 还能看到:语音快结束时,HAT 的权重会上升 —— 它能捕捉 “句末 token”,知道该停了,特别聪明。
04、训练和解码:怎么让多模式“协同工作”?
05、实验:真的能省参数还提性能吗?
输入和预处理:80维log Mel特征,用SpecAugment做数据增强;分词用word-piece,TLv2词汇量500,LibriSpeech 1000。 模型结构 : 编码器:17层Conformer(带自注意力)或12层ConMamba(无注意力,用Mamba模块),参数都控制在110M左右; 预测器:2层512维LSTM或Mamba(Mamba加RMSNorm); 流式配置:块大小20(对应400ms延迟,满足实时),Conformer缓存20帧历史数据。 训练参数:Adam优化器,热身25k步,峰值学习率1.5e-3;TLv2训100轮,LibriSpeech训200轮;解码用beam size=8。 外部LM:12层ConMamba encoder,把ASR编码器的卷积下采样换成embedding层,BiMamba换成单向Mamba,兼容流式解码。
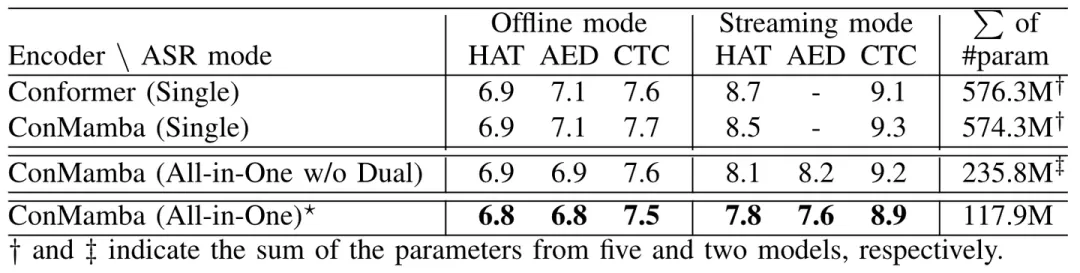
离线HAT:All-in-One 6.8% vs 单模式6.9%; 流式HAT:All-in-One 7.8% vs 单模式8.5%; AED、CTC也差不多,甚至略优——直接证明“省参数还保性能”不是吹的。
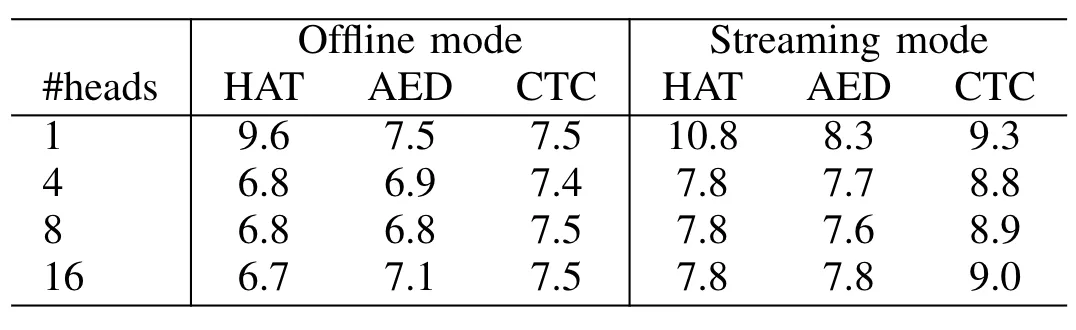
1个头:HAT模式崩了(离线WER 9.6%,流式10.8%)——单头Sigmoid抓不住复杂对齐,权重容易变0; 4头及以上:WER稳定(8头和16头离线HAT都是6.8%)——所以最后选8头,平衡效果和计算量。
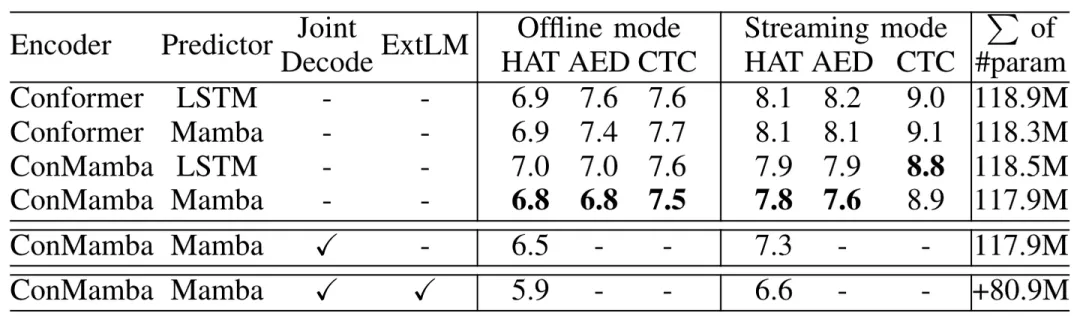
编码器:ConMamba比Conformer好(ConMamba+Mamba离线HAT 6.8% vs Conformer+LSTM 6.9%)——Mamba能兼容多模式训练,Conformer甚至没收敛; 预测器:Mamba比LSTM略好(ConMamba+Mamba离线AED 6.8% vs ConMamba+LSTM 7.0%); 联合解码:融HAT和AED后,离线HAT从6.8%降到6.5%;加外部LM,直接降到5.9%,效果明显。
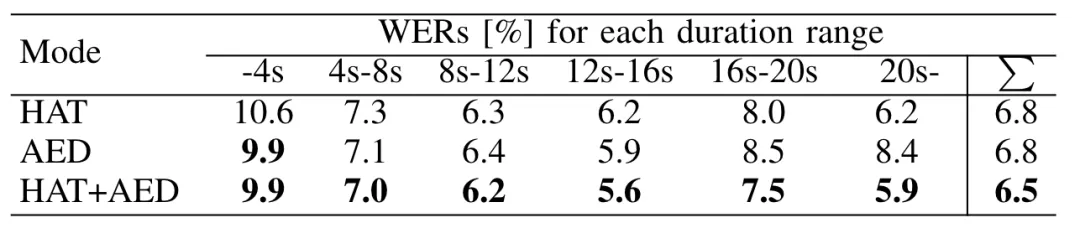
HAT擅长长语音:20秒以上WER 6.2%,AED是8.4%; AED擅长短语音:4秒以下WER 9.9%,HAT是10.6%; 联合解码后:所有长度都降了(4秒以下到7.0%,20秒以上到5.9%)——完美补短板。
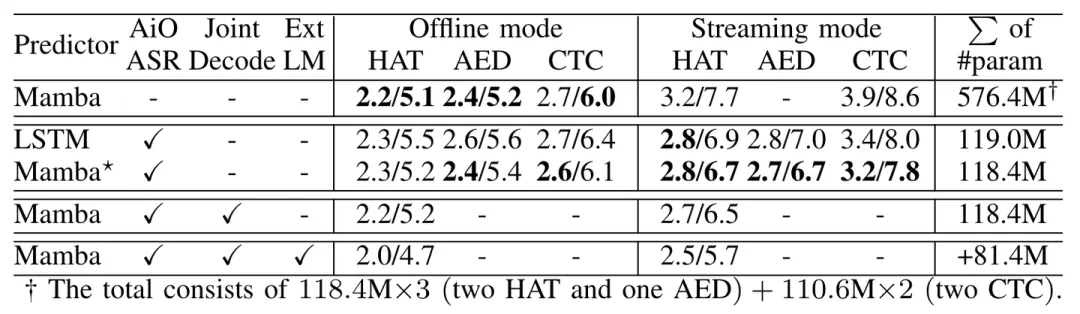
单模式Mamba参数576.4M,流式HAT WER 3.2%/7.7%(干净/嘈杂); All-in-One(ConMamba+Mamba)参数118.4M,流式HAT降到2.8%/6.7%,还更准; 加联合解码和外部LM,离线HAT到2.0%/4.7%,行业高水平。
06、结论和未来计划
搞出All-in-One ASR框架,用“多模式Joiner”统一了CTC、AED、Transducer+离线/流式,不用额外加参数; 实验证明:参数比单模式小80%,WER还更高,联合解码能补短板; 验证了ConMamba和Mamba预测器特别适合“多模式统一”,比Conformer+LSTM效果好。
