
 语音小管家
无论是语音产品的用户,比如经常使用语音输入法、语音转文字或语音聊天功能,还是开发者,都会面临一个问题:各家语音识别 API 都声称自己的识别准确率达到了 98% 以上,可为什么实际用起来感觉识别错误还是很多?“做了这么久,老板的名字都识别不对!”,是不是很尴尬,哈哈
这些错误中,很大一部分集中在专有名词和同音字词。专有名词涵盖的范围很广,从地名、人名,到各种垂直场景——如医疗、法律、金融、化学等领域——各种拗口、同音、生僻的词汇都会让模型“为难”。此外,如今网络新词更新极快,也特别适合通过关键词增强来提升识别准确率。
文章最后也会介绍几种常用的热词增强方法,即使你没有模型训练能力、无法复现论文工作,也能在一定程度上缓解热词识别的问题。
为什么模型识别不好专有名词
原因很简单:数据稀缺和上下文不足。
数据稀缺
专有名词在训练数据中出现的频率极低,而当前模型训练数据大多通过已有模型进行自动标注和交叉验证,专有名词本身就容易出错,因此常被过滤掉。数据稀缺导致声学模型和语言模型都存在难以覆盖的漏洞。
上下文不足
比如同音字,如果脱离上下文,我们说“wǔbǎi”,到底是“五百”还是“伍佰”?语音识别系统需要根据上下文判断是指歌手伍佰,还是指五百块钱。再比如地名“Jí’ān”——吉安在江西,集安在吉林,如果没有地理位置信息,系统也无法区分。
专有名词增强适用于什么场景
专有名词在语音识别任务中通常也称为“热词”。增强热词对后续的语义理解非常关键,因为这些名词信息量大、重要性高。在很多场景中,我们无法通过快速收集数据来迭代模型,这时就需要热词增强技术进行干预。
垂直领域
垂直领域专有名词增强是应用最广泛的,涵盖各类垂直场景以及姓名、地名等,这里不再赘述。
可见即可说
所谓“可见即可说”,比如在导航、电子菜单、地铁购票等场景,屏幕上显示的专有名词可被抓取为关键词,让用户看到什么就直接说什么。同样,它也适用于多模态交互场景,比如拍照问答等。
网络新词动态增强
网络词汇更新快、时效性强,这些新造词往往在历史词库中不存在,比如近期流行的“老己”。
热词增强的几种方法
随着语音识别框架的发展,热词增强策略也呈现出几种趋势:
逐渐从后处理转移到前端增强 从独立模块转变为模型的一部分,联合优化 从零散的关键词处理,发展到上下文工程,再到音频-文本多模态融合
大多数语音识别 API 都支持热词增强,在发起识别请求前配置热词即可,这无疑是最简单的方式。下面再具体介绍几种业界常用的方法,即使不重新训练模型,也能使用热词增强技术。
1. 基于 WFST 的热词增强
基于 WFST 的热词增强从 Kaldi 时代到 CTC 等端到端时代都有应用,它是一种独立的、后处理技术。
简单来说,是通过人为提高某些词汇在解码图中的权重,在解码过程中增加这些词的出现概率,从而达到增强效果。
基于 WFST 的技术需要对有限状态机进行操作,门槛较高,在 LLM 时代显得有些过时。与完全分离的后处理纠错不同,它结合了发音分数和语言模型分数,在热词增强上效果仍然更好。WeNet [1] 工具包中都有相关实现,感兴趣的朋友可以深入了解。
2. 完全使用大模型后处理
最简单的方法是使用大模型进行纠错,并辅以热词列表。
这种方法虽然简单,但效果一般。由于缺乏声学信息,完全依赖文字发音相似度和语义,如果词表过大,不仅 token 消耗多,也容易产生混淆。可参考我们早期的论文 [2] 和近期论文 [3],先对关键词进行大致过滤。
这种方式会增加一定延迟,下面第 3 种方法是它的改进版。
3. 关键词检出模型 + 大模型后处理
如果你正在使用自己的 ASR 模型,但它缺乏热词增强能力或效果不佳,我非常推荐尝试这种方法。
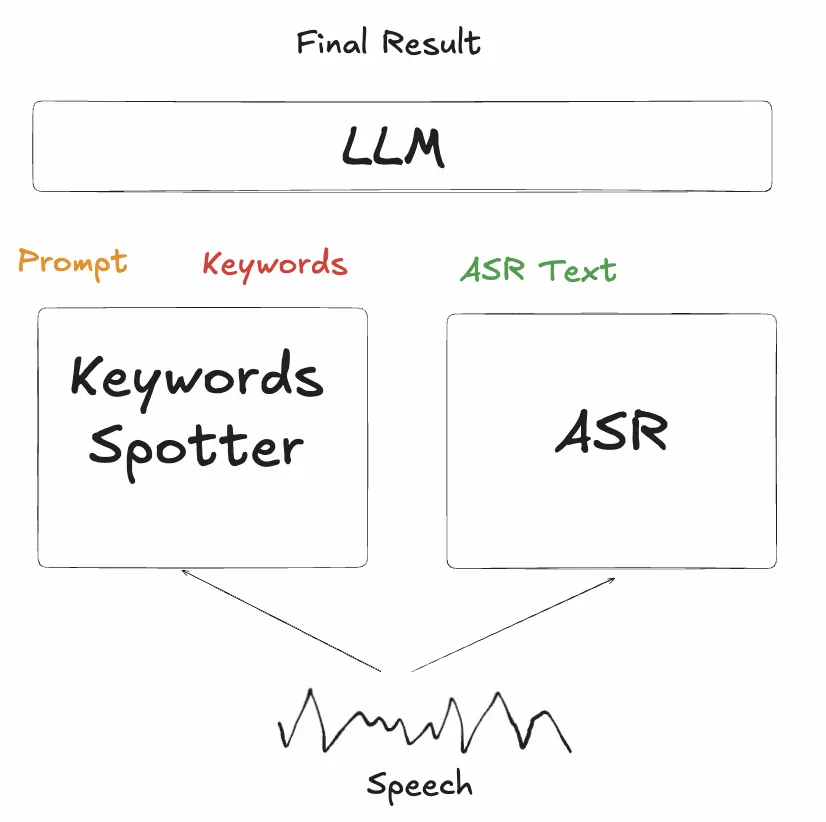
如图所示,使用一个开源的自定义关键词检出系统和一个 ASR 系统(可具备或不具备热词增强能力)。相比于 ASR,自定义关键词检出系统非常轻量,对关键词检出任务效果有较好保证。比如小米开源的 KWS 模型 [4],支持在识别过程中动态更新关键词。通过 KWS Spotter 获取关键词信息后,相当于对词表进行过滤和精确化,大模型纠错会更有针对性。
4. 前置关键词参与模型训练
在基于自回归大模型的语音识别框架中,文本关键词作为提示词的一部分,可自然地融入模型训练。这种方法其实并不新鲜,在早期的端到端论文中就已有尝试,一般称为 Context Bias。
相比于后置关键词增强,将文本关键词和声学模型在早期融合、联合训练,无疑在衡量文本与语音关联性上更具优势。比如近期论文 [3] 通过文本-语音多模态相似度比对进行关键词筛选,并引入强化学习方法奖励热词匹配。
如果具备模型训练能力,这无疑是目前的最优解。在长文本识别中,也可以动态提取可能的关键词进行增强。
总 结
热词增强是一项工程性较强的工作,除了模型层面,还涉及关键词获取、过滤、召回、匹配等一系列工程优化。在实际业务中,关键词增强也无法解决所有问题,它只是一个补充手段,大家可根据业务和模型情况,选择上述方法进行尝试。
