
 语音小管家
标题:Speech-Hands: A Self-Reflection Voice Agentic Approach to Speech Recognition and Audio Reasoning with Omni Perception
链接:https://arxiv.org/pdf/2601.09413
作者单位:NVIDIA、京都大学、卡内基梅隆大学
发表日期:2025年1月15日
01、背景:为啥需要“自我反思”?
02、核心创新点:用“动作token”做决策
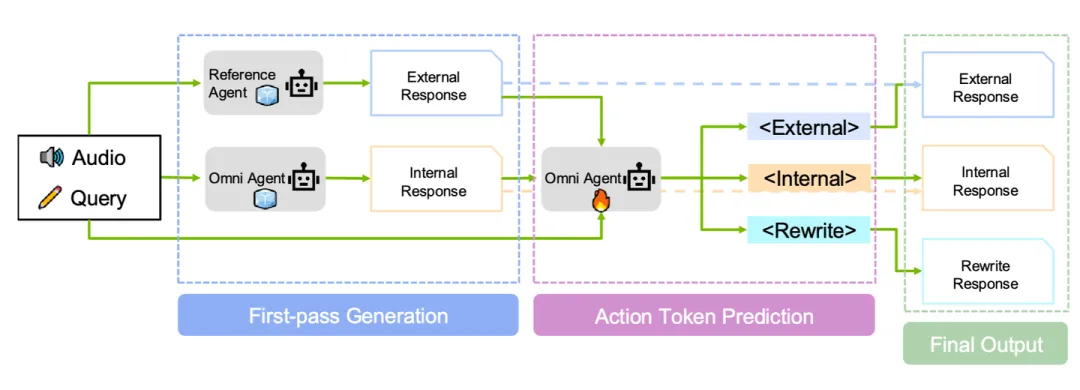
:信自己——自己的结果靠谱,直接用; :信外部——自己的结果不行,用外部模型的结果; :重新来——自己和外部的结果都不行,结合音频和所有信息重新生成。
ASR场景:看WER。对每个音频,先让模型自己出转录结果(Tint),再拿外部ASR模型出结果(Text),最后让模型结合两者+音频再出一个“重新生成结果(Tger)”。然后算这三个结果和“标准答案(Tgt)”的WER: 要是Tint的WER最低(甚至为0,全对),就贴 ; 要是Text最低,贴 ; 要是Tger最低,贴 。
Audio QA场景:看“对不对”。每个问题有选项(比如“这是地震还是雷暴?”),先让模型自己预测(Cint),再拿外部模型预测(Cext): 自己对了(Cint=标准答案),贴 ; 自己错、外部对(Cext=标准答案),贴 ; 都错,贴 。
这里还有个小优化:外部模型的预测可能不稳定(比如同个音频跑5次出5个结果),所以作者会让外部模型跑5次,多数对才算“外部对”,避免偶然误差。
训练:把“动作token + 最终结果”拼在一起当目标(比如 we’ve water and fresh stores to take on there),用交叉熵损失端到端训——模型既要学“选哪个token”,也要学“选完token后怎么出结果”。 推理:分两步。第一步先预测动作token(比如先算出该用 );第二步根据token生成最终结果(比如直接用外部模型的正确答案)。
03、实验:到底好不好用?
基础模型:用的是Qwen2.5-Omni(多模态大模型,能处理音频和文本); 数据集: ASR:7个OpenASR数据集,覆盖不同场景——比如AMI是会议语音(噪声多)、Tedlium是TED演讲(清晰)、LibriSpeech是有声书(分干净/嘈杂版); Audio QA:MD-Audio基准的3个子集——Bio-acoustic QA(比如“这是哪种海洋哺乳动物的声音”)、Soundscape QA(比如“这是城市还是农村的声音”)、Complex QA(需要推理的,比如“音频里先出现的是狗叫还是汽车声”);
基线模型: ASR:Whisper-v2-large、Canary-1B-v2、Parakeet-TDT0.6B-v3(纯ASR模型),还有Phi-4-MM、Gemini-2-Flash、GPT-4o-voice(多模态模型); Audio QA:Audio Flamingo 3(专门做音频推理的模型)、Qwen2.5-Omni普通微调版;
训练细节:训5个epoch,用fp16精度,batch size 64,学习率1e-4(余弦衰减),推理用贪心解码。
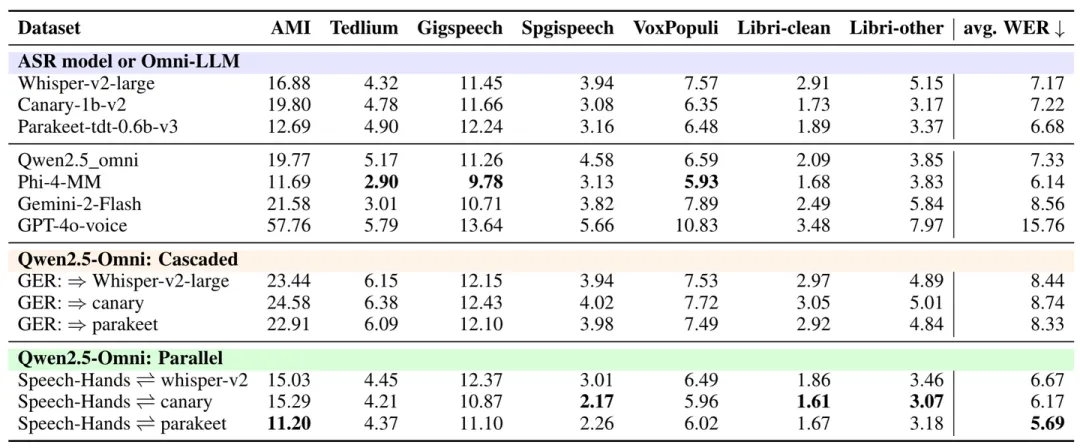
对比纯ASR模型:Whisper-v2-large平均WER是7.17,Speech-Hands和Whisper结合后,平均WER降到6.67;更强的Parakeet模型(原本平均WER6.68)和Speech-Hands结合后,平均WER直接降到5.69——这是所有结果里最低的; 对比多模态模型:Phi-4-MM原本是基线里最好的(平均WER6.14),但Speech-Hands(5.69)还是比它低;GPT-4o-voice表现最差(15.76),差远了; 对比“盲目级联”:Qwen2.5-Omni原本级联Whisper做GER,平均WER8.44,而Speech-Hands用同样的Qwen+Whisper,WER降到6.67——说明“选token”的机制真的有用,不是瞎训。
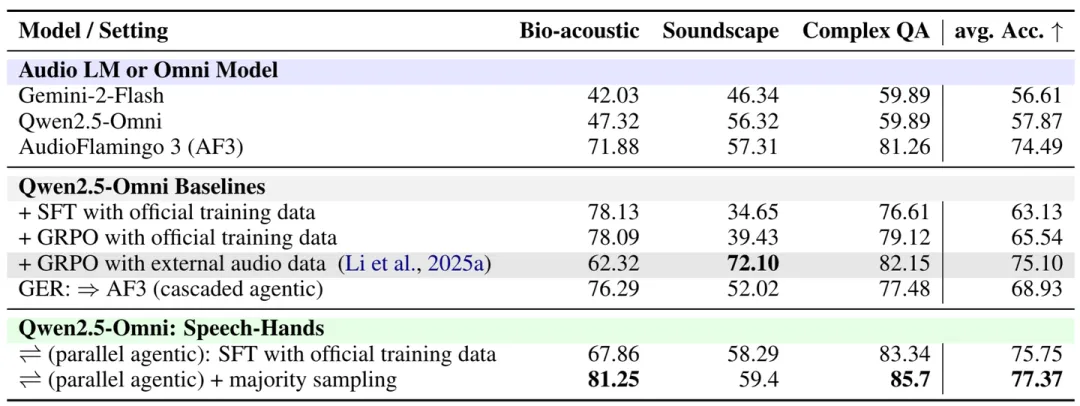
平均准确率:Speech-Hands+多数采样(用来稳定外部预测)达到77.37%,比最好的基线(Audio Flamingo 3的74.49%)还高; 分场景看: Bio-acoustic QA:81.25%,比普通微调的Qwen(78.13%)高; Complex QA:85.70%,是所有结果里最高的——说明模型能处理需要推理的任务; Soundscape QA:59.40%,虽然不算特别高,但比普通微调的Qwen(34.65%)好太多了——普通微调在Soundscape任务里直接“崩了”,而Speech-Hands因为能选token,鲁棒性强。
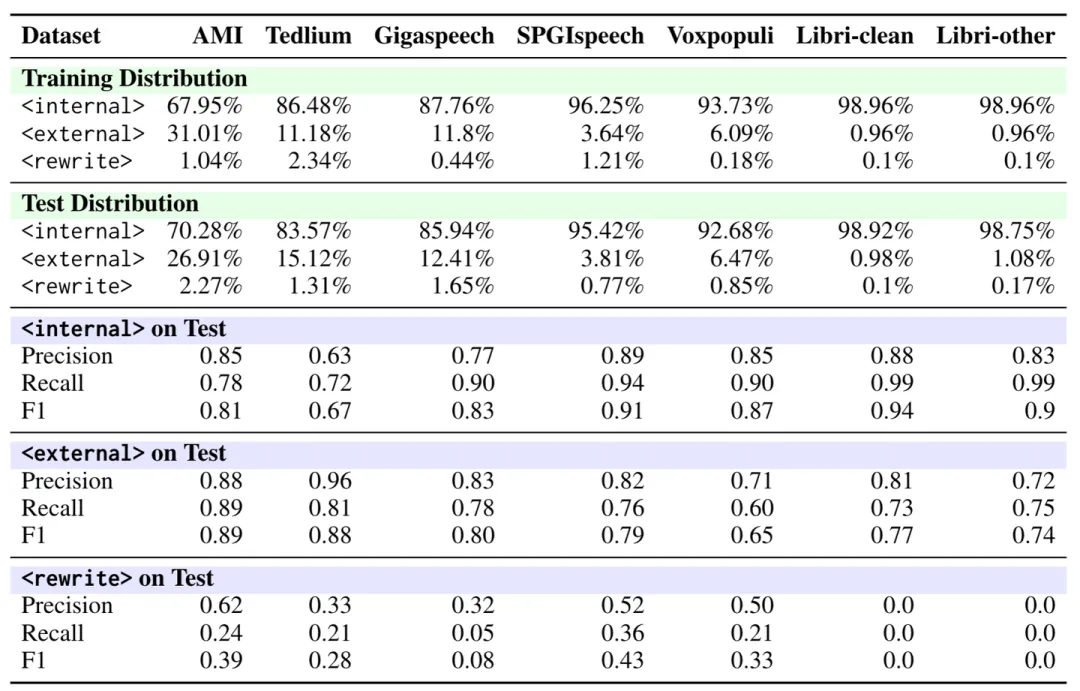
分布不平衡: 占比最高(比如Libri-clean里98.96%,因为这个数据集干净,模型自己就能做对), 最少(大多低于2%,因为需要“都错”才触发); 但选得很准: 的F1很高,比如Libri-clean里0.94、SPGISpeech里0.91——说明模型能靠谱地判断“自己啥时候对”; 的F1也不错,比如AMI里0.89、Tedlium里0.88——就算外部样本少,模型也能学会“啥时候该信外部”; 的F1低(大多低于0.4),但精度高、召回低——意思是“一旦模型选了 ,基本都是对的,但很多该选 的情况没选到”,主要是因为训练样本太少,后续可以用数据增强补。
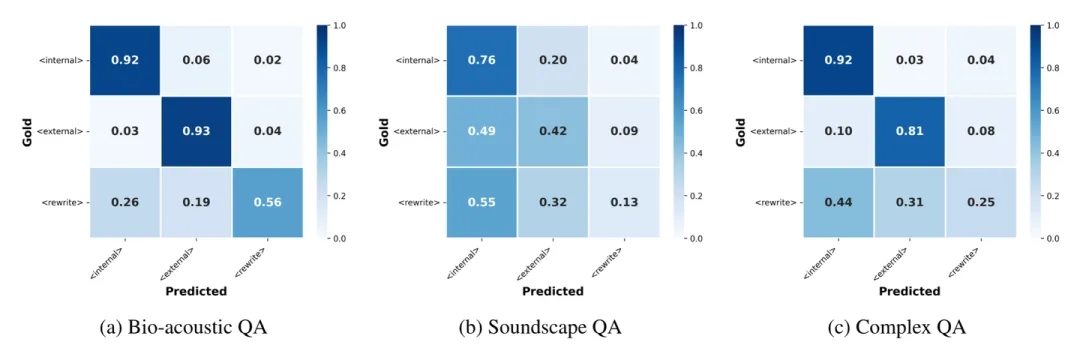
和 的混淆很少,尤其是Complex QA里——说明模型能清晰区分“信自己”和“信外部”; Soundscape QA里混淆多一点,因为声景任务本身难,模型和外部的结果差距小,容易判断错,但总体影响不大。
Audio QA案例 :
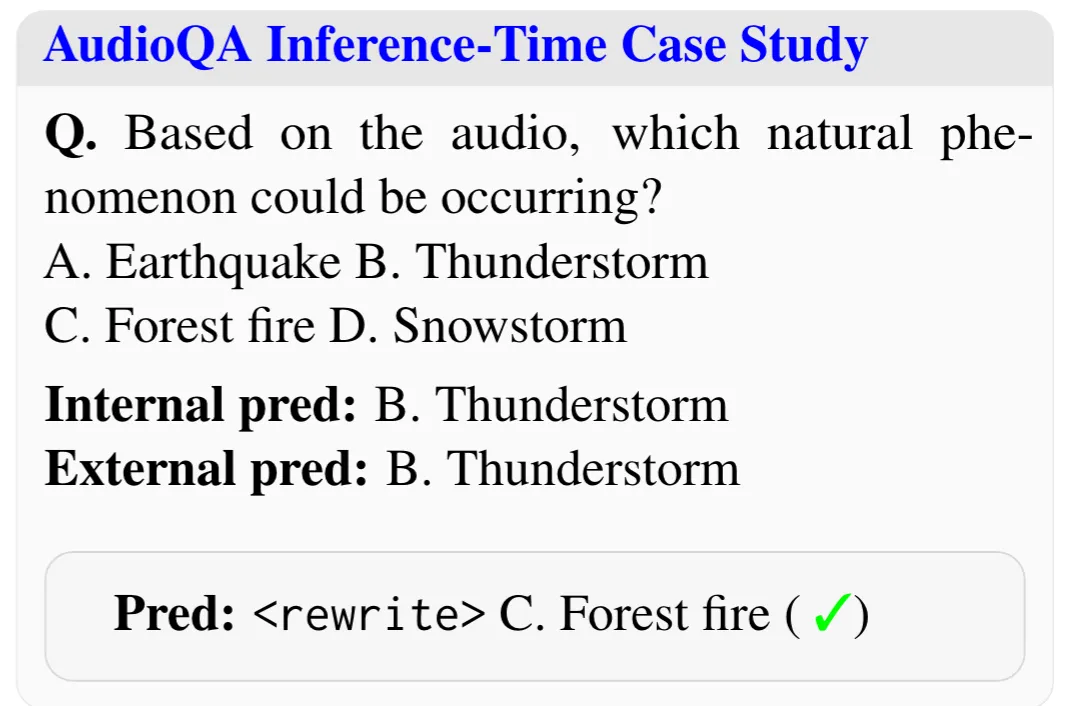
问题是“音频里的自然现象是啥?”,选项有地震、雷暴、森林火灾、暴风雪。模型自己和外部模型都预测“雷暴(B)”,但Speech-Hands选了 ,重新生成“森林火灾(C)”——结果对了!因为音频里可能有“森林火灾”的细节(比如噼啪声),模型通过重新分析音频,没被“多数错误”带偏;
ASR案例:
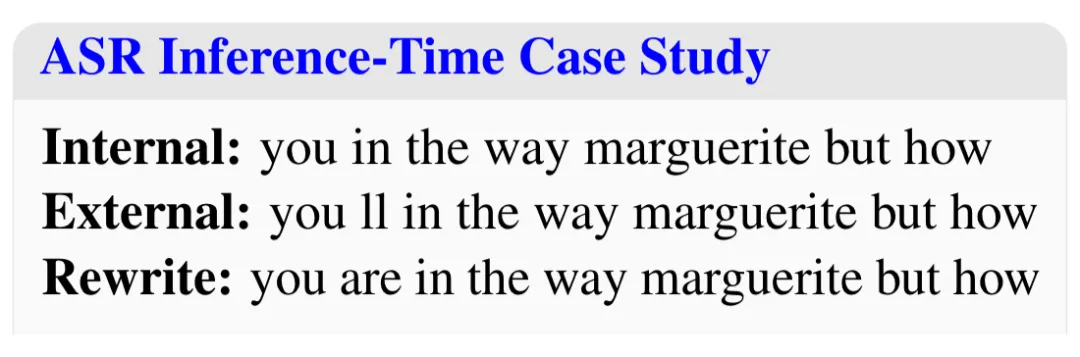
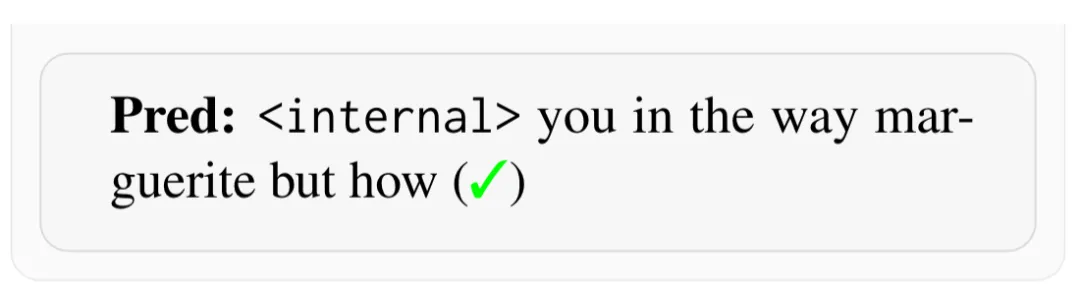
模型自己的结果是“you in the way marguerite but how”,外部模型结果类似。Speech-Hands选了 ,直接用自己的结果——而之前的GER会过度修正成“you are in the way…”(反而错了),说明模型学会了“不用瞎改”。
04、局限和未来方向
token不平衡 : 的样本太少,导致模型触发它的概率低,后续需要用数据增强或调整标签规则来平衡; ASR训练数据少 :现在每个数据集只训了2万条,要是用更多数据,性能可能还能涨; 没做迁移和多外部模型 :比如训的时候用A外部模型,测的时候用B外部模型,能不能行?还有现在只接一个外部模型,要是接多个,怎么选?这些还没试。
05、总结
