
 语音小管家
近日,ICASSP 2026会议发出了审稿结果通知,上海交通大学跨媒体语言智能实验室共12篇论文被会议接收。我们将用两期推送介绍接收论文,本文是第一期。
01、Measuring Prosody Diversity inZero-Shot TTS: A New Metric,Benchmark,and Exploration
论文作者:杨亦凡*,韩冰*,王卉,周龙,王巍,崔明宇,谭旭,陈谐
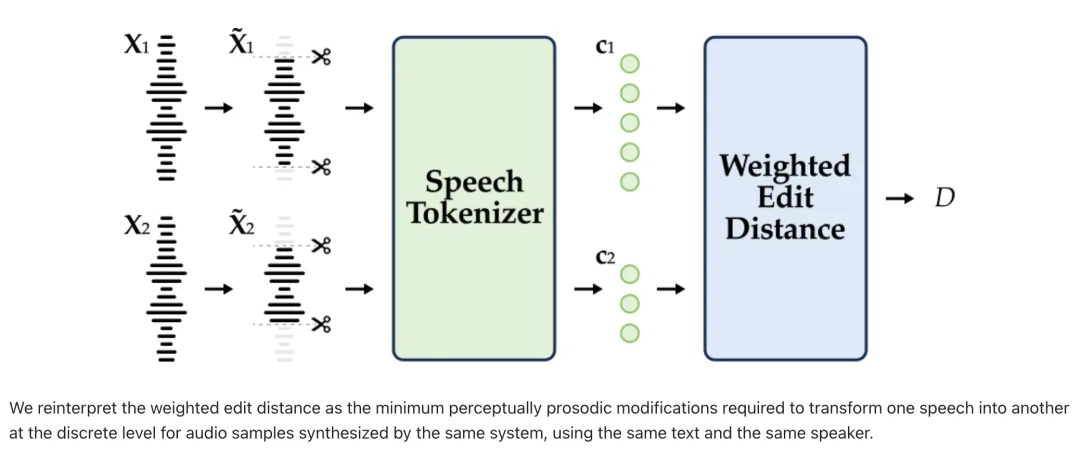
论文简介:韵律多样性对于实现零样本文本到语音(TTS)的自然性和表现力至关重要。然而,常用的声学指标仅片面地刻画韵律变化,并且与人类主观感知的相关性较低,这使得如何可靠地量化韵律多样性这一问题长期缺乏系统研究。为弥补这一空白,我们提出 ProsodyEval,一个用于评估韵律多样性的基准数据集,在提供传统声学指标的同时,引入了韵律主观平均评分。ProsodyEval 包含来自 7 种主流 TTS 系统的 1000 条语音样本,并收集了 2000 条人工评分。在此基础上,我们进一步提出 离散化语音加权编辑距离(DS-WED),这是一种新的客观多样性度量方法,通过对语义 token 序列计算加权编辑距离来量化韵律变化。基于 ProsodyEval 的实验结果表明,DS-WED 与人类主观判断的相关性显著高于现有声学指标,同时在使用 HuBERT 和 WavLM 进行语音 token 化时仍表现出很强的鲁棒性。借助 DS-WED,我们在 LibriSpeech test-clean 和 Seed-TTS test-en 上对多种最新开源 TTS 系统进行了系统评测,并进一步分析了影响韵律多样性的若干关键因素,包括生成建模范式、时长控制机制以及强化学习。此外,我们还发现,当前的大规模音频语言模型(LALMs)在捕捉韵律变化方面仍然存在明显局限。音频示例可访问:https://prosodyeval.github.io。
完整论文:https://arxiv.org/abs/2509.19928
项目仓库:https://github.com/yfyeung/DS-WED
02、AUV: Teaching Audio Universal Vector Quantization with Single Nested Codebook
论文作者:陈禹伸,胡凯,周龙,冯树林,杨绪升,陈航艇,陈谐
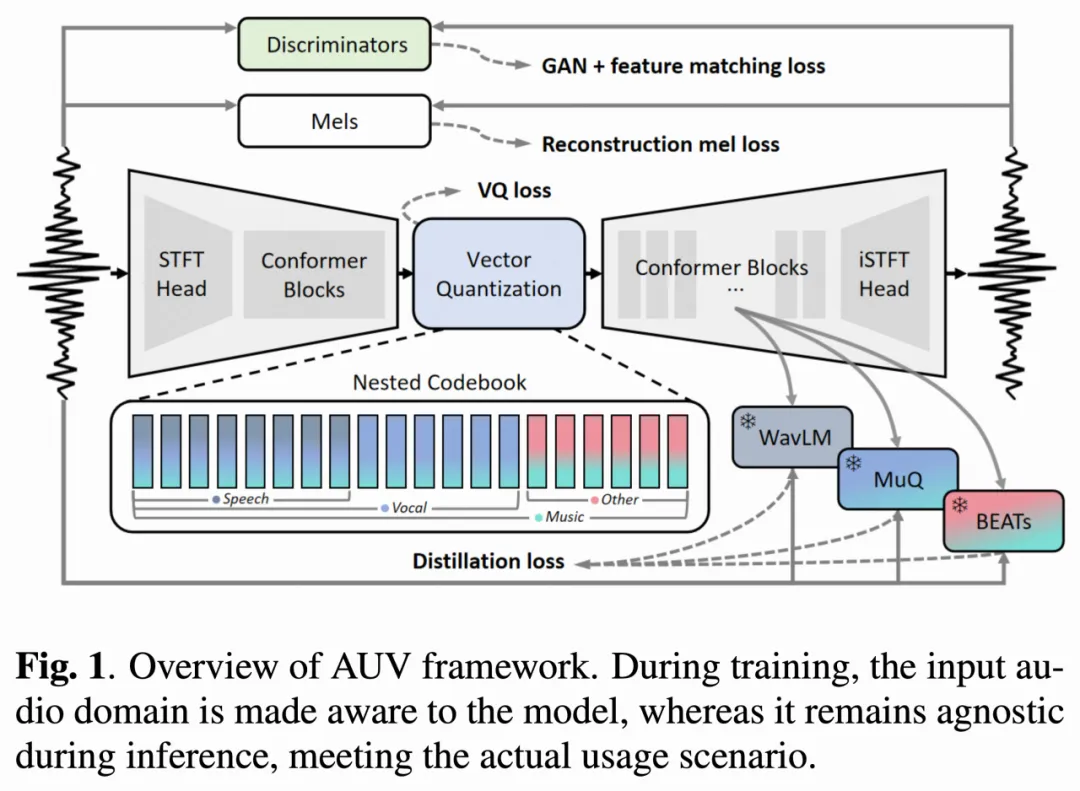
论文简介:我们提出了一个统一音频编解码器——AUV ,仅用单码本支持语音域样本的良好重建,并进一步扩展到包括人声、音乐和环境音等在内的通用音频之上。AUV 能够以约 700 bps 的比特率处理任何 16kHz 的混合音频片段。为实现该目标,我们采用音频域相关的嵌套分区方案来隐式指导模型的表征学习,并分配对应训练数据源领域(语音/人声/音乐/非人声音频)的各教师模型进行蒸馏;所有设计都在单阶段训练中完成。架构上,我们以 STFT 特征作为输入输出,和基于Conformer编解码器结构,有更好的音频重建质量。经过全面评估表明,AUV 在音频重建能力上与目前先进的特定领域的单层神经音频编解码器相当,并进一步展现了以单码本支持通用音频的潜力。AUV的预训练模型权重和样本示例见https://swivid.github.io/AUV/。
完整论文:https://arxiv.org/abs/2509.21968
项目仓库:https://github.com/SWivid/AUV
03、MOSA: Mixtures of Simple Adapters Outperform Monolithic Approachesin LLM-based Multilingual ASR
论文作者:李俊杰,彭景,方衍贵,王帅,俞凯
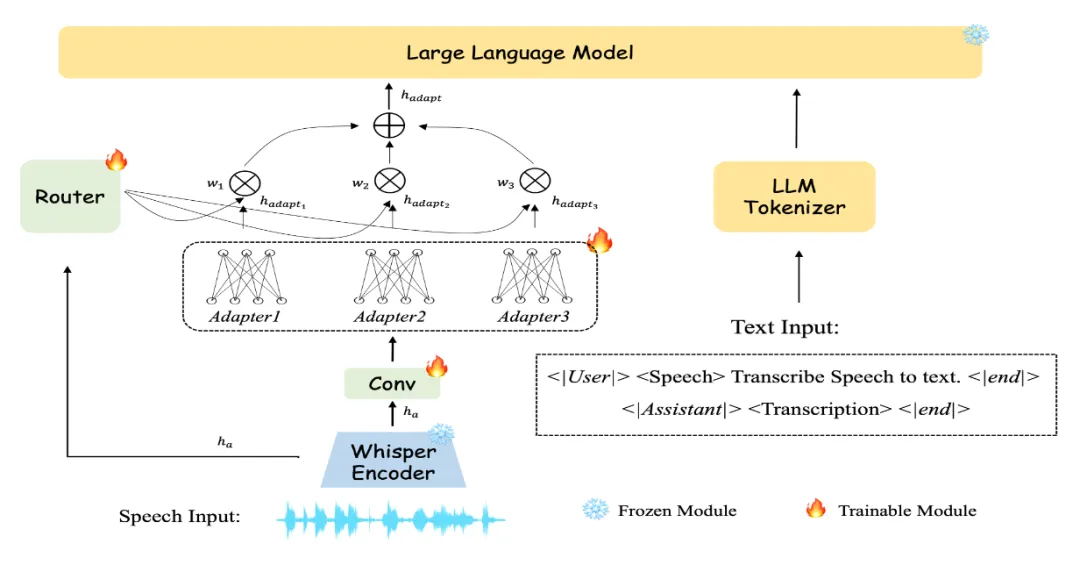
论文简介:针对端到端多语种语音识别面临的数据稀缺及传统单一投影器建模能力的瓶颈,我们提出了MOSA (Mixtures of Simple Adapters) 架构。不同于以往依赖复杂单一投影器的方法,MOSA 引入混合专家机制(MoE),通过组合多个轻量级适配器,实现了跨语言共享知识与特定语言独有特征的高效解耦与协同学习,从而让高资源语言能显著辅助低资源语言。实验数据表明,在训练参数量仅为Ideal-LLM Base的60%的情况下,平均词错误率(WER)仍大幅降低了 13.3%,展现出卓越的参数效率与对数据不平衡的强鲁棒性;这一结果有力证明了在基于LLM的多语种语音识别任务中,多专家简单适配器混合的设计范式远优于单一复杂适配器,为多语言模型的高效优化开辟了新路径。
完整论文:https://arxiv.org/abs/2508.18998
04、TASU: Text-Only Alignment for Speech Understanding
论文作者:彭景,杨熠,李旭,奚彧,唐权威,方衍贵,李俊杰,俞凯
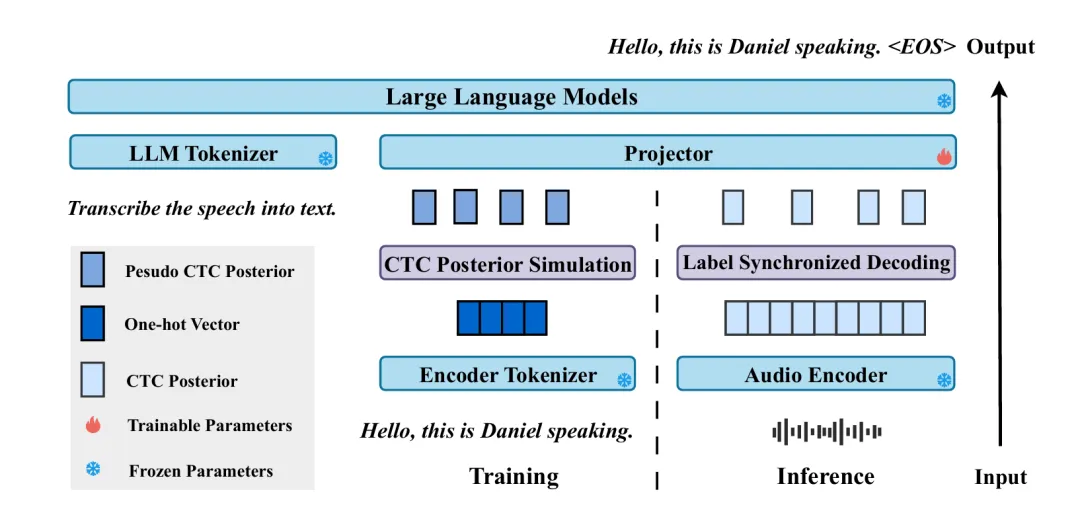
论文简介:近年来,语音大语言模型(Speech Large Language Models, Speech LLMs)的快速发展为在统一架构下覆盖多种语音理解任务奠定了基础。然而,现有主流的对齐范式高度依赖大规模语音—文本成对数据与高计算开销的训练流程,并且在面对未见领域或新任务时往往泛化能力有限。为解决上述问题,我们提出TASU(Text-only Alignment for Speech Understanding)——一种全新的对齐范式,能够仅利用非配对文本数据来引导跨模态对齐。实验结果表明,TASU 在零样本语音识别上取得了具有竞争力的表现。基于这一特性,TASU 还可作为课程学习(curriculum learning)中的预训练阶段,进一步提升语音识别的跨域泛化能力。更进一步,TASU 的零样本泛化能力能够扩展到更广泛的语音理解任务上,并在MMSU基准测试中显著优于包括GLM-4-Voice与Step-Audio在内的代表性 Speech LLMs,从而确立了 TASU 作为一种高效、可扩展的 Speech LLM 对齐范式。
完整论文:https://arxiv.org/abs/2511.03310
项目仓库:https://github.com/PigeonDan1/ps-slm
05、ISA-Bench: Benchmarking Instruction Sensitivity for Large Audio Language Models
论文作者:李波含,黄文宾,邱雨航,郭奕玮,王翰坤,李之涵,彭景,马子阳,陈谐,俞凯
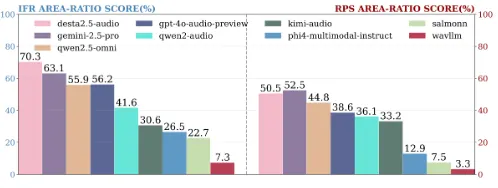
论文简介:大型音频语言模型(LALMs)通过将声学感知与大语言模型(LLMs)相结合,从音频中提取并理解多样化信息,近年来引起了学术界和工业界的广泛关注。然而,现有LALMs对指令表述方式高度敏感,这既影响(i)指令遵循率,也影响(ii)任务性能。目前尚无基准测试能够对此敏感性进行系统且全面的评估。为此,我们提出了ISA-Bench,一个动态基准测试,从指令描述、输出格式和任务构成三个维度评估LALMs的指令敏感性。我们利用ISA-Bench对近期的开源与专有LALMs进行了评估,在受控的指令变化下分析模型的遵从性与准确性。实验结果表明,即使是最先进的LALMs也存在显著的指令敏感性,导致其在基础音频理解任务上性能下降。为缓解这一问题,我们在专门构建的复杂指令变体数据集上对Qwen2-Audio进行微调,在指令遵循性能上取得了显著提升。但这也引发了不可忽视的灾难性遗忘:模型在接触新指令风格时丧失了一些先前掌握的任务能力。本基准测试为评估和提升LALMs的指令敏感性提供了标准化基础,强调了在实际应用流程中实现指令鲁棒的音频理解的必要性。
完整论文:https://arxiv.org/abs/2510.23558
项目仓库:https://github.com/bovod-sjtu/ISA-Bench
06、Robust and Efficient Autoregressive Speech Synthesis with Dynamic Chunk-wise Prediction Policy
论文作者:李波含,李之涵,王浩然,张杭磊,郭奕玮,王翰坤,俞凯
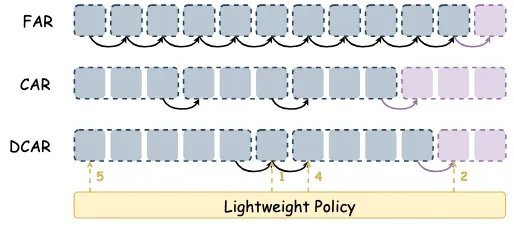
论文简介:最近,自回归(AR)语言模型已成为语音合成领域的主流方法,具备可扩展的训练能力和富有表现力的生成效果。然而,基于逐词元预测的传统AR模型在处理长语音序列时表现不佳,往往难以构建稳定的帧间注意力机制,导致延迟增加、合成质量下降,限制了其实时应用潜力。为此,我们提出DCAR,一种动态分块自回归语音合成框架,旨在提升合成效率与可懂度鲁棒性。DCAR采用多词元预测训练方式,通过轻量化的在轨(on-policy)模块实现可变跨度的分块预测。通过动态调整预测跨度,该框架在保持高合成质量的同时降低了对序列长度的依赖。实验结果表明,DCAR显著优于传统逐词元预测模型,可懂度提升高达72.27%,推理速度加快2.61倍。进一步分析也证实了其作为下一代语音合成通用基础模型的潜力。
