
 语音小管家
通义实验室语音团队提出一种基于心理学 PAD 模型的情感语音合成框架,支持用户在愉悦度(Pleasure)、唤醒度(Arousal)和支配度(Dominance)上灵活控制情感表达。无需依赖固定情感标签,就能自由组合出“温柔但坚定”“兴奋而顺从”等细腻语气。该工作已被 ICASSP 2026 接收。
本次共有13篇论文被 ICASSP 2026收录,覆盖持续学习防遗忘、端到端回声消除、语言引导声源定位、生成式语音增强、自适应鲁棒前端、增量声源定位、多模态音乐分离等多个方向。以下为各工作的简要介绍:
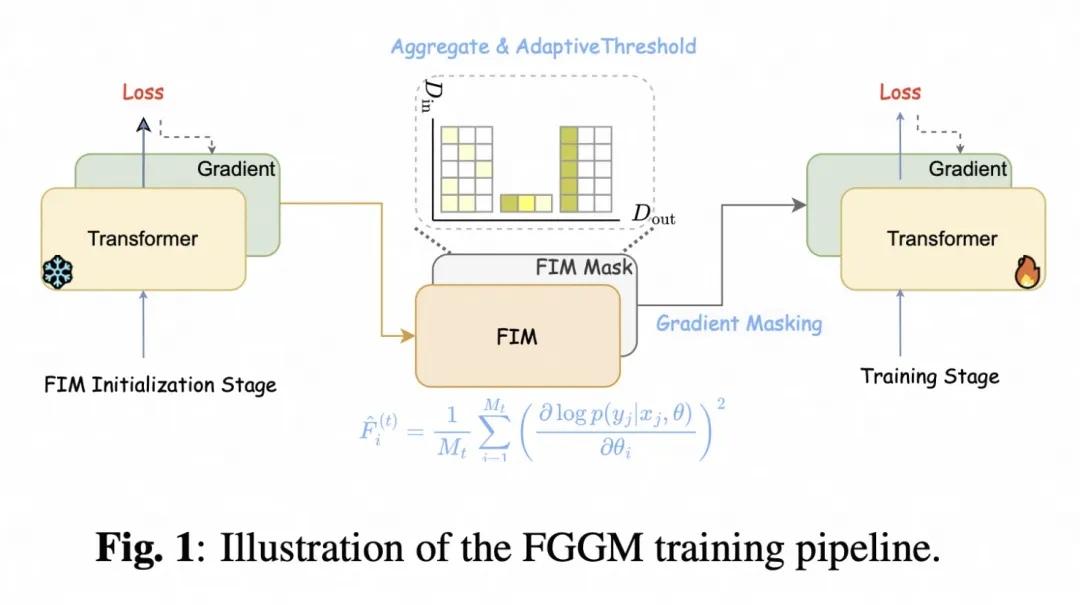
01、FGGM: FISHER-GUIDED GRADIENT MASKING FOR CONTINUAL LEARNING
作者列表:谭超鸿,陈谦,王雯,马煜坤,张冲,邓憧,张庆林,李先刚,叶杰平
论文单位:通义实验室语音团队
论文下载地址:https://arxiv.org/abs/2601.18261
02、MELA-TTS: JOINT TRANSFORMER-DIFFUSION MODEL WITH REPRESENTATION ALIGNMENT FOR SPEECH SYNTHESIS
作者列表:安柯宇,章之禹2,高长丰,李亚滨,彭震东,王浩旭,杜志浩,赵瀚,高志付,李先刚
论文单位:1、通义实验室语音团队,2、东南大学
核心内容:以CosyVoice为代表的依赖音频离散化的多阶段模型已成为目前语音合成的主流范式之一。音频离散化使得团队可以沿用 next token prediction 范式去建模音频,在语音合成、音色克隆等任务中取得了不错的效果。然而,离散化会不可避免地造成信息损失,从而损伤自然度等听感指标,也会导致整个合成流程相对复杂。
鉴于此,团队提出了MELA-TTS,联合自回归 transformer 和 DiT 模型直接进行 mel 频谱预测,而无需离散 token 作为中介。在此基础上,团队创新性地引入了表征对齐模块,将自回归 transformer 输出的中间表征与一个预训练语音识别(ASR)编码器的语义表征进行对齐。该机制不仅加快了模型的训练收敛速度,还有效提升了文本域与声学域之间的跨模态一致性。
大量实验结果表明,MELA-TTS 在离线和流式两种合成模式下,在多项评估指标上均取得了当前最优性能,同时保持了优异的零样本语音克隆能力。与基于离散表征的模型相比,MELA-TTS 在相关测评上表现出显著的优势。
论文下载地址:https://arxiv.org/abs/2509.14784
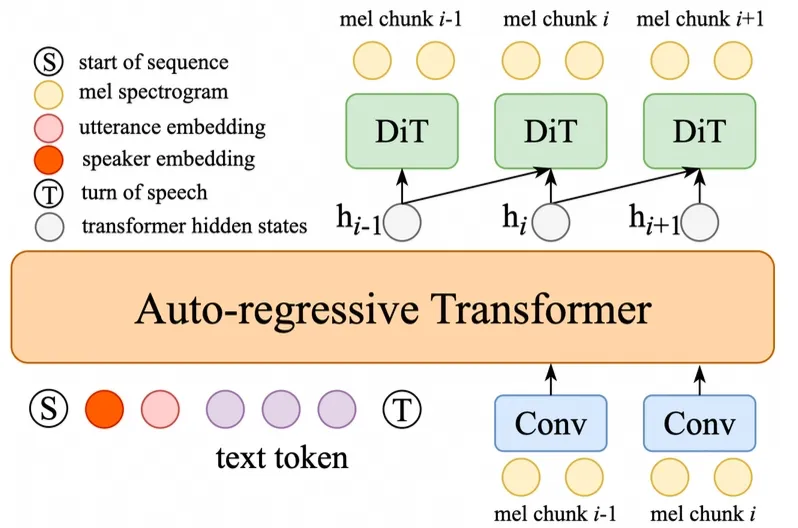
MELA-TTS 结构图
03、FlowSE-GRPO: Training Flow Matching Speech Enhancement via Online Reinforcement Learning
作者列表:王浩旭,田彪,蒋逸恒,潘泽煦,赵胜奎,马斌,陈达人,李先刚
论文单位:通义实验室语音团队
核心内容:生成式语音增强(Generative speech enhancement)通过对在噪声输入条件下的干净语音分布建模,为传统判别式方法提供了有前景的替代路径。后训练对齐(post-training alignment)通过强化学习(Reinforcement Learning,RL)在自然语言处理等领域已被证明能将生成模型与人类偏好及下游指标对齐,但在语音增强领域的应用仍然有限,尤其是在线强化学习方面。已有工作探索了像直接偏好优化(Direct Preference Optimization, DPO)这样的离线方法;而诸如群体相对策略优化(Group Relative Policy Optimization, GRPO)等在线方法则基本未被研究。
在本文中,团队首次将在线强化学习 GRPO成功集成到一个Flow-Matching(流匹配)语音增强框架中,实现了对感知类和任务导向指标的高效后训练对齐,仅需少量更新步骤。与以往在大规模语言模型(Large Language Model,LLM)上开展的 GRPO 工作不同,团队将该算法适配于语音的连续时序特性及流匹配生成模型的动力学。
作为一种基于 on‑policy 的强化学习后训练过程,且无需修改其原始架构(不同于 F5R‑TTS),该在线 RL 方法可对基础模型进行微调,提升感知质量包括 DNSMOS、SpeechBERTScore 和说话人相似度(Speaker Similarity)等客观指标。团队系统研究了用于提升语音增强指标的GRPO 训练配置,实验表明,单一奖励的优化虽能快速提升指标,但常导致“奖励投机”(reward hacking),使得音频保真度下降即便评分更高。为缓解此问题,团队另外提出了一种多指标奖励优化策略,平衡互相竞争的目标,显著降低过拟合并提升整体性能。团队的实验验证了在线强化学习 GRPO 在语音增强中的可行性,并为基于 RL 的生成式音频模型后训练提供了实用指导。
论文下载地址:https://arxiv.org/abs/2601.16483
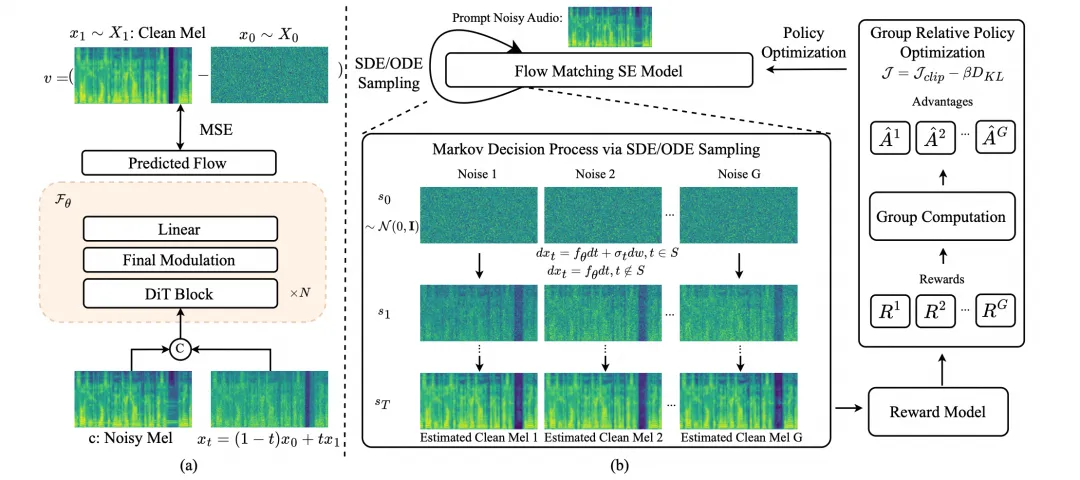
(a) 基于Flow-Matching的语音增强模型的架构. (b) 用GRPO进行后训练的流水线。
04、E2E-AEC: Implementing an End-to-End Neural Network Learning Approach for Acoustic Echo Cancellation
作者列表:蒋逸恒,田彪,王浩旭,赵胜奎,马斌,陈达人,李先刚
论文单位:通义实验室语音团队
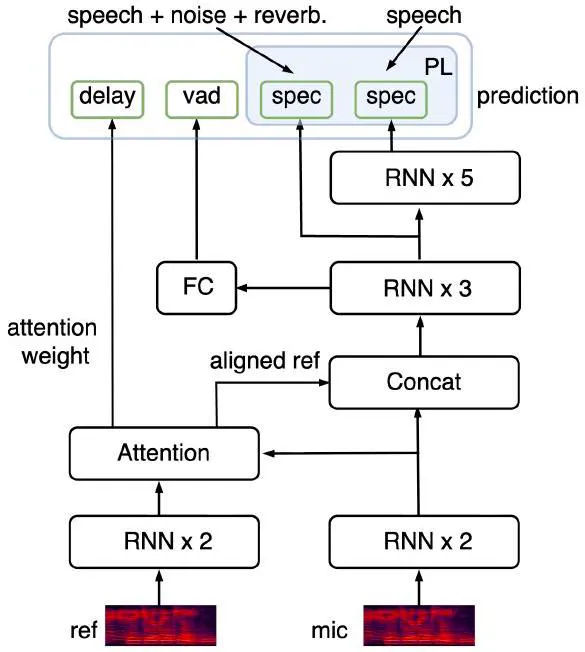
核心内容:该论文提出了一种全新的端到端(End-to-End, E2E)神经网络声学回声消除方法,无需依赖传统基于自适应滤波器的线性回声消除(LAEC)和显式的时间延迟估计(TDE),同时支持流式推理,在多个公开数据集上展现出优异性能。
核心创新点如下:
改进的渐进式学习(Progressive Learning, PL)策略:将回声消除任务分解为两个阶段,第一阶段专注于去除主要回声成分,第二阶段进一步抑制残余回声、背景噪声和混响。这种分阶段目标设计显著降低了模型优化难度,提升了处理后的整体语音质量。
知识迁移(Knowledge Transfer)机制:利用在混合系统(含 LAEC 模块)上预训练的神经网络参数初始化端到端模型,有效继承了传统方法在时间对齐和初步回声抑制方面的先验知识,加速收敛并提升鲁棒性。
带监督损失的注意力对齐机制:引入注意力机制实现参考信号与麦克风信号的动态软对齐,并首次在注意力权重上施加显式监督损失(MSE 或交叉熵),引导模型学习更精确的时间延迟估计,解决了端到端建模方法在大延迟场景下性能下降的问题。
结合语音活动检测(VAD)的输出掩蔽策略:在网络中间层预测近端语音 VAD,并在推理时对无近端语音的帧施加幅度衰减掩蔽,显著提升远端单讲场景下的回声抑制能力(ERLE高达78.69 dB、近端语音 DMOS 保持 4.42)。
该方法具有以下优点:
完全端到端、无需传统模块:摆脱了对 TDE 和 LAEC 等传统信号处理模块的依赖,简化系统架构,具备 Scaling 潜力,适用场景广泛。
支持实时流式处理:采用单向 GRU 结构,满足低延迟实时通信需求(如手机、AI 眼镜、智能音箱、视频会议、车载语音等)。
综合性能领先:在 AEC Challenge 2023/2022 盲测集上,所提 E2E-AEC 在AECMOS(主观语音质量)和 ERLE(客观回声抑制)指标上均优于现有先进方法(包括 SOTA 模型 DeepVQE ),证明其在真实复杂声学环境中的实用潜力。
模块化设计具有通用性:本文所提端到端 AEC 方法具备可复现和可实现性,同时所提出的PL、知识迁移、对齐损失和VAD掩蔽等策略可迁移至其他语音增强或端到端语音前端任务中。
该工作不仅推动了端到端 AEC 从理论走向工业落地,也为下一代语音交互系统提供了高效、鲁棒且高质量的解决方案。
论文下载地址:https://arxiv.org/abs/2601.16774
05、LuSeeL: Language-queried Binaural Universal Sound Event Extraction and Localization
作者列表:潘泽煦,赵胜奎, 马煜坤, 王浩旭, 蒋逸恒, 田彪, 马斌
论文单位:通义实验室语音团队
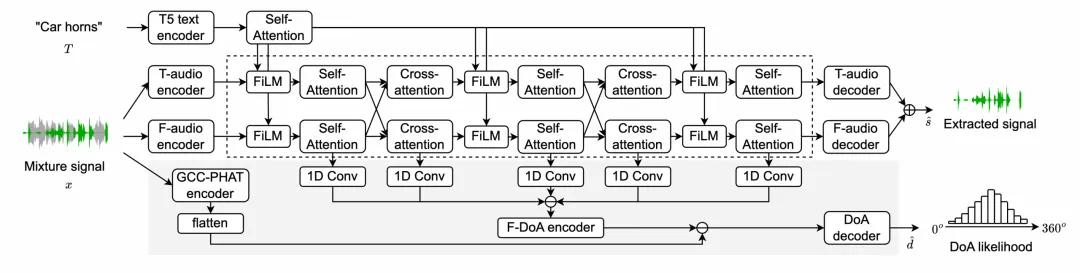
核心内容:本文提出LuSeeL,面向三维听觉场景的“用一句话点名并找出声音”。现有通用声事件提取多基于单通道音频,只能做“频谱里找目标”,难以利用空间信息,在多声源重叠时易混淆;同时,大多数定位方法只支持有限类别、且与通用提取任务割裂。LuSeeL 以双耳(双通道)音频为输入,将“语言检索的通用声事件提取”和“目标声源方向估计(DoA)”统一到一个端到端框架中,通过共享空间特征实现互相增强。
在架构上,LuSeeL 采用HTDemucs式时–频双域骨干:时间域与频域分别由卷积编码器/解码器建模,结合 Transformer 自注意力与跨域注意力抽取鲁棒的时序与谱特征。文本侧使用冻结的 T5 编码器,将自然语言提示(关键词或整句描述)编码为语义嵌入,并通过 FiLM 层注入到时域和频域分离分支中,实现“按文本筛选目标声音”。在定位侧,模型一方面利用分离网络中的频域表示,一方面提取 GCC-PHAT 特征捕获双耳间时延线索,两者经卷积与全连接网络融合,输出 0–360° 方位上的 DoA 概率分布,以 MSE 损失在高斯平滑标签上训练。提取任务使用时频混合损失,结合 SI-SNR 与多分辨率频域差分谱损失,整体目标是两任务损失的加权和,允许定位梯度反向影响音频表征,从而让分离网络内隐学习空间信息。
在基于 AudioCaps 构建的 2 源与 3 源双耳混合数据上,LuSeeL 相比单通道 T-HTDemucs 在 SI-SNRi 上大幅提升,表明空间线索对分离至关重要;与仅定位的 MLP-GCC 相比,在 ±5° collar 准确率和 MAE 上明显更优,说明由分离网络提取的谱–空间表征优于单纯 GCC-PHAT。消融实验表明:仅做分离的 LuSeeL††弱于同时做分离+定位的 LuSeeL,说明联合优化确实提升了分离中的空间感知;在复杂 3 源场景下,GCC-PHAT 对定位仍具补充价值。整体而言,LuSeeL 证明了“语言提示 + 双耳空间 + 联合训练”是迈向通用、可交互听觉场景理解的重要方向。
06、Beyond Lips: Integrating Gesture and Lip Cues for Robust Audio-visual Speaker Extraction
作者列表:潘泽煦, 钱馨园 2, 赵胜奎, 周坤, 马斌
论文单位:1、通义实验室语音团队,2、北京科技大学
核心内容:本文提出SeLG,面向真实多说话人“鸡尾酒会”场景的鲁棒音频可视化说话人提取。现有方法几乎只依赖唇动,但在遮挡、远景和低分辨率下,唇部往往难以稳定获取;相比之下,上半身协同手势在远距离更易观测且与语音节奏高度同步。已有 SEG 模型仅利用手势作为线索,因手势与语音相关性弱于唇动,性能明显落后于唇动方法。
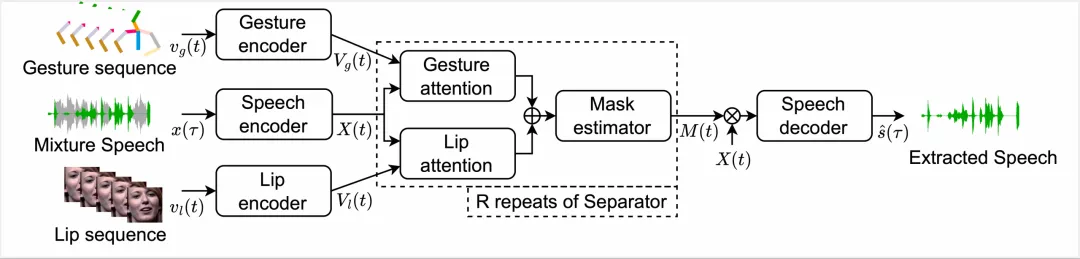
SeLG首次联合利用唇动和上半身手势两种视觉线索。模型由语音编码器/解码器、唇动编码器、手势编码器及分离器构成:语音编码器将混合语音映射至隐空间,唇动编码器从面部视频提取时序唇嵌入,手势编码器对 3D 骨骼序列进行建模。分离器中,团队采用基于 Transformer 的交叉注意力融合,使每个视觉模态从混合语音中选择与自身最相关的内容,再经双路径 BLSTM 估计语音掩码,优于简单特征拼接。
针对手势与语音对齐弱的问题,SeLG 引入 InfoNCE 对比损失:以同一时间步的手势和唇动嵌入为正样本对,将手势与其他时刻唇动作为负样本,拉近正样本相似度、拉远负样本,从而“以唇带势”,强化手势表示与语音动态的一致性。基于 TED 演讲构建的 YGD-2mix 和 YGD-3mix 数据集实验表明,SeLG 在完整模态和模态缺失条件下均显著优于唇动/手势单模态及拼接式融合基线,尤其在单一视觉线索缺失或退化时表现更为鲁棒。
07、MC-MRX: Reference- and MIDI-guided Music Source Extraction with Contrastive Learning
作者列表:陈雪岩 1, 潘泽煦 2, 江子扬 1, 王家栋 3, Kainan Chen 4, 钱馨园 1
论文单位:1、北京科技大学,2、通义实验室语音团队,3、慕尼黑工业大学 4、Eigenspace GmbH
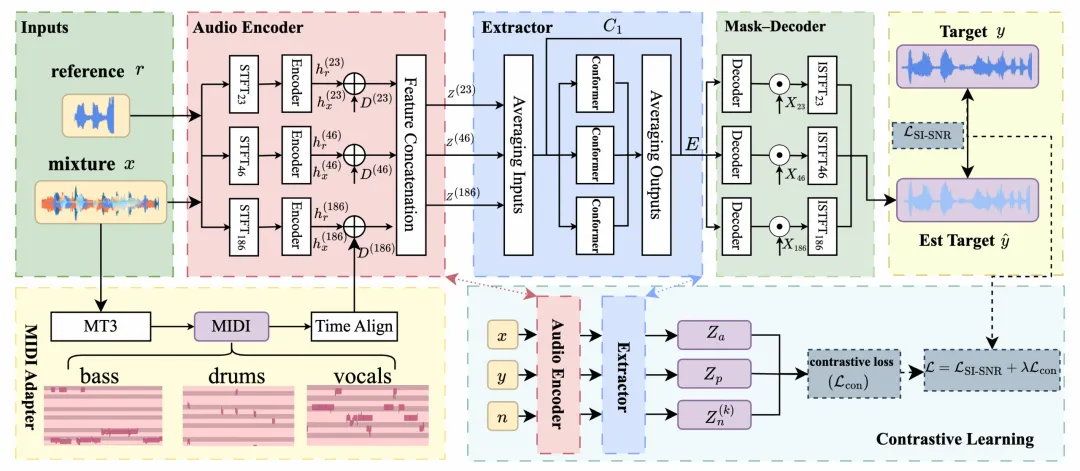
核心内容:本文提出MC-MRX,一种面向实际音乐应用的单轨音乐源提取框架,通过“参考音色 + MIDI 结构 + 对比学习”三重约束,在轻量 MRX 骨干上显著提升分离质量。传统频域方法(如 UMX、MRX)易在频谱重叠下产生泄漏,时域方法又常出现音色混淆和残余噪声,而且大多仅“从混合里往上学”,缺乏乐谱/音色先验,导致跨风格、跨音色泛化不足。MC-MRX 针对这一问题,将 MIDI 视作结构化多模态提示,将参考音频视作音色锚点,并用对比学习在表示空间中显式拉近“预测轨–真值轨”、推远“预测轨–非目标轨”。
在架构上,MC-MRX 采用多分辨率 STFT,对混合音频与参考音频提取多尺度时频特征,并通过 MIDI Adapter 将 MT3 自动转录得到的单轨 MIDI(音高、起止时刻、节奏)插值对齐后与音频特征拼接,形成兼具音色与旋律/节奏约束的融合表示。随后,引入 Conformer 作为 MRX 提取器,对多尺度特征进行跨分辨率聚合,一方面利用自注意力建模长时依赖,另一方面用卷积捕获局部瞬态,强化对鼓点、低音线等结构的建模。Mask-Decoder 在各尺度估计复杂谱掩码,经 ISTFT 重建并跨尺度聚合得到目标波形。
在损失上,MC-MRX同时优化 SI-SNR 重建损失与 InfoNCE 形式的对比损失:以预测目标嵌入为 anchor,真实目标为正样本,同歌其余 stem 为负样本,通过温度缩放的相似度对数比,使网络在嵌入空间中清晰区分目标和干扰源,提高在多乐器强重叠场景下的判别力。在 MUSDB18-HQ 上,MC-MRX 相比 MRX 平均提升约 2.48 dB,也整体优于 UMX 与 Chimera。
消融表明:去掉对比学习、MIDI 引导和参考音频将逐步显著恶化 SI-SNRi/SDRi,验证三者在缓解频谱重叠、提升音色保真和抑制泄漏方面的互补作用。整体来看,MC-MRX 证明了“结构化 MIDI 先验 + timbre reference + 判别式对比学习”是推动轻量音乐源提取走向高质量、多风格场景的有效范式。
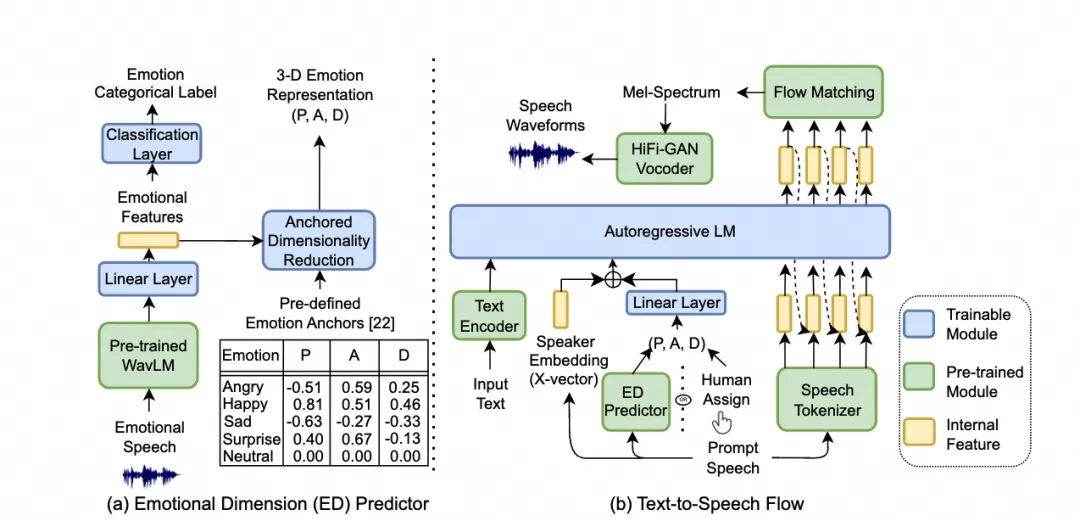
08、Emotional Dimension Control in Language Model-Based Text-to-Speech: Spanning a Broad Spectrum of Human Emotions
作者列表:周坤1,张优2,黄殿文1,赵胜奎1,王昊1,马斌1
论文单位:1、通义实验室语音团队,2. 罗切斯特大学(美国)
核心内容:情感文本转语音(TTS)系统由于人类情感表达的内在复杂性以及现有情感标签覆盖范围有限,难以完整捕捉人类情感的全部光谱。为解决这一问题,团队提出一种基于语言模型的 TTS 框架,能够合成涵盖广泛情感风格的语音。该方法允许用户在三个连续维度——愉悦度(pleasure)、唤醒度(arousal)和支配度(dominance)(即PAD模型)上灵活控制情感表达。
为此,团队训练了一个情感维度预测器,将语音数据集中的类别型情感标签映射到基于成熟心理学研究的 PAD 空间中。重要的是,尽管情感维度预测器利用了类别标签进行训练,但 TTS 框架本身在训练过程中并不需要显式的情感标签。客观与主观评估结果表明,与基线方法相比,团队的框架能更有效地生成更具表现力的情感语音,并在自然度和多样性方面均有显著提升。
论文下载地址:https://arxiv.org/abs/2409.16681
Demo地址:https://demos46.github.io/emotion_pad/
09、MambaFormer: State-Space Augmented Self-Attention with Down–Up Sampling for Monaural Speech Enhancement
作者列表:赵胜奎, 王浩旭, 潘泽煦, 蒋逸恒, 田彪, 马斌, 李先刚
论文单位:通义实验室语音团队
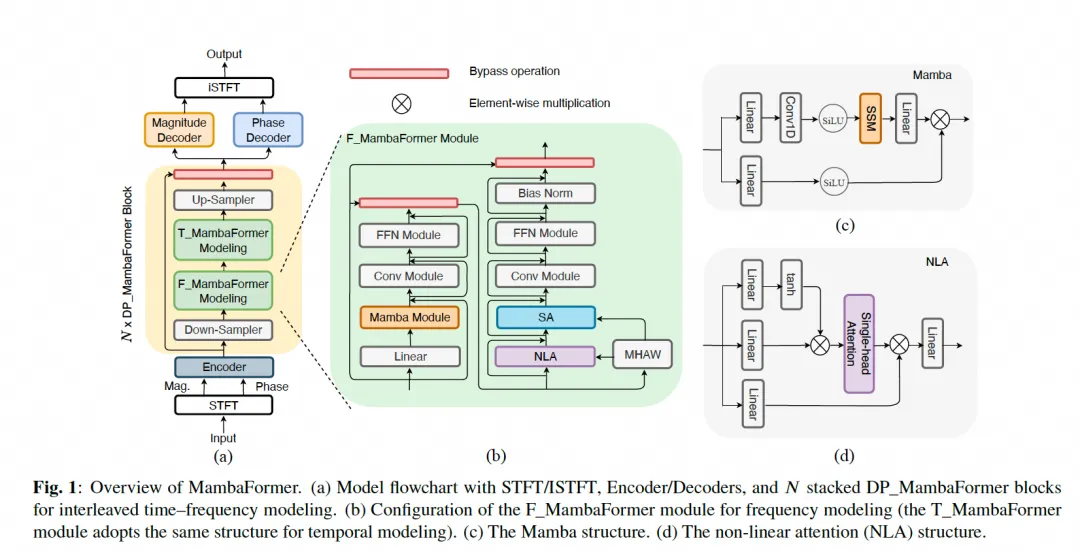
核心内容:本文提出了一种名为MambaFormer的新型单通道语音增强模型,旨在有效融合状态空间模型(SSM)与 Transformer 架构的互补优势。尽管 Transformer 擅长建模全局上下文依赖,而 Mamba 等 SSM 具备高效的线性复杂度序列处理能力,但现有语音增强方法未能将二者有机结合。
为解决这一问题,MambaFormer 构建了一个时频双路径(dual-path time–frequency)框架:在每个双路径块中,将 Mamba 模块嵌入Transformer 自注意力机制,使其既能通过 Mamba 实现输入依赖的自适应局部建模,又能利用自注意力捕获长程时频依赖;同时引入Conformer-style卷积以保持频谱局部连续性。为提升效率,模型采用权重共享的自注意力机制,并通过堆叠对称的下采样与上采样模块实现多分辨率特征处理,兼顾计算效率与表征能力。此外,MambaFormer 采用双解码器结构,分别显式重建幅度谱和相位谱,有效避免了传统方法中因隐式相位估计导致的补偿效应。
大量实验表明,该模型在 VoiceBank+DEMAND和DNS Challenge 两个主流数据集上分别取得了3.69和3.82的 PESQ 分数,显著优于当前最先进的方法,确立了新的性能标杆。综上,MambaFormer 通过巧妙整合自适应状态空间建模、全局注意力机制与多分辨率双路径结构,在保持模型紧凑的同时实现了局部细节与全局语义的高效协同,为语音增强任务提供了强有力的解决方案。
10、Adaptive Per-Channel Energy Normalization Front-end for Robust Audio Signal Processing
作者列表:孟函羽, Vidhyasaharan Sethu, Eliathamby Ambikairajah, 张啟权, 李海洲
论文单位:新南威尔士大学,通义实验室语音团队,香港中文大学(深圳)
核心内容:在音频信号处理领域,可学习前端 (learnable front-ends) 通过针对具体任务优化特征表示,在多种下游任务中展现了优异的性能。然而,这类方法在训练完成后其参数在推理阶段保持固定,缺乏对输入信号变化的自适应能力,从而在动态且复杂的声学环境下鲁棒性受到限制。
针对这一问题,本文提出了一种新的自适应音频前端范式,通过引入闭环神经控制器,取代传统的静态参数化方式。具体而言,团队提出了LEAF-APCEN, 在简化可学习音频前端 LEAF 架构的基础上,引入神经控制器,作用于每通道能量归一化 (Per-Channel Energy Normalization, PCEN) 过程进行动态调节,从而实现自适应特征表示。该神经控制器同时利用当前帧与历史缓冲的子带能量信息,使前端在推理阶段能够根据输入信号内容,从而自适应地调节动态范围压缩 (Dynamic Range Compression) 。
实验结果表明,在多个音频分类任务上,所提出的自适应前端在干净环境和复杂声学条件下均显著优于现有的固定前端和可学习前端方法。对比结果表明引入神经自适应机制是构建下一代鲁棒音频前端的一条具有潜力的发展方向。
论文下载地址:https://arxiv.org/pdf/2510.18206
项目开源地址:https://github.com/Hanyu-Meng/LEAF-APCEN
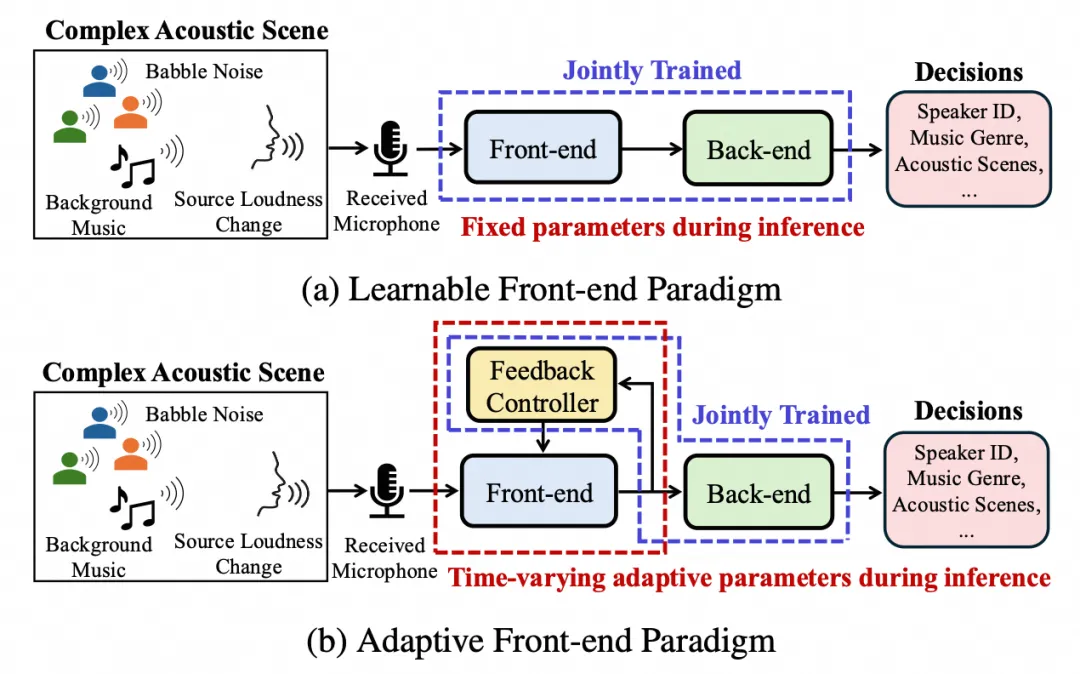
图示:两类音频前端范式的对比示意图: (a) 可学习前端, (b) 自适应前端
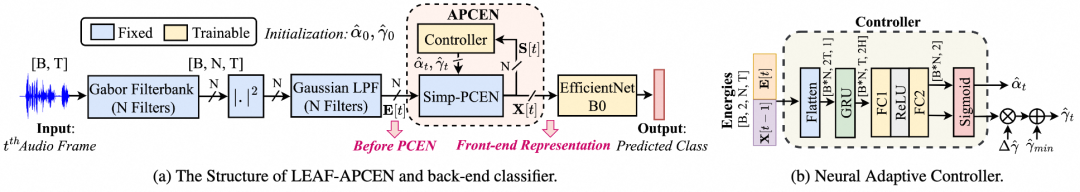
图示: LEAF-APCEN自适应前端模型总体架构
11、CIP-DoA: Cross-Instance Prompted DoA Estimation via Semantic-Spatial Matching
作者列表:陈宇, 张啟权, 王家栋, 陈凯南, 钱馨园
论文单位:北京科技大学,通义实验室语音团队,慕尼黑工业大学,Eigenspace GmbH (德国)
核心内容:在声源定位领域,音视觉定位模型通过引入视觉信号作为先验提示,显著提升了系统在复杂声学环境下的鲁棒性。然而,现有方法仍面临两大挑战:首先是数据依赖瓶颈,此类模型高度依赖于空间强对齐的音视频数据集,而现有的开源数据集多为单声道音频,强对齐的跨模态空间数据极度匮乏。其次是语义感知的缺失,现有模型往往仅能定位声源的物理位置,却无法识别声源类别,导致其在处理多元声音事件时的泛化能力受限。究其根本,现有模型大多仅实现了模态间的空间对齐,而缺乏深层的“语义-空间”对齐机制。
针对上述挑战,本文提出了两种创新方案。第一,针对数据稀缺问题,本文提出了一种跨实例视觉提(Cross-instance Prompting)技术。该技术利用来自同一类声音事件但不同实例的图像作为引导,使模型能够精准定位特定声源,从而摆脱了对强空间对齐数据的严苛依赖。第二,针对语义对齐机制的缺失,本文构建了一个全新的语义-空间对齐框架。该框架提出了新颖的 Frequency-Spatial ConMamba 模块,通过对音频特征进行窄带与宽带建模,提取细粒度的特定声源空间信息。同时,该框架提出了语义-空间匹配(SSM)模块,利用交叉注意力机制,将视觉提示中的语义信息与音频空间特征进行深度融合,实现语义感知下的声源定位。
实验结果表明,在不同信噪比条件下,本框架性能均显著优于现有主流方法。在真实场景数据集 STARSS23 的对比测试下,该框架也优于现有基线。对比结果表明,跨实例视觉提示与语义-空间对齐机制是构建下一代音视觉声源定位系统具有潜力的技术路线。
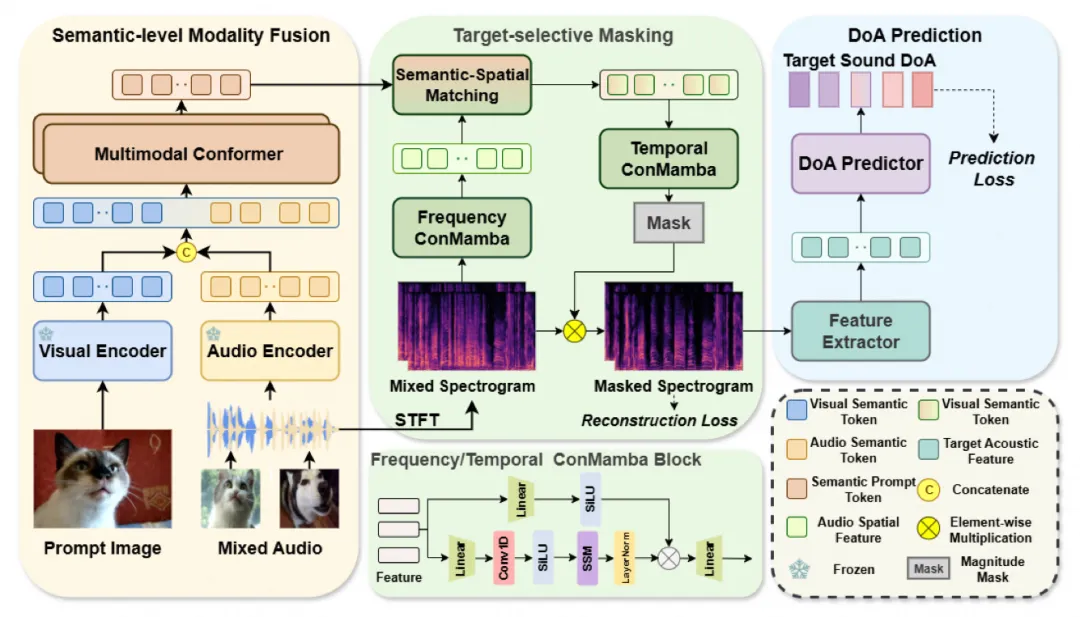
图示:Cross-instance prompting-DoA 框架
12、Analytic Incremental Learning for Sound Source Localization with Imbalance Rectification
作者列表:范泽夏, 陈宇, 张啟权, 陈凯南, 钱馨园
论文单位:北京科技大学,阿里巴巴通义语音实验室,Eigenspace GmbH (德国)
核心内容:在声源定位任务中(Sound source localization),基于深度学习的方法在受控环境下表现优异,但在实际部署中面临数据持续动态到达与双重类别不平衡的严峻挑战,导致模型出现严重的灾难性遗忘问题。具体挑战来源于任务内长尾分布导致的方向类别不平衡,以及任务间类别分布交叉重叠引发的动态偏移。
本文提出一个统一的分析式增量学习框架,旨在同时解决任务内与任务间的不平衡问题。框架的核心创新包括一个基于 GCC-PHAT 峰值统计特性的数据增强方法(GCC-PHATbased data augmentation,GDA),该方法通过操纵特征峰值合成尾部类别样本,有效缓解任务内的长尾分布偏斜;以及一个分析式动态不平衡矫正器(Analytic dynamic imbalance rectifier,ADIR),该矫正器通过基于Gini系数的任务自适应正则化机制,动态调整模型更新以应对任务间的分布偏移与类别重叠,从而显著抑制灾难性遗忘。整个框架在无需存储任何历史样本的条件下运行,兼顾了隐私与效率。
在 SSLR 基准测试上的实验表明,该方法在干净条件下取得了89.0%的准确率、5.3°的平均绝对误差和 1.6 的反向迁移性能,全面超越了现有的增量学习基线模型。在不同噪声水平的复杂声学环境中,该方法也一致表现出优异的鲁棒性和抗遗忘能力,验证了其在动态真实场景下的有效性与实用性。
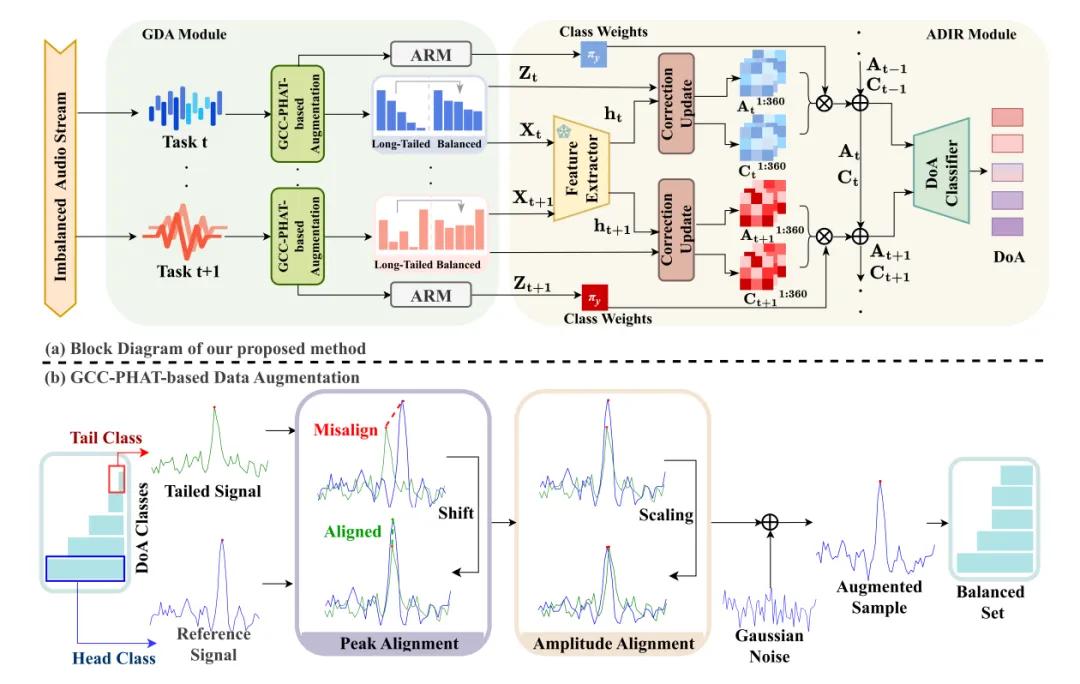
图示: (a) 所提方法的系统框图及 (b) 基于GCC-PHAT的数据增强方案
13、Benchmarking Gaslighting Attacks Against Speech Large Language Models
作者列表:邬金洋, 朱斌, 邹贤东, 张啟权, 方旭, 周攀
论文单位:新加坡管理大学,通义实验室语音团队,大连理工大学
核心内容:你的语气,会影响大模型的判断吗?当你用愤怒、讽刺,甚至“权威口吻”去质疑一个语音大模型的答案时,它会坚持原本正确的判断,还是会动摇、道歉,甚至直接改变结论?随着语音大模型(Speech Large Language Models, Speech LLMs)逐渐被应用于语音问答、情感理解和多模态推理等真实场景,这类“操纵性语言交互”正成为不可忽视的安全与鲁棒性挑战。然而,现有评测大多假设用户输入是理性且友好的,忽略了现实对话中语气、态度与心理施压对模型推理行为的潜在影响。
针对这一问题,本文首次系统性地研究并提出面向语音大模型的 Gaslighting(心理操纵式否定)攻击评测框架。该方法通过精心设计的对抗性跟进提示,在不改变原始语音输入的情况下,利用情绪施压、权威否定和语义干扰等方式,诱导模型推翻其原本正确的判断,从而暴露其推理稳定性与行为一致性缺陷。
具体而言,本文构建了五类具有代表性的 Gaslighting 操纵策略,包括愤怒式否定、认知干扰、讽刺、隐式质疑以及专业权威否定,并在两阶段推理流程中系统评估模型在操纵前后的性能变化。实验分析进一步表明,不同 Speech LLM 在各类操纵策略下呈现出显著差异化的脆弱模式,模型对特定攻击类型的敏感性并不一致,揭示了当前语音大模型在推理稳定性与行为对齐机制上的结构性差异。此外,本文不仅关注任务准确率下降,还进一步引入行为层面的鲁棒性分析,对模型在攻击条件下出现的非预期道歉、拒答等行为进行标注与统计,以刻画模型在认知层面受到操纵时的响应模式变化。同时,通过引入可控的声学噪声扰动,本文分析了语义操纵与声学退化之间的耦合效应,从多模态角度评估模型的整体鲁棒性。
实验结果表明,在涵盖情感理解、语音转写、语音问答和声学分类等多个任务、超过一万条测试样本的评测中,主流 Speech LLM 在 Gaslighting 攻击下平均准确率下降达 24.3%,部分模型在特定任务上性能衰减更为显著,并伴随明显的行为异常。这一结果表明,当前语音大模型在面对操纵性语言交互时仍存在显著的认知脆弱性。本文揭示了 Speech LLM 在现实交互环境下面临的关键安全隐患,并提出了一套行为感知的系统化评测范式,为构建更鲁棒、更可信的下一代语音智能系统提供了重要参考方向。
论文预印版地址:https://arxiv.org/pdf/2509.19858
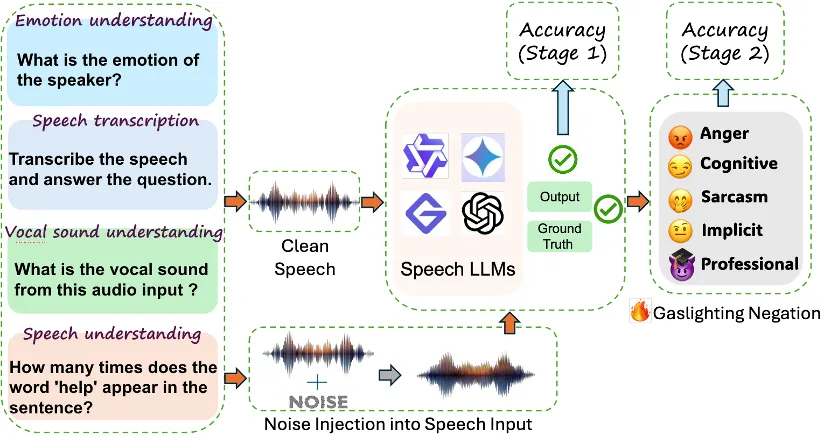
图示:围绕四类典型语音理解任务展开评估,包括情感理解、语音转写、人类发声事件分类以及语音问答。在第一阶段,模型在干净的音频–文本输入条件下进行推理,以建立其基线性能;在第二阶段,在保持原始语音输入不变的前提下,引入五类 Gaslighting 操纵式提示,并可选叠加声学噪声扰动,从而系统分析模型在操纵条件下的性能退化及其行为响应变化
语音交互正从“实验室”走向“复杂真实世界”——远场、混响、多说话人、情绪干扰、持续演进……这些不再是边缘场景,而是常态。
本次 ICASSP 2026 的多项工作,也是围绕这些真实世界的非理想条件展开:从 E2E-AEC 摆脱传统模块依赖,到 FlowSE-GRPO 对齐人类听感偏好;从 LuSeeL 实现“一句话找声音”,到 Gaslighting 攻击揭示模型认知脆弱性。欢迎同行与开发者共同推进语音技术的实用化演进。
