
 语音小管家
分享天津大学认知计算与应用重点实验室9篇论文被INTERSPEECH 2026 录用的论文。本次录用工作覆盖大音频语言模型、音频推理智能体、阿尔茨海默病语音检测、鲁棒说话人验证、上下文表现力语音评估以及自监督语音表征学习等方向。
⏩1. MATA: A Training-Free Approach to Mitigate Cross-Modal Attention Imbalance in Large Audio Language Models
作者:Junyu Wang、Jian Zong、Tianrui Wang、Zhengding Luo、Meng Ge、Xiaobao Wang、Longbiao Wang、Jianwu Dang
单位:天津大学、南洋理工大学、天津慧言科技(天津)有限公司、深圳先进研究院
论文介绍:大型音频语言模型通常存在音频—文本注意力失衡问题:在多模态融合过程中,模型往往更偏向文本信息,而忽视声学信息。这种偏置限制了声学线索的有效利用,并导致音频推理性能下降。为缓解这一问题,我们提出了一种无需训练的新方法 MATA,其目标是在自注意力机制中动态推动 LALM 更多关注音频。具体而言,MATA 在原始注意力分数计算之后进行干预,仅作用于中间层中的最后一个 token,因此无需引入额外参数,也不会增加计算开销。在 MMAU 和 MMAR 基准测试上的实验表明,MATA 能够持续带来性能提升。此外,将 MATA 集成到 Qwen3-Omni-Thinking 模型后,该模型在 Interspeech 2026 音频推理挑战赛的单模型赛道中获得了第二名。作为顶尖方案中唯一一种无需训练的方法,MATA 提供了一种高效的注意力偏置缓解策略,有助于进一步提升大型音频语言模型的推理能力。
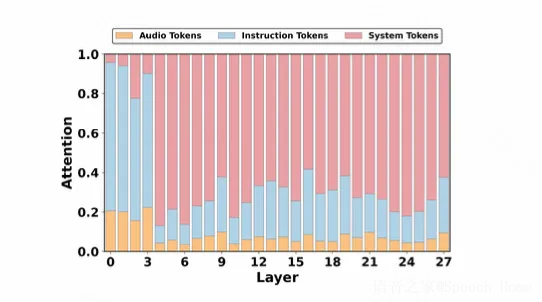
图 1. 使用 Qwen2.5-Omni-7B 时,所有预测 token 在不同层中的平均注意力权重分布。Instruction tokens 指用户提供的文本输入;System tokens 指模型内部用于对话格式化的特殊 token。
⏩2. EChO-Agent: Evidence Chain Orchestration Agent for Audio Reasoning
作者:Siyuan Zhang、Jian Zong、Junyu Wang、Peiyuan Jiang、Jiahao Yan、Jingyu Zhang、Tianrui Wang、Xiaobao Wang、Longbiao Wang、Jianwu Dang
单位:天津大学人工智能学院
论文介绍:复杂音频推理不仅要求模型给出正确答案,还要求推理过程能够真正建立在可核验的音频证据之上。针对大音频语言模型在长音频中难以定位问题相关片段、推理链缺少可检查证据等问题,本文提出 EChO-Agent,将复杂音频问答重构为“规划—工具执行—证据整合—答案验证”的模块化流程。系统首先调用专业音频工具获取观测结果,再将其压缩为与问题相关的结构化证据,在原始音频与证据的共同约束下完成推理,并通过双重验证检查格式与证据—答案一致性。在 MMAR benchmark 上,EChO-Agent 达到 71.0% accuracy 和 63.0 rubric score,相比 Qwen3-Omni 基线分别提升 2.3 和 4.3 个百分点,说明结构化证据链对于提升复杂音频推理的可靠性具有重要作用。
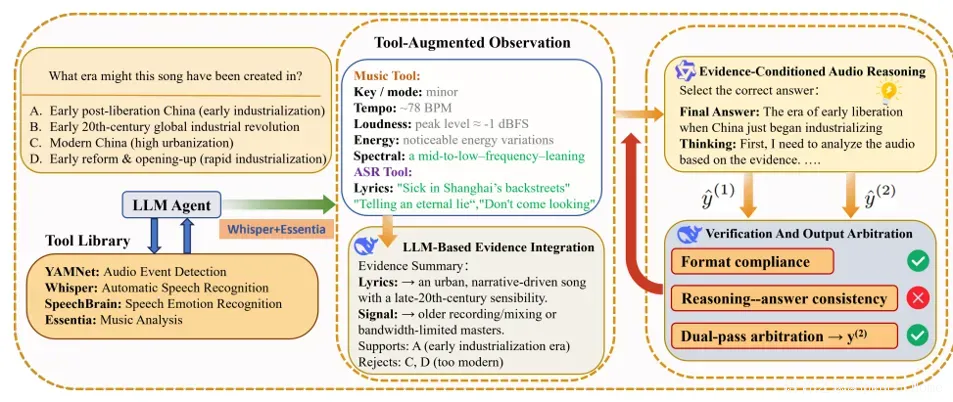
图 2. EChO-Agent 整体框架。系统按照 Tool → Evidence → Reason → Verify 的流程组织复杂音频推理,将工具观测转化为可核验的结构化证据并完成答案验证。
⏩3. Cognitive-Heuristic Guided Multimodal Data Augmentation for Alzheimer's Disease Detection Using LLM and TTS
作者:Yu Jiang、Cheng Gong、Bin Wen、Ruihao Jing、Tianrui Wang、Shansong Liu、Boyu Zhu、Yuheng Lu、Xuanchen Li、Xiao Wei、Chunyu Qiang、Xiaolei Zhang、Longbiao Wang、Jianwu Dang
单位:天津大学
论文介绍:阿尔茨海默病(AD)是一种进行性神经退行性疾病,早期检测对干预至关重要。语音可作为一种无创、易获取的生物标志物用于阿尔茨海默病筛查,但该领域面临严重的数据稀缺问题。现有的文本或语音数据增强方法虽然能够扩充训练集,却往往忽略与认知功能相关的特征模式。本文提出一种认知启发式引导的多模态生成增强框架,在生成过程中显式融入阿尔茨海默病对应的认知衰退特征。该框架结合检索增强生成与大语言模型,实现具备认知特征的文本生成;同时采用属性引导的文本转语音系统,复现与阿尔茨海默病相关的声学特征。该方案能够同时捕捉认知衰退带来的语言特征变化与声学特征变化。在多个基准数据集上开展的实验表明,经过本方法扩充后的数据集可持续提升模型性能,证明了基于认知驱动的多模态合成技术在语音辅助阿尔茨海默病检测中的有效性。
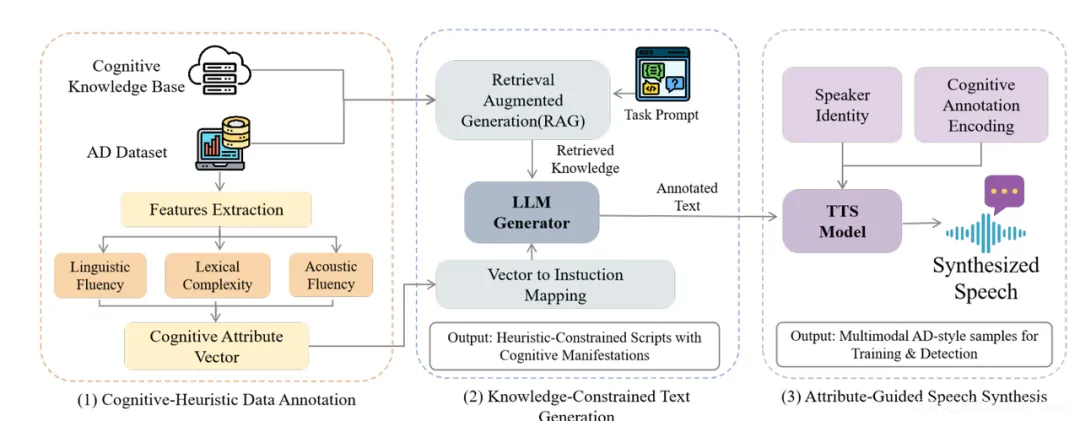
图 3. 本文所提框架结构:(1) 认知属性向量提取;(2) 阿尔茨海默病风格文本的约束生成;(3) 多模态一致性音频合成。
⏩4. BiSASV: Bidirectional Feature Modulation with Dual-Granularity Fusion for Spoofing-Robust ASV
作者:Yiqun Zhou、Ji Liu、Longbiao Wang、Kong Aik Lee
单位:天津大学、香港理工大学
论文介绍:自动说话人验证(ASV)系统容易受到合成语音攻击。然而,现有的面向欺骗鲁棒ASV(SASV)的特征级融合通常依赖单向的CM到ASV交互,忽视了说话人上下文信息。为此,本文提出了一种双向调制的欺骗鲁棒自动说话人验证系统BiSASV,在ASV与对策(CM)子系统之间建立互惠的信息流动。本文引入双向调制网络,将全局说话人上下文注入CM,同时增强后的CM特征反向门控ASV嵌入。此外,本文还探索了一种双粒度融合策略,以同时捕获细粒度和全局判别性线索。实验结果表明,在ASVspoof 2019 LA数据集上,所提系统的SASV等错误率(SASV-EER)为0.73%,最小不可知检测代价函数(min a-DCF)为0.0153,显著优于单向基线方法。
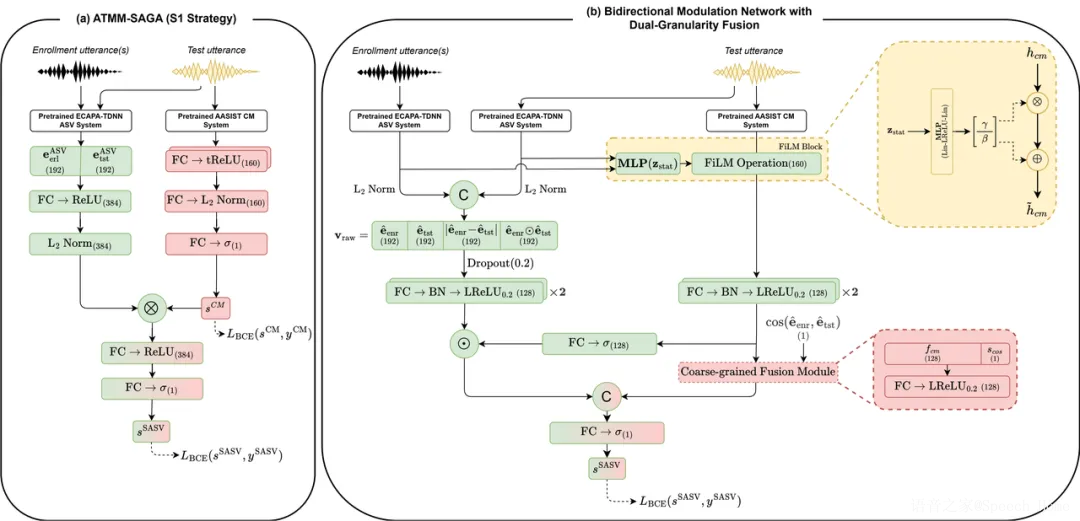
图 4. 基线ATMM-SAGA与所提出的BiSASV系统的整体架构。(a) ATMM-SAGA,其中CM分数单向门控ASV嵌入。(b) 具有双向交互和双粒度融合的BiSASV。
⏩5. MSR-HuBERT: Self-supervised Pre-training for Adaptation to Multiple Sampling Rates
作者:Zikang Huang、Meng Ge、Tianrui Wang、Xuanchen Li、Xiaobao Wang、Longbiao Wang、Jianwu Dang
单位:天津大学、慧言科技(天津)有限公司、中国科学院相关单位
论文介绍:现有语音自监督预训练方法通常默认输入语音具有统一采样率,当训练数据同时来自 16 kHz、24 kHz、48 kHz 等不同采样率时,会因时间分辨率不一致而难以直接统一建模。针对这一问题,本文提出 MSR-HuBERT,在 HuBERT 基础上将固定采样率下采样 CNN 替换为多采样率自适应下采样 CNN,使不同采样率的原始波形无需预先重采样即可映射到共享的时间分辨率,从而支持混合采样率数据的统一预训练与微调。实验覆盖 16–48 kHz 数据,结果显示 MSR-HuBERT 在语音识别和全频带语音重建任务上优于 HuBERT,并能够在保持低频语义建模能力的同时更好保留高频细节。
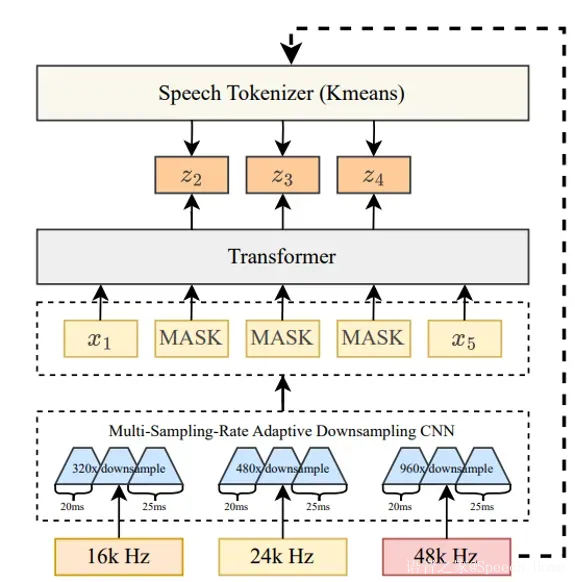
图 5. MSR-HuBERT 整体框架。多采样率自适应下采样 CNN 将不同采样率波形映射到统一时间分辨率,再沿用 HuBERT 的掩码预测目标与 Transformer 编码器进行自监督预训练。
⏩6. Gated Multi-Graph Fusion via Graph Attention Networks for Alzheimer's Disease Detection
作者:Jinyu Li、Xiao Wei、Bin Wen、Kai Li、Yuqin Lin、Xiaobao Wang、Longbiao Wang、Jianwu Dang
单位:天津大学未来技术学院、中国科学院深圳先进技术研究院、福州大学计算机与大数据学院、慧言科技(天津)有限公司
论文介绍:自发言语是阿尔茨海默病(Alzheimer's Disease, AD)的一种重要非侵入性生物标志物,但许多现有系统忽略了病理性语言中的非线性结构破坏和临床异质性。本文提出了一种多视角门控图注意力网络(Multi-View Gated Graph Attention Network),通过自动语音识别(Automatic Speech Recognition, ASR)转录音频,构建语义图、依存图和共现图,从“内容—结构—流利度”框架刻画言语特征。其中,共现图利用来自规范语料库的点互信息(Pointwise Mutual Information, PMI)来量化叙事逻辑和语言偏离。为应对症状多样性,本文采用一种自适应门控融合机制动态整合这些视角。在ADReSSo数据集上的评估显示,本文的模型达到了90.00%的准确率。消融实验结果表明,基于PMI的图和异质性感知门控机制对于在不同临床人群中实现稳健分类至关重要。
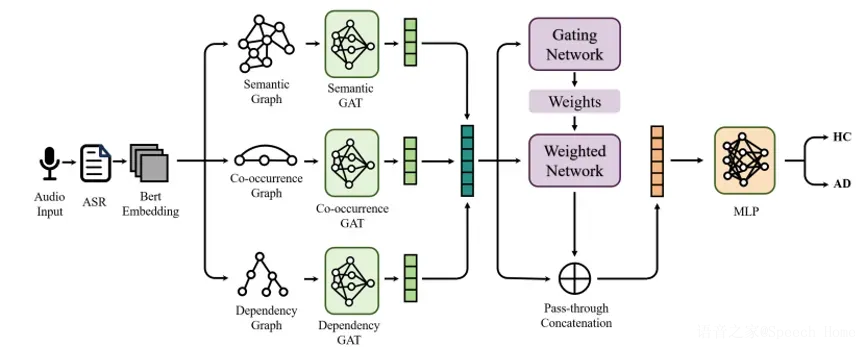
图 6. 多视角门控图注意力网络框架概述。(1)通过ASR将音频转录并转换为词级嵌入。(2)构建语义图、共现图和依存图,以捕获多尺度语言模式。(3)通过GAT层提取拓扑特征,并通过全局池化进行聚合。(4)多视角特征由门控网络自适应融合。(5)融合后的特征输入MLP进行最终分类。
⏩7. POTSA: A Cross-Lingual Speech Alignment Framework for Speech-to-Text Translation
作者:Xuanchen Li, Chenrui Cui, Tianrui Wang, Meng Ge, Zikang Huang, Yizhou Peng, Jin Li, Yuheng Lu, Yu Jiang, Nyima Tashi, Longbiao Wang, Jianwu Dang
单位:天津大学认知计算与应用天津市重点实验室、南洋理工大学、慧言科技(中国)有限公司、深圳先进研究院、西藏大学
论文介绍:语音大语言模型在多语种语音到文本翻译领域取得了突破性进展。然而,现有方法往往忽视了源语言之间的语义共性,导致翻译性能存在偏差。在本工作中,我们提出了POTSA(用于语音对齐的并行最优传输),这是一个基于跨语言并行语音对和最优传输的新框架,旨在弥合高资源语言与低资源语言之间的翻译差距。首先,我们引入了一个偏差补偿模块,以粗略地对齐初始语音表示。其次,我们利用并行语音对,对Q-Former施加词元级别的最优传输约束,以建立细粒度的表示一致性。然后,我们采用分层调度策略,将最优传输约束聚焦于对语义有益的层。在FLEURS数据集上的实验表明,我们的方法取得了最先进的性能,在五种常见语言上BLEU值提高了+1.29,在零样本语言上BLEU值提高了+2.93,且每种语言仅使用了10小时的并行语音数据。
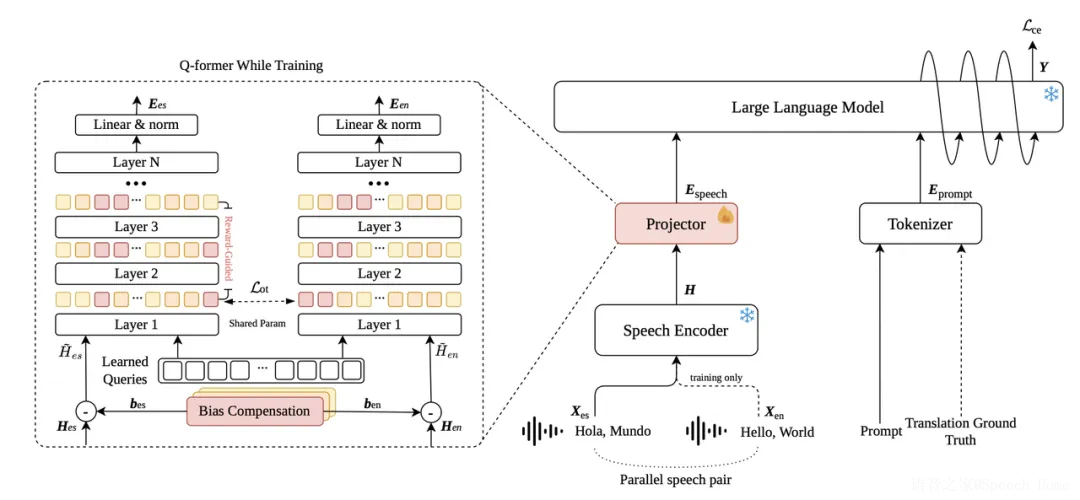
图 7.POTSA 利用并行语音对、偏差补偿、Q-Former 与最优传输约束,以及分层调度策略,最终将语音特征对齐后输入 LLM 实现多语种语音翻译的训练流程。
⏩8. Improving Stable Speech Synthesis Post-Training with ChatScorer and Margin-Based Preference Construction
作者:Shihao Niu, Jianguo Wei, Wenhuan Lu, Xianghu Yue*, Wei Li, Ming Zhou, Ming Cai, Luo Si
单位:天津大学智能与计算学部、斑马网络技术有限公司
论文介绍:现有语音合成(TTS)后训练主要依赖字符或词错误率、说话人相似度和平均意见分等指标。这些指标虽能衡量内容正确性、音色一致性与整体感知质量,却难以稳定识别明显的机器感以及不适合真实聊天场景的语音;同时,多种异构指标直接加权融合还可能使候选语音之间的质量差距不够清晰,导致偏好监督模糊。
为此,本文提出一种结合 ChatScorer与基于间隔的偏好数据构造方法。ChatScorer作为辅助奖励模型,用于识别机器感较强、对话风格较差的候选语音;随后,系统综合字符错误率、说话人相似度和 ChatScorer 评分进行排序,仅保留质量差距足够清晰的样本用于偏好后训练。实验表明,该方法在保持语音可懂度和说话人相似度的同时提高了生成稳定性。其中,Rank3DPO 将字符错误率降至 1.17%,将说话人相似度组级失败率从 0.42 降至 0.10,并将基于 ChatScorer 的坏样本率从 12.66% 降至 2.44%。
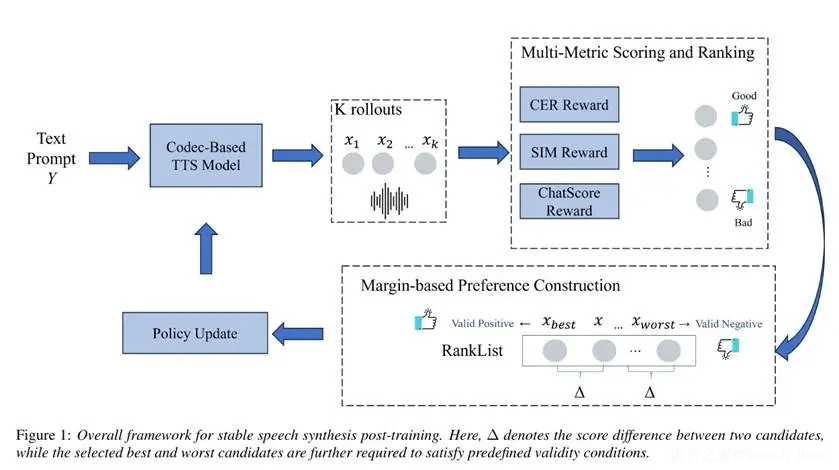
图 8. 图中展示了本文的整体后训练流程:模型先为同一文本生成多个候选语音,再结合 CER、说话人相似度和 ChatScorer 进行多指标排序,最后通过基于间隔的偏好样本构造筛选出优劣差距明确的样本对,用于更新 TTS 模型,从而提升语音生成的稳定性与对话自然度。
⏩9. Speech-to-See: End-to-End Speech-Driven Open-Set Object Detection
作者:Wenhuan Lu, Xinyue Song, Wenjun Ke, Zhizhi Yu*, Wenhao Yang, Jianguo Wei
单位:天津大学智能与计算学部、国家管网集团科学技术研究总院
论文介绍:现有开放集目标检测研究大多局限于图像-文本模态,然而在机器人交互与语音导航等真实场景中,文本输入往往不切实际或无法获取。语音不仅是自然直观的替代交互方式,还蕴含语调、重音等副语言线索,有助于消解指代歧义;但直接利用语音进行开放集检测仍面临音频-图像配对数据稀缺,且现有方法多采用文本中介的两阶段管道,存在信息瓶颈与错误传播。
为此,本文提出端到端框架 Speech2See,基于渐进式预训练与微调范式,将大规模预训练模型中的文本-图像语义先验与深层声学表征有效迁移至语音定位任务。预训练阶段,设计查询引导语义聚合(QSA)模块,通过可学习查询将冗余的语音嵌入压缩为紧凑语义表征;微调阶段,引入参数高效的混合 LoRA 专家(MoLE)架构,在冻结原始解码器参数的前提下实现深层跨模态适配。实验表明,该方法在 COCO 与 LVIS 等基准上取得 state-of-the-art 性能:闭集设定下 AP 达 56.2,较现有最优方法提升 17.0;零样本设定下 AP 达 42.7,甚至超过 YOSS 的闭集性能。此外,与级联基线相比,参数量减少 26%,实时因子更低,验证了端到端"听音定位"范式的有效性与高效性。
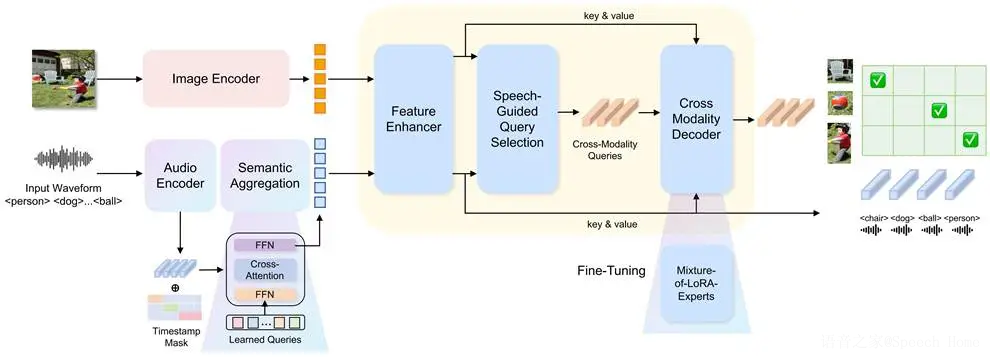
图 9.图中展示了 Speech2See 的端到端“听音定位”框架:模型先分别编码图像与语音,通过语义聚合压缩语音表示,再利用语音引导的跨模态查询与解码器完成开放集目标检测;同时结合参数高效的 MoLE 微调策略,实现更准确、更高效的语音驱动目标定位。
