火山语音丨AI创作惊艳四方 诸多挑战仍在路上

文章来源于至顶头条,作者记录数字化创新的 2022年8月,一幅名为《太空歌剧院》的数字画作获得冠军同时引发了巨大争议,AIGC(AI产生内容:AI-Generated Content)出圈的事件便频频出现在大众视野。同年11月30日Open…
313 0 0

文章来源于至顶头条,作者记录数字化创新的 2022年8月,一幅名为《太空歌剧院》的数字画作获得冠军同时引发了巨大争议,AIGC(AI产生内容:AI-Generated Content)出圈的事件便频频出现在大众视野。同年11月30日Open…
今日论文合集:cs.SD语音2篇,eess.AS音频处理2篇。 cs.SD语音 【1】 Multi-Genre Music Transformer -- Composing Full Length Musical Piece 标题:多体裁音…
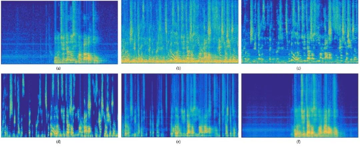
数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已 基于统计信号处理的传统噪声抑制方法是通过检测持续的背景声,来估计背景噪声,然后通过估计到的背景噪声计算增益因子对带噪语音进行抑制。但这种方式针对规律的稳态噪声比较有效,如空调…
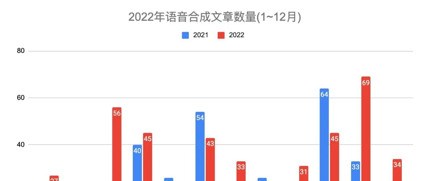
论文统计每月更新一次,主要跟踪语音合成和语音识别的发展状况。很多文章都是在会议后才发出,但不影响统计。统计过程难免存在疏漏,因此统计结果仅供参考。 所有文章语音合成领域统计列表请访问: http://yqli.tech/page/tts_p…
今日论文合集:cs.SD语音3篇,eess.AS音频处理2篇。 cs.SD语音 【1】 Chat2Map: Efficient Scene Mapping from Multi-Ego Conversations 标题:Chat2Map:多…
今日论文合集:cs.SD语音3篇,eess.AS音频处理3篇。 cs.SD语音 【1】 Language Models are Drummers: Drum Composition with Natural Language Pre-Tra…
今日论文合集:cs.SD语音5篇,eess.AS音频处理6篇。 cs.SD语音 【1】 Validity in Music Information Research Experiments 标题:音乐信息研究实验中的效度 链接:https:…
本文由清华大学与腾讯 AI Lab、香港中文大学合作。 零样本说话人自适应(zero-shot speaker adaptation),或称为零样本声音克隆,旨在根据任意一条参考语音(reference speech)合成训练过程中从未见过…
今日论文合集:cs.SD语音6篇,eess.AS音频处理6篇。 cs.SD语音 【1】 Multimodal Emotion Recognition among Couples from Lab Settings to Daily Life…
今日论文合集:cs.SD语音12篇,eess.AS音频处理16篇。 cs.SD语音 【1】 Blind Restoration of Real-World Audio by 1D Operational GANs 标题:一维操作GANS实现…