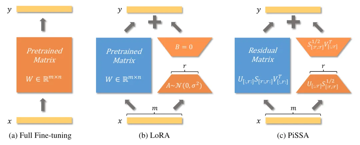
【交我学-42】从固定 LoRA 到结构化低秩适配:面向多语种低资源 ASR 的参数高效微调

近年来,以 Whisper 为代表的语音基础模型显著提升了多语种自动语音识别(Automatic Speech Recognition, ASR)的泛化能力,使同一模型能够覆盖多种语言、口音和语音场景。然而,当模型需要继续适配低资源语言、儿…
18 0 0

近年来,以 Whisper 为代表的语音基础模型显著提升了多语种自动语音识别(Automatic Speech Recognition, ASR)的泛化能力,使同一模型能够覆盖多种语言、口音和语音场景。然而,当模型需要继续适配低资源语言、儿…
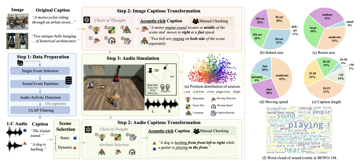
AudioCC交我学 今天,我们探讨一下如何让生成的声音准确地“落”在正确的方位。 过去两年,文本生成音频已经相当成熟,但绝大多数模型交付的仍是单通道音频——它解决了“发出什么声音”,却回避了“声音从哪里来”。而在 VR/AR、具身智能、影…
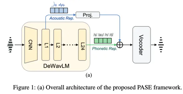
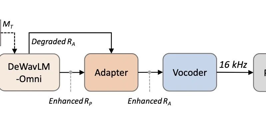
本来来源:AudioCC交我学 过去几年,语音增强(Speech Enhancement,SE)正在从传统的降噪、去混响和信号映射,走向扩散模型(diffusion model)、流匹配(flow matching)和语言模型(Langua…
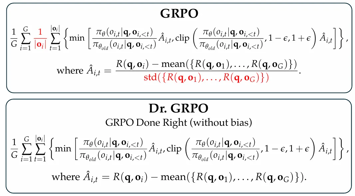
AudioCC交我学 今天我们来聊一聊,自动语音识别 (Automatic Speech Recognition, ASR) 中的强化学习是怎么做的? 近年来,大语言模型的快速发展,使得"预训练—监督微调—强化学习"逐渐成为构建智能系统的主…
本期将介绍上海交通大学听觉认知与计算声学实验与 Microsoft Research Asia 合作完成的论文 TF-MoE: Time-Frequency Mixture-of-Experts for Efficient Speech S…
ACL(Annual Meeting of the Association for Computational Linguistics)是计算语言学与自然语言处理(NLP)领域最具影响力的国际学术会议之一,每年汇聚全球顶尖学者、研究机构与工…
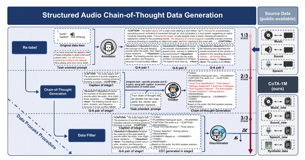
AudioCC交我学 这一期我们想聊的不是某一个具体模型,而是一个最近越来越绕不开的问题:当语音大模型、音频大模型和 omni 模型都开始变强之后,模型到底有没有真的“听懂”声音? 过去几年,大家更熟悉的是 ASR、audio captio…
ACL (Annual Meeting of the Association for Computational Linguistics) 是计算语言学与自然语言处理(NLP)领域最具影响力的国际学术会议之一,每年汇聚全球顶尖学者、研究机构…
AudioCC交我学 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。…
AudioCC交我学 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。…