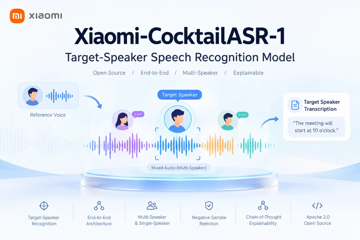
Xiaomi-CocktailASR-1:小米开源目标说话人语音识别模型

在多人同时说话的场景里,语音识别一直面临一个特殊问题:系统能够听见很多声音,却很难判断其中哪一句属于指定的人。 会议录音、多人通话、车载语音、家庭环境中的语音控制,都存在类似情况。传统方案通常需要先进行语音分离,再把分离后的目标声音交给 A…
25 1 0

在多人同时说话的场景里,语音识别一直面临一个特殊问题:系统能够听见很多声音,却很难判断其中哪一句属于指定的人。 会议录音、多人通话、车载语音、家庭环境中的语音控制,都存在类似情况。传统方案通常需要先进行语音分离,再把分离后的目标声音交给 A…
数秒克隆语音早已不新鲜,但能覆盖600+语种的语音克隆 TTS 模型,今天终于来了! 此前,音色克隆 TTS 的多语言支持最多停留在几十种语言,低资源小语种始终难以覆盖。小米 AI 实验室新一代 Kaldi 团队重磅推出 OmniVoice…
语音开源模型这么多,你还在为如何部署烦恼吗?各种模型环境各式各样,你还在为安装环境晕头转向吗?老板说隐私很重要,要出一个离线的demo,你还在犹豫不知如何下手吗?语音那么多任务,又是vad,又是说话人,还得做识别合成,你还在为组合方案费尽心…
上一期我们介绍了团队推出的高效零样本语音合成模型 ZipVoice,随着 notebook lm 的大火,对话语音合成(播客生成)也火了一把,本期将为你带来 ZipVoice 在零样本对话语音合成上的扩展 ZipVoice-Dialog[1…
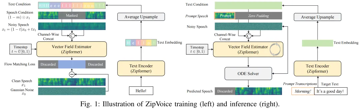
本文介绍新一代 Kaldi 团队基于 Flow Matching 架构的 ZipVoice 零样本单说话人语音合成模型[1]。ZipVoice 解决了现有零样本语音合成模型的参数量大、合成速度慢的痛点,在轻量化建模和推理加速上取得了重要突破…
2025年4月,《语音识别:原理与应用》第3版出版,在京东、当当等平台均有销售。本书由洪青阳与李琳编著,第1版和第2版先后于2020年6月和2023年2月出版,内容涵盖声学特征提取、隐马尔科夫模型(HMM)、语言模型、加权有限状态转换器(W…
相较于社区流行的 Faster Whisper 方案,NVIDIA TensorRT-LLM 能有效将推理速度提升 50% 以上; 仅用一张 A10 GPU,Whisper Turbo[1] 的中文微调模型每秒钟可以处理 500 秒的音频;…
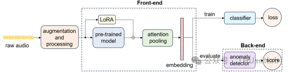
主流的 ASR 模型包括 CTC [1]、transducer [2] 和混合系统 CTC/AED [3]。CTC 是其中最为简单,最便于部署的方法,但由于它的性能通常明显落后于 transducer 和 CTC/AED,限制了它的实际应用…
用14,000 小时的中文数据集训练后,模型的效果取得了 SOTA 或者接近 SOTA 的水平。750M 参数量的 Zipformer-XL 模型可以实现 WenetSpeech test_meeting 测试集5.85%的错误率, 达到了…
1. 简介 新一代Kaldi部署框架sherpa-onnx[1]支持的编程语言API大家庭中, 最近增加了一个新成员Dart[2],使得支持的编程语言达到了 10 种。 支持了Dart, 意味着大家可以在Dart中使用sherpa-onnx…