语音/音频处理学术速递[3.17]

今日论文合集:cs.SD语音7篇,eess.AS音频处理9篇。 cs.SD语音 【1】 Learning Cross-lingual Visual Speech Representations 标题:学习跨语言的视觉语音表征链接:http:…
103 0 0

今日论文合集:cs.SD语音7篇,eess.AS音频处理9篇。 cs.SD语音 【1】 Learning Cross-lingual Visual Speech Representations 标题:学习跨语言的视觉语音表征链接:http:…
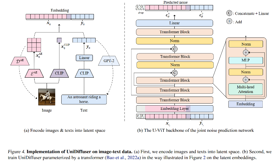
该论文提出了一个为多模态设计的概率建模框架 UniDiffuser,除了单向的文生图,还能实现图生文、图文联合生成、无条件图文生成、图文改写等多种功能。 据悉 GPT-4 将于本周发布,多模态将成为其一大亮点。当前的大语言模型正在成为理解各…
今日论文合集:cs.SD语音48篇,eess.AS音频处理51篇。 cs.SD语音 【1】 A Study on Bias and Fairness In Deep Speaker Recognition标题:深度说话人识别中的偏差和公平性…
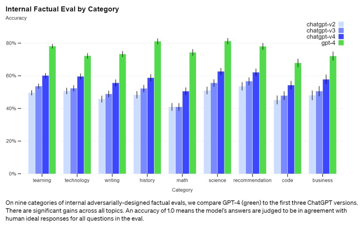
老铁们,好久不见,我是JayJay。 就在刚刚,北京时间3月15日凌晨,GPT-4问世。 现在,ChatGPT-Plus已经可以访问GPT-4: GPT-4是OpenAI在深度学习领域深耕的最新里程碑。GPT-4是一个大型多模态模型,接受图…
今日论文合集:cs.SD语音7篇,eess.AS音频处理19篇。 cs.SD语音 【1】 A two-stage speaker extraction algorithm under adverse acoustic conditions…
GPT-4真的要来了!发布时间已确定: 就在下周。而且还是多模态,可支持视频。 听到这个消息,网友们直接炸了锅:大家都准备好了吗? 毕竟在一部分人眼中,ChatGPT都已经如此惊艳,那GPT-4不得是这样的? (不过100万亿参数是谣言)…
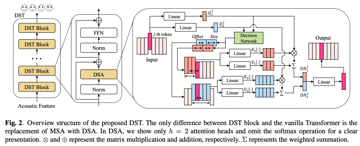
文章来源于智能语音新青年,作者ttslr 本次分享华南理工大学、优必选研究院等合作在ICASSP2023会议发表的论文《DST: Deformable Speech Transformer for Emotion Recognition》。…
今日论文合集:cs.SD语音7篇,eess.AS音频处理9篇。 cs.SD语音 【1】 Robust Knowledge Distillation from RNN-T Models With Noisy Training Labels U…
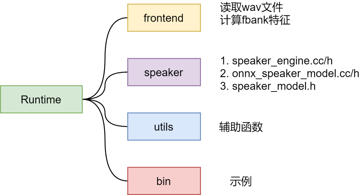
WeSpeaker正式更新C++部署链路,推理引擎使用OnnxRuntime,支持从语音中提取Speaker Embedding信息,代码详见WeSpeaker/runtime[1]。