正面硬刚GPT-4V!浙大校友开源多模态大模型LLaVA-1.5,130亿参数8个A100一天训完

GPT-4V风头正盛,LLaVA-1.5就来踢馆了!它不仅在11个基准测试上都实现了SOTA,而且13B模型的训练,只用8个A100就可以在1天内完成。 9月底,OpenAI宣布ChatGPT多模态能力解禁。多模态GPT-4V的神奇能力让众…
70 0 0

GPT-4V风头正盛,LLaVA-1.5就来踢馆了!它不仅在11个基准测试上都实现了SOTA,而且13B模型的训练,只用8个A100就可以在1天内完成。 9月底,OpenAI宣布ChatGPT多模态能力解禁。多模态GPT-4V的神奇能力让众…

LLM不实用,小模型蒸馏才是「现实」的大模型应用路线,全面领先微调技术!土豪请无视。。。 大型语言模型虽然性能优异,可以用零样本或少样本提示解决新任务,但LLM在实际应用部署时却很不实用,内存利用效率低,并且需要大量计算资源。 比如运行一个…

CFM是一种新技术,已被证明可以改进扩散模型,Meta的Voicebox模型将CFM引入语音合成领域,下面是voicebox的一个工作流程图

本次分享美国罗彻斯特大学团队提交到ICASSP 2024会议的论文《SINGFAKE: SINGING VOICE DEEPFAKE DETECTION》。该论文提出一种新的语音鉴伪任务“歌声鉴伪”。 论文地址: https://arxiv…

NeurIPS 2023说话人识别最新工作:语音解耦与自监督!由新加坡国家科技局、新国立、港理工和港中文(深圳)联合推出。 论文链接: https://arxiv.org/abs/2310.01128

本次分享上海交通大学发表在 ACL 2022 会议 的论文《Leveraging Unimodal Self-Supervised Learning for Multimodal AVSR》。该论文利用大规模单模态自监督学习构建多模态语音识…
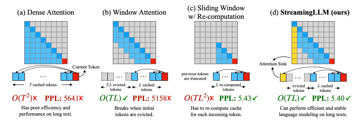
如果你体验过与任何一款对话式 AI 机器人的交流,你一定能想起某些极具「挫败感」的时刻。比如,你在前一天的对话中讲述过的要点,被 AI 忘得干干净净…… 这是因为当前的多数 LLM 只能记住有限的上下文,就像为考试而临时抱佛脚的学生,稍加盘…

今日论文合集:cs.SD语音6篇,eess.AS音频处理9篇。 cs.SD语音 【1】 Deep Generative Models of Music Expectation标题:音乐期待的深层生成模式作者:Ninon Lizé Mascl…
今日论文合集:cs.SD语音13篇,eess.AS音频处理17篇。 cs.SD语音 【1】 UniverSLU: Universal Spoken Language Understanding for Diverse Classificat…

今日论文合集:cs.SD语音4篇,eess.AS音频处理4篇。 cs.SD语音 【1】 Mel-Band RoFormer for Music Source Separation标题:用于音乐源分离的Mel-Band RoFormer作者:…